OmniHuman 1.5: expressieve sprekende portretten aangedreven door jouw stem
Bottom Line Up Front (BLUF): OmniHuman 1.5 is een AI-videogenerator die een sprekend mens bouwt op basis van één foto en één audiotrack. Wat het onderscheidt van de basistools voor lipsynchronisatie is de manier waarop het personage de toespraak bewoont: het model luistert naar het ritme en de emotie van de opname en vormt de blik, expressie en hoofdbeweging eromheen, zodat de persoon op het scherm lijkt te menen wat hij of zij zegt.
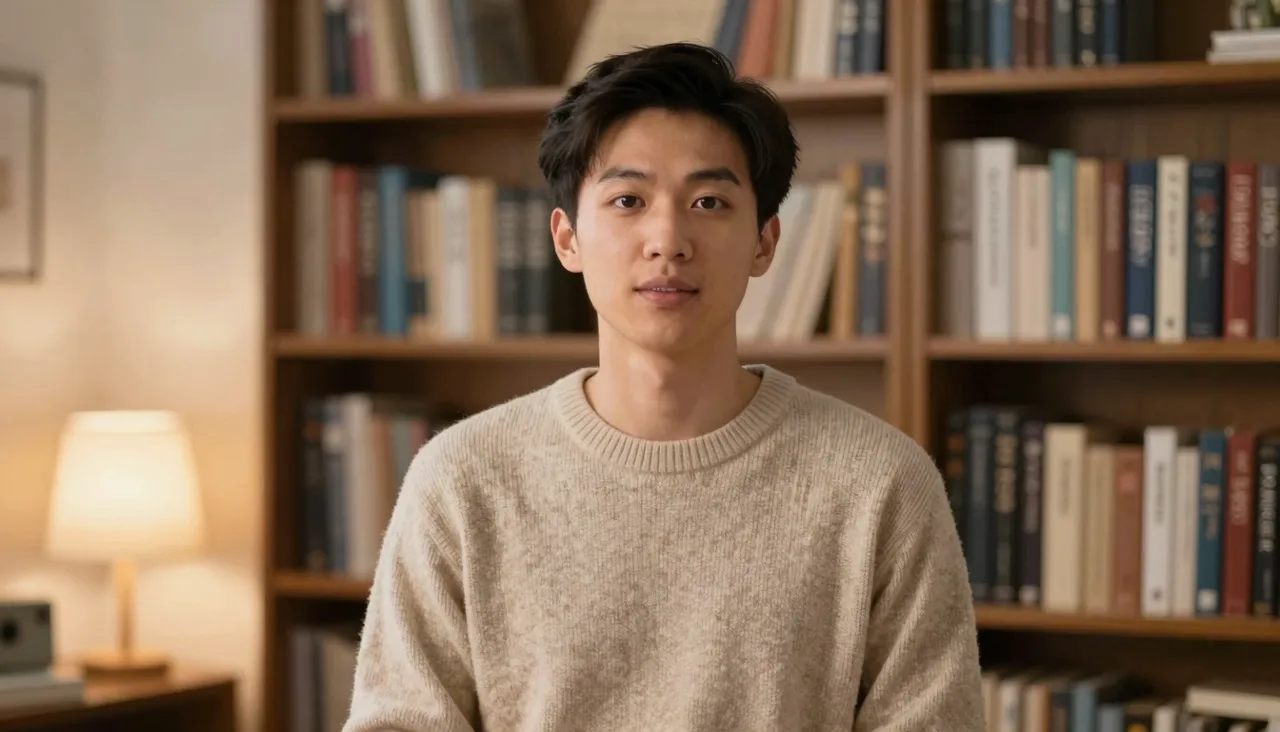
Waarom deze avatar anders voelt
De meeste pratende fototools behandelen het werk mechanisch: geluid erin, mond klappert naar buiten. OmniHuman 1.5 leest de uitvoering in de audio. Een opgewonden lijn trekt de wenkbrauwen op, een vraag verzacht de blik, een pauze laat de spreker ademen. De uitvoer neigt weg van een "geanimeerd masker" en naar iets dat lijkt op daadwerkelijke weergave op de camera.
De kloof is het meest zichtbaar op emotioneel materiaal. Elk avatarmodel kan een platte vertelling overleven, maar een oprechte felicitatie, een enthousiaste pitch of een gezongen zin is waar deze zijn naam aan verdient. Welk gevoel uw opname ook met zich meebrengt, het gezicht op het scherm pikt het op en speelt het af.
Invoer, formaten en de harde limiet
De ingrediënten zijn bekend: een portret als JPEG, PNG of WebP, en een stemtrack als MP3, WAV, AAC, OGG of M4A, elk met een maximum van 10 MB. De opname moet korter dan 15 seconden blijven - en als de jouwe overloopt, heeft het generatieformulier een eigen trimmer, dus het isoleren van het juiste fragment duurt seconden en geen bezoek aan een audio-editor.
Kies een afbeelding waarbij het gezicht en de mond duidelijk zichtbaar zijn, maar voel je niet beperkt tot portretfoto's in de studio: ook losse foto's en gestileerde kunstwerken animeren overtuigend. Voltooide video's komen terecht in je generatiegeschiedenis, waar je opnames kunt downloaden, versies kunt vergelijken of hetzelfde nummer tegen een ander portret kunt afspelen.
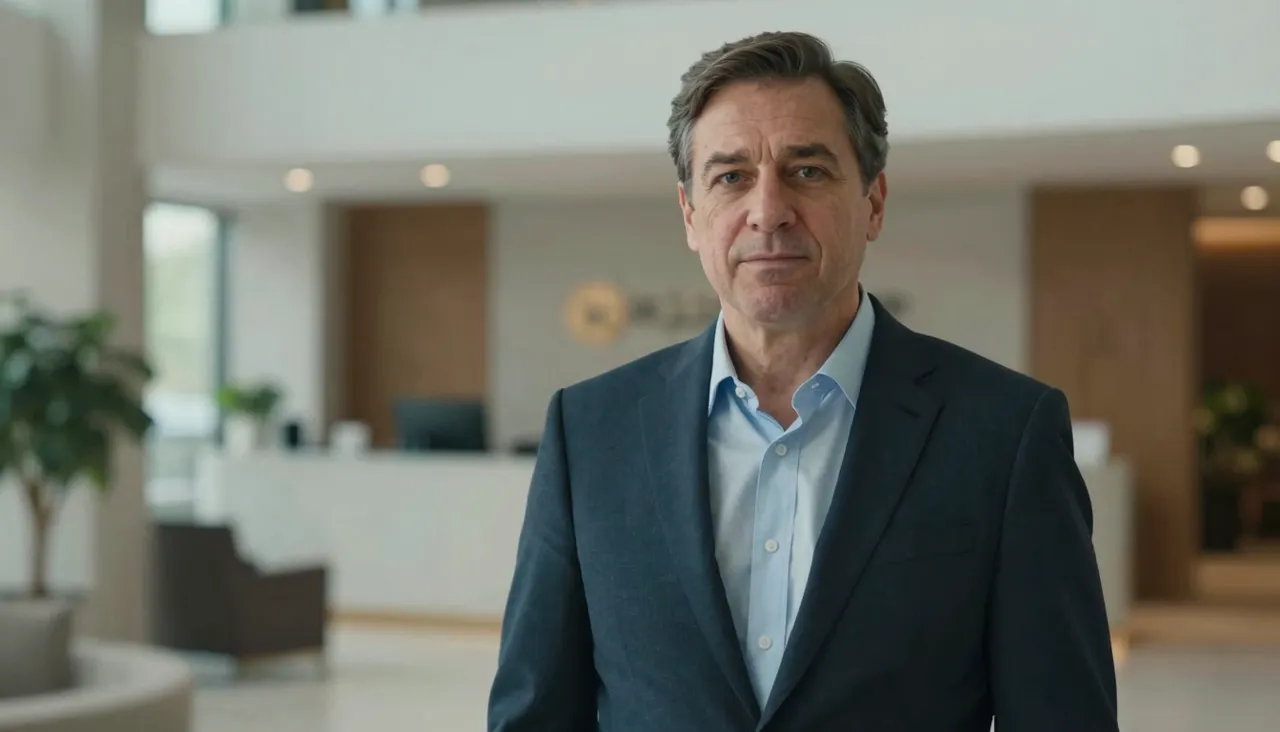
Het meest expressieve resultaat verkrijgen
De hefboom die er het meest toe doet is niet de foto, maar de opname. Voer de lijn uit zoals u dat voor de camera zou doen: echte pauzes, echte nadruk, echt gevoel. Een monotone lezing levert een monotoon karakter op, omdat het model getrouw weerspiegelt wat het hoort. Twee of drie leveringen opnemen en ze allemaal genereren is een goedkope manier om de take te vinden die zingt.
Voor het beeld geldt de regel: ademruimte. Een gezicht dat van rand tot rand is bijgesneden, laat geen ruimte voor hoofdbewegingen om zich te ontvouwen. Een omlijsting met de borst omhoog en lucht rond het hoofd geeft het model ruimte voor de kleine kantelingen en bochten die de illusie van een levend persoon overbrengen in plaats van een bewegende uitsnede.
Scenario's waarin het schittert
Reik ernaar als charisma het haalbare is. Een promo waarbij een personage de verkoop echt hypet. Een historisch portret dat zijn eigen verhaal vertelt voor een museumgids of een schoolproject. Een hoesillustratie die de openingszin van een nummer zingt. Elk van deze leeft of sterft door emotionele animatie, wat hier precies de specialiteit is.
Korte verticale video verdient een eigen vermelding: je krijgt seconden om een kijker te boeien, en een expressief menselijk gezicht verslaat de ondertiteling op het scherm bij die klus. De audiolimiet van minder dan 15 seconden komt perfect overeen met het formaat - een hookline is sowieso ongeveer zo lang.
OmniHuman of een ander hulpmiddel: een korte handleiding
Deze site biedt ook Kling AI Avatar, een aangrenzend foto-plus-audiomodel met de kwaliteitsniveaus Standaard en Pro. Ruwe vuistregel: probeer die voor een beheerste presentator in zakelijke stijl met maximale resolutie; voor levendigheid, emotie en persoonlijkheid begin je met OmniHuman 1.5. Beide hebben identieke invoer nodig, dus het doorlopen van uw bestanden en het behouden van de sterkere opname kost niets anders dan een beetje evenwicht.
Als je eigenlijke doel bestaat uit het opnieuw inspreken van bestaand beeldmateriaal in plaats van het animeren van een stilstaand beeld, is Volcengine Lip Sync het juiste hulpmiddel: het herschrijft monden in een video zodat deze overeenkomen met nieuwe audio. En voor scriptscènes met actie over het hele lichaam zijn algemene videomodellen zoals Kling 3.0 van toepassing; pratende avatars zijn specialisten in close-ups en spraak.
Veelgestelde vragen
Werkt het alleen met echte foto's?
Nee – illustraties en gestileerde portretten zijn ook voorzien van animatie, op voorwaarde dat het gezicht duidelijk leesbaar is. Het model bouwt expressie en articulatie rond de ogen en mond op, dus deze kenmerken moeten duidelijk zichtbaar zijn in het bronbeeld.
Mijn avatar kwam er stijf uit. Wat ging er mis?
Vrijwel zeker de opname. Het model weerspiegelt de energie van de stem, zodat een vlakke lezing een vlak gezicht oplevert. Neem de regel opnieuw op met echte intonatie, pauzes en accenten, en de expressiviteit van het personage stijgt mee.
Hoe maak ik iets langer dan 15 seconden?
Elke generatie heeft audio van minder dan 15 seconden nodig, dus splits een langere toespraak in stukjes, genereer elke toespraak met hetzelfde portret en voeg de clips samen in een video-editor. Bij een statische achtergrond zijn de sneden nauwelijks merkbaar.