HappyHorse Referentie-naar-video: bouw AI-videoscènes van maximaal 9 afbeeldingen
Bottom Line Up Front (BLUF): HappyHorse Reference-to-Video is een AI-videogenerator die werkt op basis van een hele reeks afbeeldingen in plaats van één enkele. Upload maximaal negen referentieafbeeldingen en beschrijf in tekst hoe ze worden gecombineerd: een personage van de ene foto, een outfit van een andere, een locatie van een derde - het model voegt ze samen tot één samenhangend fragment.
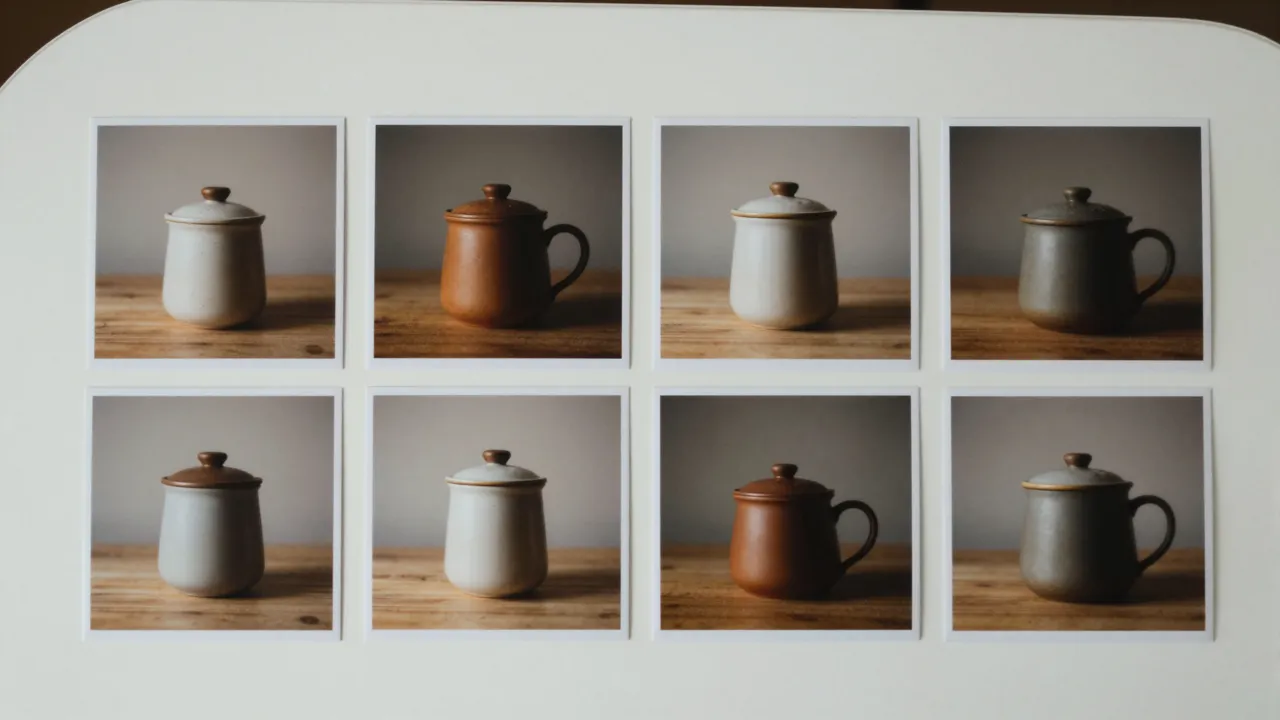
Een scène samenstellen uit meerdere foto's
Het bepalende kenmerk van deze modus is maximaal negen referenties per generatie. Elke afbeelding speelt een rol in de toekomstige clip: de held, een tweede personage, een rekwisiet, een locatie, een stijlvoorbeeld. Uw prompt legt uit wie wie is en wat er gebeurt: "de man van de eerste foto zit in het café van de derde foto en houdt de mok van de tweede vast".
Dit lost een probleem op dat gewone beeld-naar-video niet kan oplossen: dingen in één frame plaatsen die nog nooit samen zijn gefotografeerd. Een product en een model uit verschillende shoots, een personage tegen een geschilderde achtergrond, twee helden uit afzonderlijke sessies: ze komen allemaal in dezelfde scène terecht zonder enige handmatige compositie.
Hoe het model uw referenties leest
Het netwerk plakt uw foto's niet in het frame. Het bestudeert ze – het uiterlijk van het personage, de vorm van het object, het palet van de locatie – en tekent alles wat beweegt opnieuw. Daarom kan de held zich omdraaien, lopen en dingen oppakken en toch herkenbaar blijven. Hoe schoner de referentie en hoe minder rommel rond het onderwerp, hoe getrouwer de overdracht.
Help het met woorden: wijs rollen expliciet toe en beschrijf de relaties. "De vrouw uit afbeelding 1, met het jasje uit afbeelding 2 aan, loopt over straat uit afbeelding 3" werkt veel beter dan een vaag "maak een leuk filmpje van deze foto's". Je definieert de casting; het model hoeft de scène alleen maar tot leven te brengen.
Frameformaten van verhalen tot breedbeeld
In tegenstelling tot de modus voor één foto kunt u hier kiezen voor de beeldverhouding: breedbeeld 16:9, verticaal 9:16 en 3:4, vierkant 1:1 en klassiek 4:3. Dezelfde referentieset kan een verticale verhaalclip en een brede bannervideo voor een website worden. U hoeft alleen maar het formaat te wijzigen en opnieuw uit te voeren.
De duur varieert van 3 tot 15 seconden, met 720p of 1080p uitvoer. Goedkope korte concepten bij 720p zijn perfect voor het verkennen van ideeën; bewaar de langere 1080p render voor de definitieve versie. Met het zaadveld kunt u een compositie vergrendelen die u leuk vindt en alleen de bewoording variëren.
Gebruiksscenario's: advertenties, terugkerende personages, catalogi
Het meest lonende scenario zijn videoseries met een volhardend karakter: een merkmascotte, een stripheld, een virtuele presentator. Voer dezelfde karakterafbeeldingen in elke generatie in en je krijgt een reeks clips waarin de held dezelfde blijft. Voor winkels is het een manier om een product ‘in het echt’ te laten zien door de foto te koppelen aan een interieurfoto.
Het schittert ook in creatief werk: bouw een sprookjesachtige scène uit de tekening van een kind plus zijn foto, laat een huisdier in een geïllustreerde wereld vallen, combineer een kostuumschets met een echt model. Alles waarvoor vroeger collages en handmatig retoucheren nodig waren, gebeurt in één generatie.
Een referentieset kiezen die werkt
Haast je niet om alle negen slots te vullen. Hoe meer afbeeldingen u toevoegt, hoe moeilijker het voor het model is om te beslissen wat belangrijk is. Begin met twee of drie belangrijke referenties (held, object, achtergrond) en voeg er alleen meer toe als de clip duidelijk een specifiek detail mist. Elk extra beeld verdunt de aandacht van het netwerk.
Let op compatibiliteit: een personage dat bij daglicht is gefotografeerd tegen een neon-nachtstraat dwingt het model tot improvisatie en de naden beginnen zichtbaar te worden. Referenties met vergelijkbare belichting en een dichtbij kleurbereik zorgen voor een uniform beeld dat er vanaf het eerste frame geloofwaardig uitziet.
Veelgestelde vragen
Hoeveel referentieafbeeldingen kan ik uploaden?
Van één tot negen per generatie. Twee of drie belangrijke referenties – held, rekwisiet, achtergrond – zijn het beste startpunt. Voeg alleen meer toe als u precies weet voor welk detail van de scène elke nieuwe afbeelding verantwoordelijk is.
Blijft de persoon uit mijn referentie herkenbaar?
Het model werkt hard om de identiteit te behouden en meestal is de gelijkenis goed, maar dit is een nieuwe generatie, geen kopie van de foto. Een scherp close-upportret zonder andere mensen in beeld, plus een expliciete instructie om het uiterlijk te behouden, verbetert de match.
Hoe verschilt dit van gewone beeld-naar-video?
Normale beeld-naar-video animeert één foto en behoudt de compositie. Hier breng je verschillende bronafbeeldingen mee en het model bouwt een gloednieuwe scène op basis van jouw beschrijving. Kies deze modus als de exacte opname die u nodig heeft eenvoudigweg niet bestaat.