OmniHuman 1.5: あなたの声によって動かされる表情豊かな話すポートレート
Bottom Line Up Front (BLUF): OmniHuman 1.5 は、1 枚の写真と 1 つのオーディオ トラックから話す人間を構築する AI ビデオ ジェネレーターです。基本的な口パク ツールとの違いは、登場人物がスピーチにどのように反映されるかです。モデルは録音のリズムと感情を聞き、その周りの視線、表情、頭の動きを形作るので、画面上の人物は彼らが言っていることが意図しているように見えます。
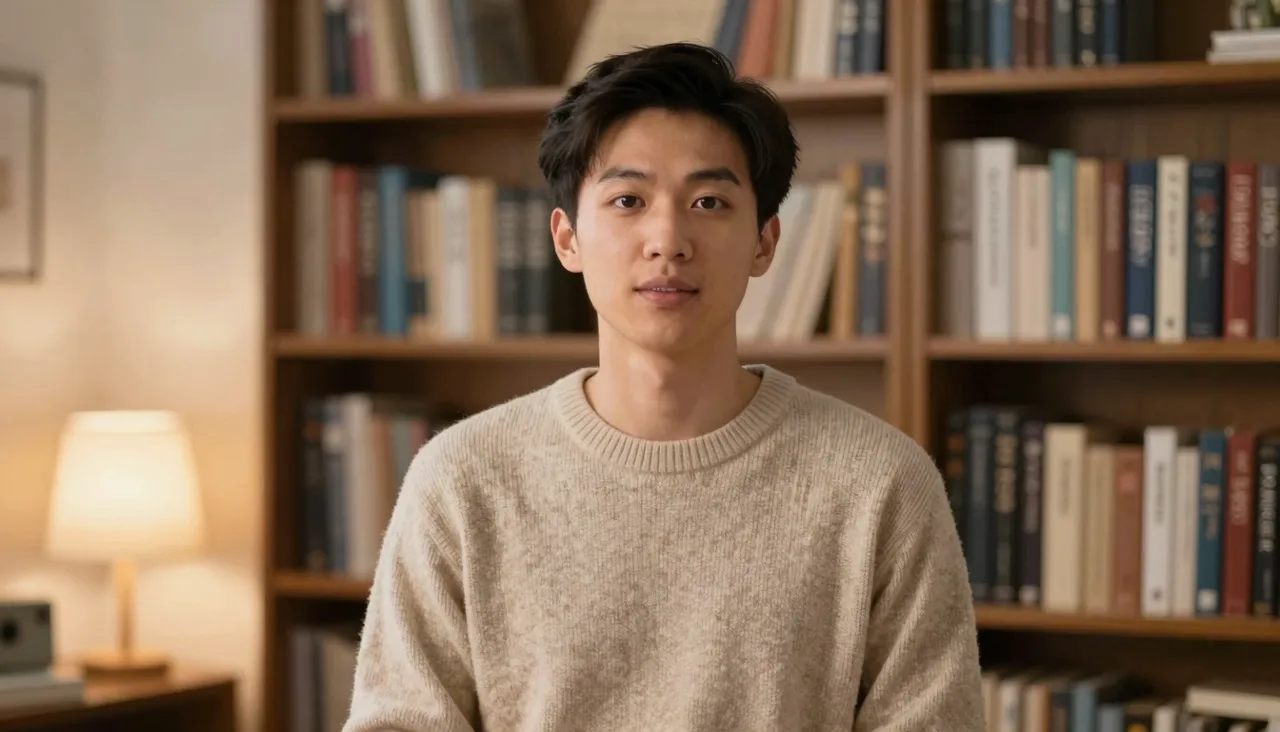
このアバターが違うと感じる理由
ほとんどのしゃべる写真ツールは、音声を入力し、口をパタパタと動かすなど、仕事を機械的に処理します。 OmniHuman 1.5 はオーディオ内のパフォーマンスを読み取ります。興奮したセリフは眉を上げ、質問は視線を和らげ、沈黙は話し手を呼吸させます。出力は、「アニメーション化されたマスク」から離れて、実際のカメラでの配信に似たものに傾いています。
ギャップは感情的な素材に最もよく現れます。どのアバター モデルも単調なナレーションに耐えることができますが、心からの祝福、熱狂的なピッチ、歌のセリフがこのアバター モデルの名前の由来です。録音したものがどんな感情を持っていても、画面上の顔がそれを拾い上げて再生します。
入力、フォーマット、およびハードリミット
構成要素はよく知られています。ポートレートは JPEG、PNG、または WebP、音声トラックは MP3、WAV、AAC、OGG、または M4A で、それぞれの上限は 10 MB です。録音は 15 秒以内でなければなりません。録音が超過した場合でも、生成フォームには独自のトリマーがあるため、オーディオ エディターにアクセスする必要はなく、数秒で適切なフラグメントを分離できます。
顔と口がはっきりと見える画像を選択してください。ただし、スタジオでの顔写真に限定される必要はありません。カジュアルな写真や様式化されたアートワークも説得力を持ってアニメーション化されます。完成したビデオは生成履歴に保存され、そこでテイクをダウンロードしたり、バージョンを比較したり、同じトラックを別のポートレートに対して実行したりできます。
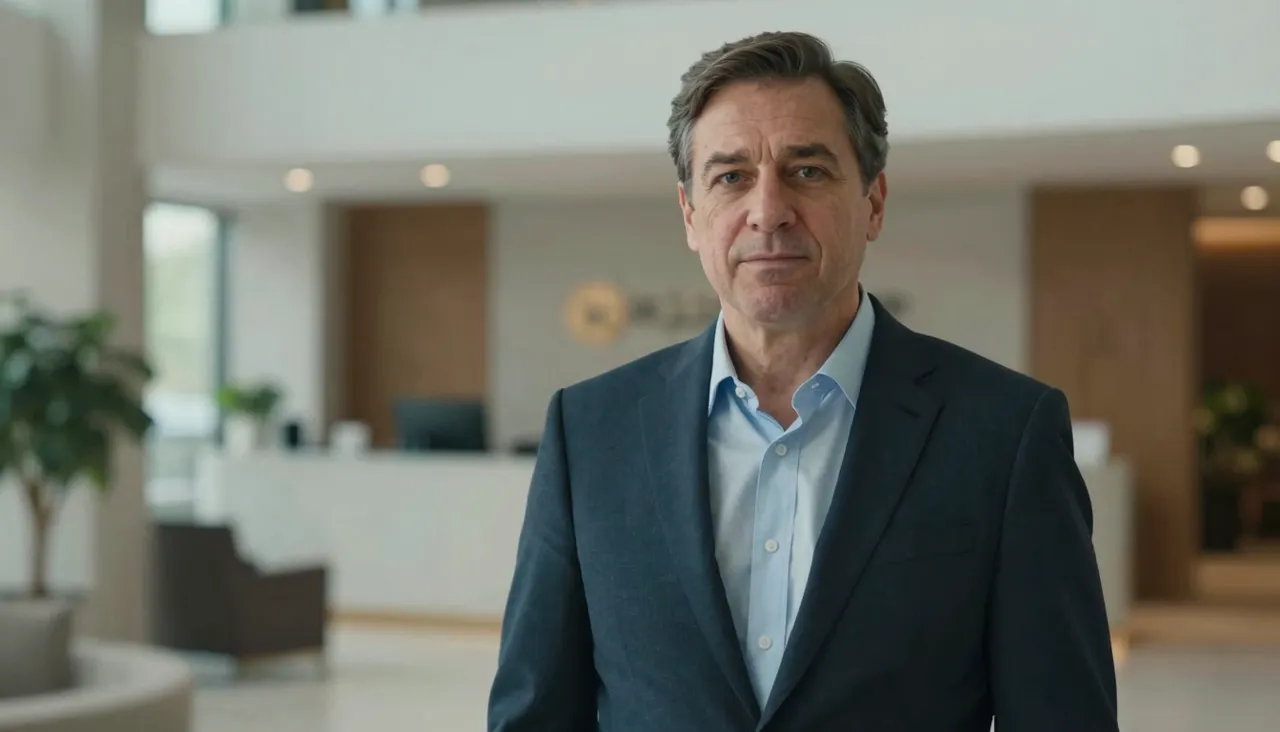
最も表現力豊かな結果を得る
最も重要なのは写真ではなく、記録です。カメラの前で行うのと同じようにセリフを実行します。実際に一時停止し、実際に強調し、実際の感情を表現します。モデルは聞いたものを忠実に反映するため、単調な読み取りでは単調な文字が生成されます。 2 つまたは 3 つの配信を録音し、すべてを生成することは、歌っているテイクを見つける安価な方法です。
イメージとしては、余裕を持って呼吸するのがルールです。端から端まで切り取られた顔には、頭の動きが展開するスペースがありません。頭の周りに空気を入れた胸を上げたフレーミングは、モデルに小さな傾きや回転のためのスペースを与え、動く切り抜きではなく生きている人間のような錯覚を売りにします。
それが輝くシナリオ
カリスマ性が成果物である場合は、それに手を伸ばしてください。キャラクターが本気でセールを宣伝するプロモーション。博物館ガイドや学校のプロジェクト向けに、独自のストーリーを語る歴史的肖像画。トラックの冒頭部分を歌っているジャケットイラスト。これらのそれぞれは、感情的なアニメーションに生きるか死ぬかであり、それがまさにここの専門分野です。
短い縦型ビデオは特筆に値します。数秒で視聴者を魅了し、表情豊かな人間の顔が画面上のキャプションを上回ります。 15 秒未満の音声制限はたまたまこの形式に完全に一致しており、フック ラインはとにかくそれくらいの長さです。
OmniHuman または別のツール: クイックガイド
このサイトでは、標準およびプロ品質レベルの隣接する写真とオーディオのモデルである Kling AI アバターも提供しています。大まかな経験則: 最大の解像度で、落ち着いた企業スタイルのプレゼンターの場合は、それを試してください。活気、感情、個性については、OmniHuman 1.5 から始めてください。どちらも同じ入力を受け取るため、それぞれを介してファイルを実行し、より強力なテイクを維持するには、わずかなバランスを取るだけで問題はありません。
実際の目標が、静止画をアニメーション化するのではなく、既存の映像をリボイスすることである場合は、Volcengine リップ シンクが適切なツールです。新しいオーディオに合わせてビデオ内の口を書き換えます。また、全身アクションを含むスクリプト シーンの場合は、Kling 3.0 のような一般的なビデオ モデルが適用されます。話すアバターは、クローズアップと音声のスペシャリストです。
Frequently asked questions
実際の写真でのみ機能しますか?
いいえ、顔がはっきりと読み取れる場合には、イラストや様式化されたポートレートも同様にアニメーション化されます。モデルは目と口の周囲の表情と表現を構築するため、これらの特徴はソース画像内で明確である必要があります。
私のアバターは硬くなってしまいました。何が間違っていたのでしょうか?
ほぼ間違いなく録音です。モデルは声のエネルギーを反映しているため、平らに読み取ると平らな顔が得られます。セリフを本物のイントネーション、間、強調で再録音すると、キャラクターの表現力が高まります。
15 秒を超えるものを作成するにはどうすればよいですか?
各世代には 15 秒以内の音声が必要なので、長いスピーチをいくつかのチャンクに分割し、それぞれを同じポートレートで生成し、ビデオ エディターでクリップを結合します。静止した背景では、カットはほとんど目立ちません。