OmniHuman 1.5: retratos falantes expressivos conduzidos pela sua voz
Bottom Line Up Front (BLUF): OmniHuman 1.5 é um gerador de vídeo de IA que constrói um ser humano falante a partir de uma foto e uma trilha de áudio. O que o diferencia das ferramentas básicas de sincronização labial é a forma como o personagem habita a fala: o modelo ouve o ritmo e a emoção da gravação e molda o olhar, a expressão e o movimento da cabeça em torno dela, de modo que a pessoa na tela pareça querer dizer o que diz.
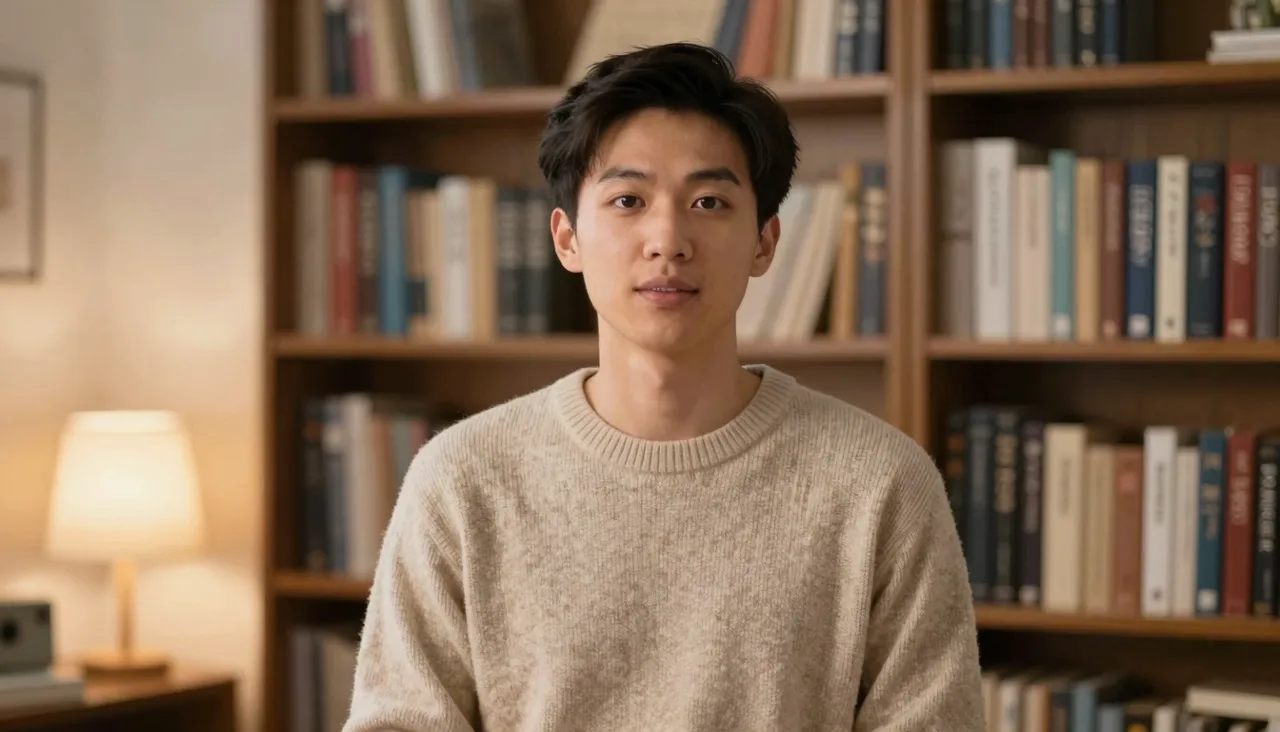
Por que esse avatar parece diferente
A maioria das ferramentas de fotografia falada trata o trabalho mecanicamente – o som entra e a boca sai. OmniHuman 1.5 lê a performance dentro do áudio. Uma linha animada levanta as sobrancelhas, uma pergunta suaviza o olhar, uma pausa deixa o orador respirar. A saída se afasta da “máscara animada” e se aproxima de algo que se assemelha à entrega real na câmera.
A lacuna é mais evidente no material emocional. Qualquer modelo de avatar pode sobreviver a uma narração plana, mas um parabéns sincero, um discurso entusiasmado ou uma frase cantada é onde este ganha o seu nome. Qualquer que seja a sensação que sua gravação transmita, o rosto na tela a capta e a reproduz.
Entradas, formatos e limite rígido
Os ingredientes são familiares: um retrato como JPEG, PNG ou WebP, e uma faixa de voz como MP3, WAV, AAC, OGG ou M4A, cada uma com limite de 10 MB. A gravação deve durar menos de 15 segundos - e se a sua ultrapassar o limite, o formulário de geração tem seu próprio aparador, portanto, isolar o fragmento certo leva segundos, e não uma ida a um editor de áudio.
Escolha uma imagem onde o rosto e a boca sejam claramente visíveis, mas não se sinta restrito a fotos de estúdio: fotos casuais e obras de arte estilizadas também são animadas de forma convincente. Os vídeos finalizados chegam ao histórico de sua geração, onde você pode baixar tomadas, comparar versões ou reproduzir a mesma faixa em um retrato diferente.
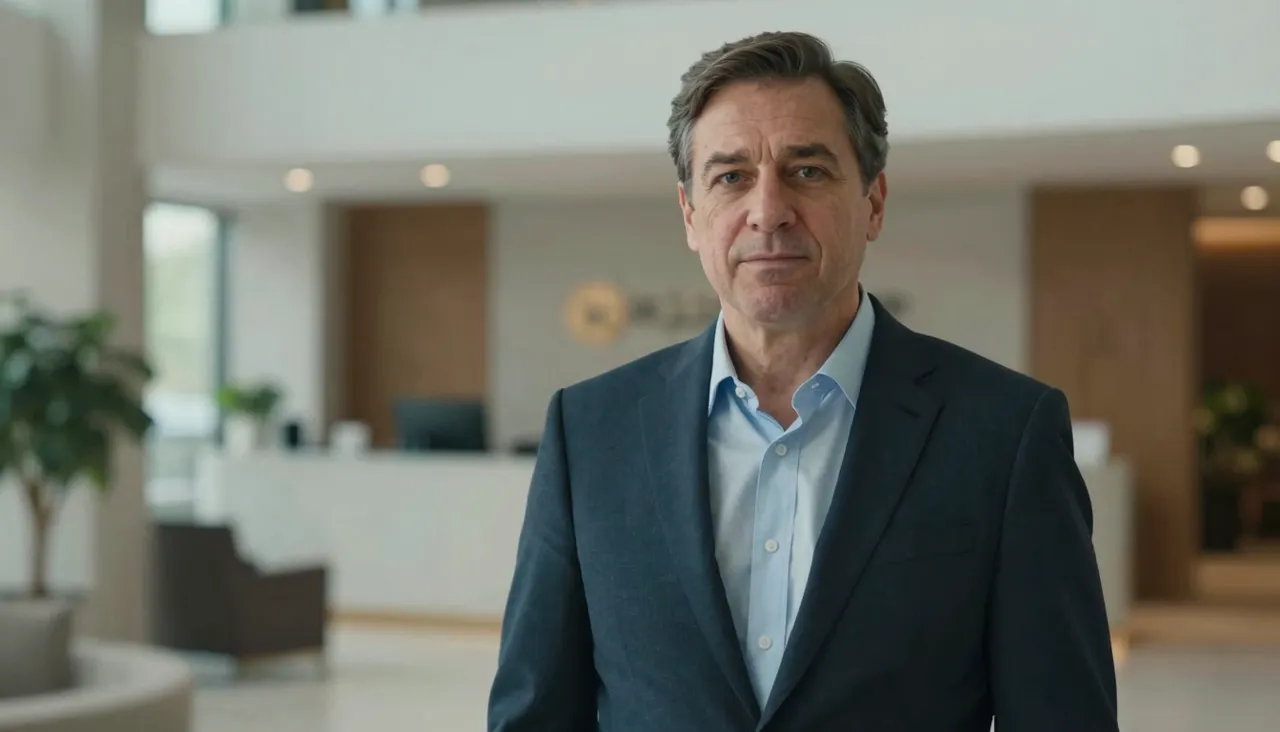
Obtendo o resultado mais expressivo
A alavanca que mais importa não é a foto – é a gravação. Execute a fala da mesma forma que faria diante da câmera: pausas reais, ênfase real, sentimento real. Uma leitura monótona produz um caráter monótono, porque o modelo reflete fielmente o que ouve. Gravar duas ou três entregas e gerar todas elas é uma forma barata de encontrar o take que canta.
Para a imagem, a regra é respirar. Um rosto cortado de ponta a ponta não deixa espaço para o movimento da cabeça se desenrolar. Uma moldura de peito para cima com ar ao redor da cabeça dá ao modelo espaço para pequenas inclinações e giros que vendem a ilusão de uma pessoa viva em vez de um recorte em movimento.
Cenários onde brilha
Alcance-o quando o carisma for o produto final. Uma promoção em que um personagem genuinamente exalta a venda. Um retrato histórico narrando sua própria história para um guia de museu ou um projeto escolar. Uma ilustração da capa cantando a linha de abertura de uma faixa. Cada um deles vive ou morre de animação emocional, que é exatamente a especialidade aqui.
O vídeo vertical curto merece sua própria menção: você tem segundos para prender o espectador, e um rosto humano expressivo supera as legendas na tela nesse trabalho. O limite de áudio inferior a 15 segundos corresponde perfeitamente ao formato - de qualquer maneira, uma linha de gancho tem esse comprimento.
OmniHuman ou outra ferramenta: um guia rápido
Este site também oferece Kling AI Avatar, um modelo vizinho de foto e áudio com níveis de qualidade Standard e Pro. Regra geral: para um apresentador composto e de estilo corporativo com resolução máxima, tente essa; para vivacidade, emoção e personalidade, comece com OmniHuman 1.5. Ambos recebem entradas idênticas, portanto, executar seus arquivos em cada um e manter a tomada mais forte não custa nada além de um pouco de equilíbrio.
Se o seu objetivo real é dar voz a uma filmagem existente em vez de animar uma imagem estática, Volcengine Lip Sync é a ferramenta certa — ele reescreve bocas em um vídeo para corresponder ao novo áudio. E para cenas roteirizadas com ação de corpo inteiro, modelos de vídeo gerais como Kling 3.0 se aplicam; avatares falantes são especialistas em close-ups e fala.
Frequently asked questions
Só funciona com fotografias reais?
Não – ilustrações e retratos estilizados também são animados, desde que o rosto seja claramente legível. O modelo cria expressão e articulação ao redor dos olhos e da boca, portanto, essas características precisam ser distintas na imagem de origem.
Meu avatar ficou rígido. O que deu errado?
Quase certamente a gravação. O modelo reflete a energia da voz, de modo que uma leitura plana produz uma face plana. Regrave a linha com entonação, pausas e ênfase genuínas, e a expressividade do personagem aumenta com ela.
Como faço algo com mais de 15 segundos?
Cada geração precisa de áudio com menos de 15 segundos, então divida um discurso mais longo em partes, gere cada uma com o mesmo retrato e junte os clipes em qualquer editor de vídeo. Com um fundo estático, os cortes são quase imperceptíveis.