OmniHuman 1.5 : des portraits parlants expressifs animés par votre voix
Bottom Line Up Front (BLUF): OmniHuman 1.5 est un générateur vidéo IA qui construit un humain parlant à partir d'une photo et d'une piste audio. Ce qui le distingue des outils de synchronisation labiale de base est la façon dont le personnage habite le discours : le modèle écoute le rythme et l'émotion de l'enregistrement et façonne le regard, l'expression et les mouvements de la tête autour de lui, de sorte que la personne à l'écran semble penser ce qu'elle dit.
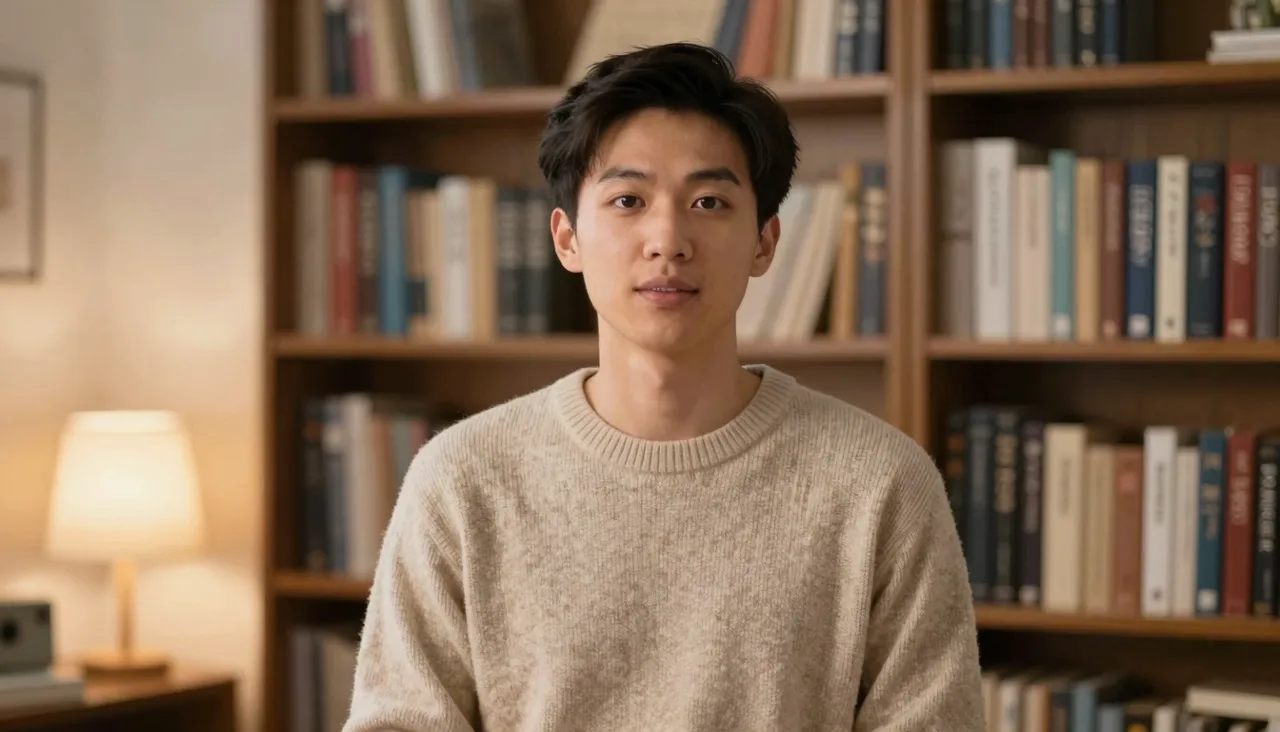
Pourquoi cet avatar est différent
La plupart des outils de photo parlante traitent le travail de manière mécanique : le son entre, la bouche sort. OmniHuman 1.5 lit la performance à l'intérieur de l'audio. Une ligne excitée soulève les sourcils, une question adoucit le regard, une pause laisse respirer celui qui parle. La sortie s'éloigne du "masque animé" et se rapproche de quelque chose qui ressemble à une véritable diffusion devant la caméra.
L’écart se manifeste le plus sur le matériel émotionnel. N'importe quel modèle d'avatar peut survivre à une narration plate, mais c'est dans une félicitation sincère, un discours enthousiaste ou une réplique chantée que celui-ci mérite son nom. Quelle que soit la sensation ressentie par votre enregistrement, le visage à l'écran le capte et le lit.
Entrées, formats et limite stricte
Les ingrédients sont familiers : un portrait au format JPEG, PNG ou WebP, et une piste vocale au format MP3, WAV, AAC, OGG ou M4A, chacun plafonné à 10 MB. L'enregistrement doit rester inférieur à 15 secondes - et si le vôtre est dépassé, le formulaire de génération possède son propre découpage, donc isoler le bon fragment prend quelques secondes, pas un déplacement vers un éditeur audio.
Choisissez une image où le visage et la bouche sont clairement visibles, mais ne vous limitez pas aux photos à la tête en studio : des photos informelles et des illustrations stylisées s'animent également de manière convaincante. Les vidéos terminées atterrissent dans votre historique de génération, où vous pouvez télécharger des prises, comparer les versions ou exécuter la même piste sur un portrait différent.
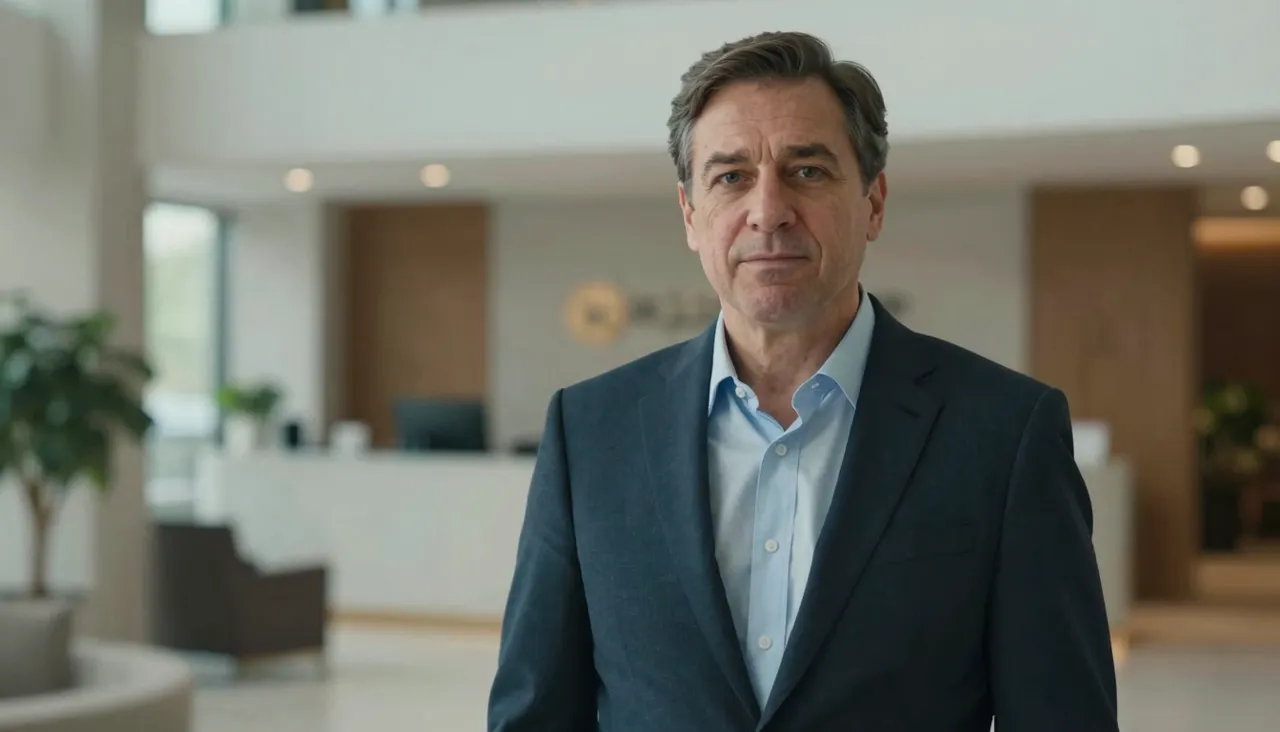
Obtenir le résultat le plus expressif
Le levier qui compte le plus n’est pas la photo, c’est l’enregistrement. Interprétez la réplique comme vous le feriez devant la caméra : de vraies pauses, une vraie emphase, une vraie sensation. Une lecture monotone produit un caractère monotone, car le modèle reflète fidèlement ce qu'il entend. Enregistrer deux ou trois livraisons et les générer toutes est un moyen peu coûteux de trouver la prise qui chante.
Pour l’image, la règle est de respirer. Un visage coupé bord à bord ne laisse aucun espace pour que le mouvement de la tête se déroule. Un cadrage de poitrine avec de l'air autour de la tête donne au modèle de la place pour les petites inclinaisons et rotations qui vendent l'illusion d'une personne vivante plutôt que d'une découpe en mouvement.
Scénarios où ça brille
Atteignez-le lorsque le charisme est le livrable. Une promo où un personnage fait véritablement la promotion de la vente. Un portrait historique racontant sa propre histoire pour un guide de musée ou un projet scolaire. Une illustration de pochette chantant la première ligne d’un morceau. Chacun d’eux vit ou meurt grâce à l’animation émotionnelle, ce qui est exactement la spécialité ici.
Une courte vidéo verticale mérite sa propre mention : vous disposez de quelques secondes pour accrocher un spectateur, et un visage humain expressif bat les sous-titres à l'écran pour ce travail. La limite audio de moins de 15 secondes correspond parfaitement au format – une ligne d’accroche est de toute façon à peu près aussi longue.
OmniHuman ou un autre outil : un guide rapide
Ce site propose également Kling AI Avatar, un modèle photo et audio voisin avec des niveaux de qualité Standard et Pro. Règle générale : pour un présentateur composé de style entreprise avec une résolution maximale, essayez celui-là ; pour la vivacité, l'émotion et la personnalité, commencez par OmniHuman 1.5. Les deux prennent des entrées identiques, donc exécuter vos fichiers dans chacun d'eux et conserver la prise la plus forte ne coûte rien d'autre qu'un peu d'équilibre.
Si votre objectif réel est de rééditer des séquences existantes plutôt que d'animer une image fixe, Volcengine Lip Sync est le bon outil : il réécrit les bouches dans une vidéo pour correspondre au nouvel audio. Et pour les scènes scriptées avec une action sur tout le corps, des modèles vidéo généraux tels que Kling 3.0 s'appliquent ; les avatars parlants sont des spécialistes des gros plans et de la parole.
Questions fréquentes
Est-ce que ça ne fonctionne qu'avec de vraies photographies ?
Non, les illustrations et les portraits stylisés sont également animés, à condition que le visage soit clairement lisible. Le modèle construit l'expression et l'articulation autour des yeux et de la bouche, ces caractéristiques doivent donc être distinctes dans l'image source.
Mon avatar est sorti raide. Qu'est-ce qui n'a pas fonctionné ?
Presque certainement l'enregistrement. Le modèle reflète l'énergie de la voix, donc une lecture plate donne un visage plat. Réenregistrez la ligne avec une intonation, des pauses et une emphase authentiques, et l'expressivité du personnage augmente avec elle.
Comment faire quelque chose de plus de 15 secondes ?
Chaque génération a besoin d'un son de moins de 15 secondes, alors divisez un discours plus long en morceaux, générez chacun avec le même portrait et joignez les clips dans n'importe quel éditeur vidéo. Avec un fond statique, les coupures sont à peine perceptibles.