OmniHuman 1.5: ekspresyjne mówiące portrety sterowane Twoim głosem
Bottom Line Up Front (BLUF): OmniHuman 1.5 to generator wideo AI, który buduje mówiącego człowieka z jednego zdjęcia i jednej ścieżki dźwiękowej. Tym, co odróżnia je od podstawowych narzędzi do synchronizacji ruchu warg, jest sposób, w jaki postać reaguje na mowę: modelka słucha rytmu i emocji nagrania oraz kształtuje wokół niego spojrzenie, ekspresję i ruchy głowy, dzięki czemu osoba na ekranie wydaje się mieć na myśli to, co mówi.
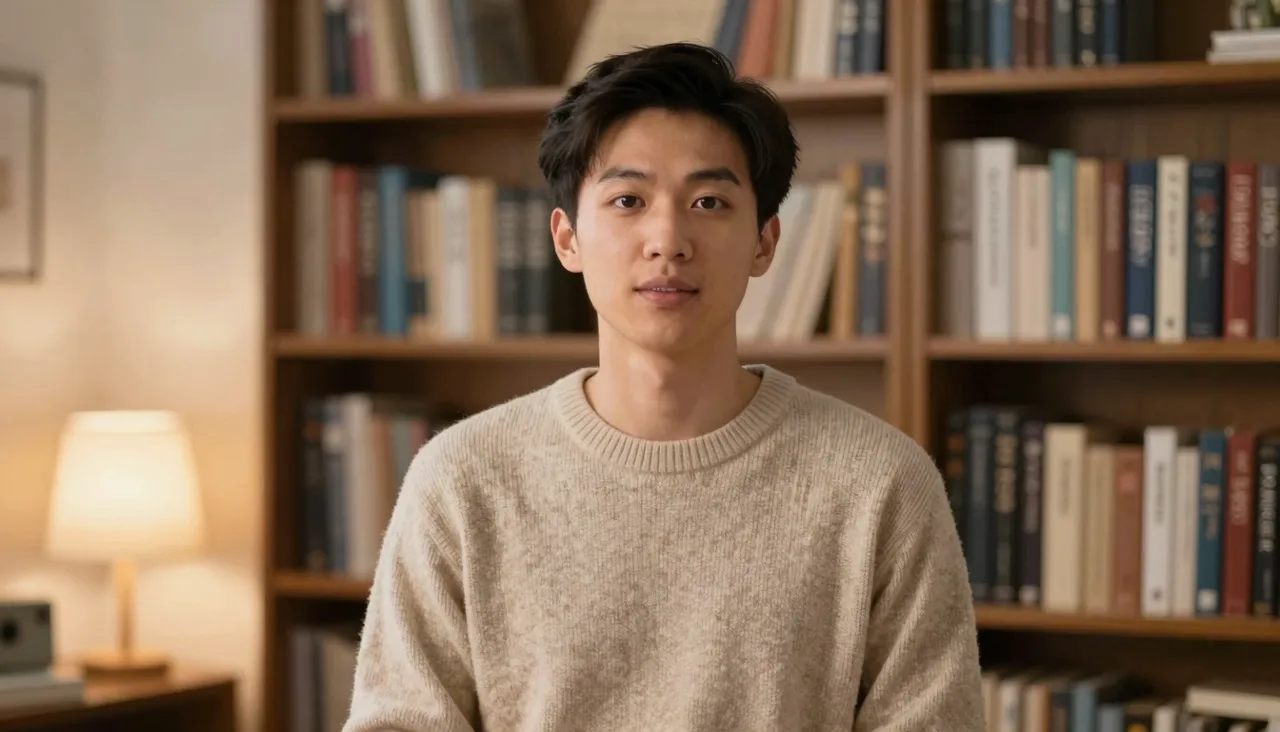
Dlaczego ten awatar wydaje się inny
Większość narzędzi do mówienia i fotografowania traktuje tę pracę mechanicznie — wsłuchuj się w dźwięk, wysuwaj usta. OmniHuman 1.5 odczytuje wykonanie z nagrania. Podekscytowana linia unosi brwi, pytanie łagodzi spojrzenie, pauza pozwala mówiącemu odetchnąć. Efekt końcowy odchodzi od „animowanej maski” w stronę czegoś przypominającego rzeczywisty obraz wyświetlany przed kamerą.
Różnica jest najbardziej widoczna w materiale emocjonalnym. Każdy model awatara może przetrwać płaską narrację, ale szczere gratulacje, entuzjastyczny ton lub zaśpiewana linijka są tym, czym ten model zasługuje na swoją nazwę. Niezależnie od emocji, jakie niesie ze sobą Twoje nagranie, twarz na ekranie odbiera je i odtwarza.
Wejścia, formaty i twardy limit
Składniki są znane: portret w formacie JPEG, PNG lub WebP oraz ścieżka głosowa w formacie MP3, WAV, AAC, OGG lub M4A, każdy z ograniczeniem do 10 MB. Nagranie musi trwać krócej niż 15 sekund — a jeśli Twoje się skończy, formularz generowania ma własny trymer, więc wyizolowanie odpowiedniego fragmentu zajmie kilka sekund, a nie podróż do edytora audio.
Wybierz zdjęcie, na którym twarz i usta są wyraźnie widoczne, ale nie ograniczaj się do zdjęć studyjnych: zwykłe zdjęcia i stylizowane grafiki również przekonują. Gotowe filmy trafiają do historii generacji, skąd możesz pobrać ujęcia, porównać wersje lub odtworzyć ten sam utwór w innym ujęciu.
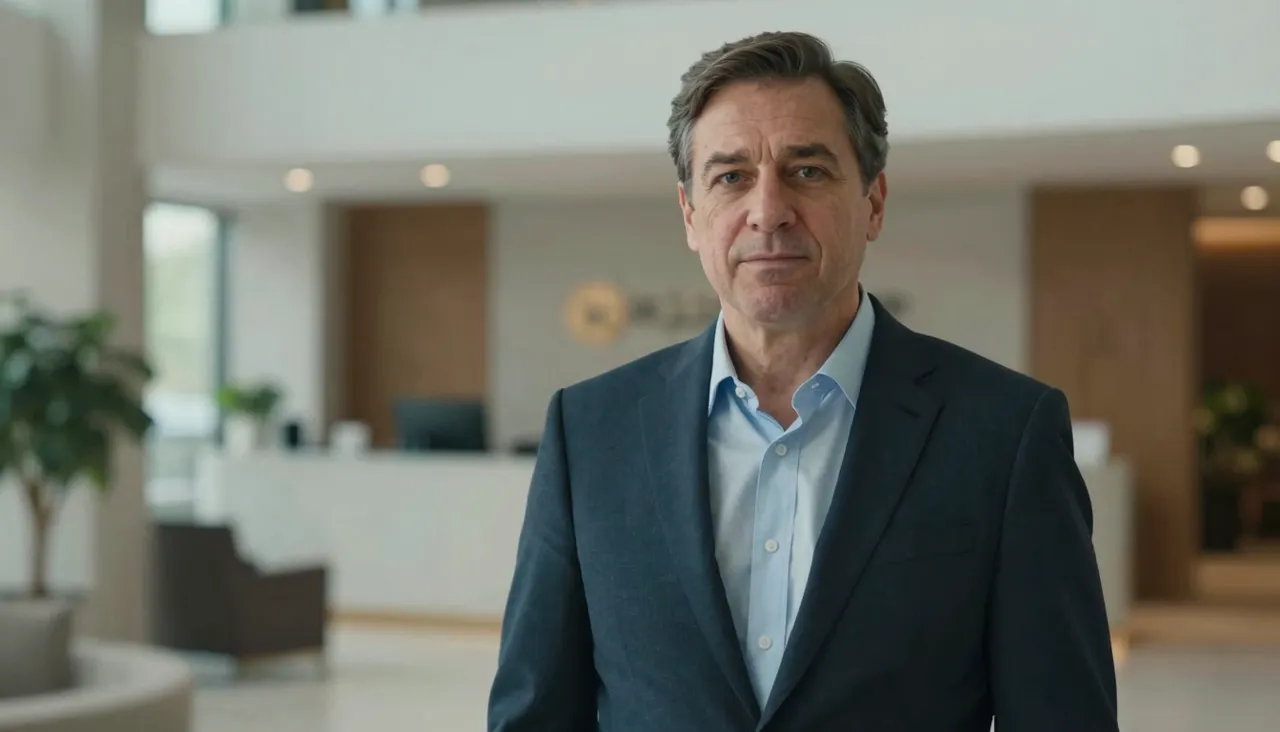
Uzyskanie najbardziej wyrazistego rezultatu
Najważniejszą dźwignią nie jest zdjęcie, ale nagranie. Wykonuj linię tak, jak przed kamerą: prawdziwe pauzy, prawdziwe podkreślenie, prawdziwe uczucie. Odczyt monotonny wytwarza charakter monotonny, ponieważ model wiernie odzwierciedla to, co słyszy. Nagranie dwóch lub trzech dostaw i wygenerowanie ich wszystkich to tani sposób na znalezienie odpowiedniego ujęcia.
W przypadku obrazu zasadą jest oddech. Twarz przycięta od krawędzi do krawędzi nie pozostawia miejsca na ruch głowy. Ramka uniesiona do góry, z powietrzem wokół głowy, daje modelce miejsce na niewielkie przechyły i obroty, które sprzedają iluzję żywej osoby, a nie ruchome wycięcie.
Scenariusze, w których błyszczy
Sięgnij po to, gdy charyzma jest możliwa do dostarczenia. Promocja, w której postać naprawdę promuje wyprzedaż. Portret historyczny opowiadający własną historię na potrzeby przewodnika muzealnego lub projektu szkolnego. Ilustracja na okładce ze śpiewem początkowej linijki utworu. Każdy z nich żyje lub umiera w emocjonalnej animacji, co jest właśnie tutaj specjalnością.
Krótki film w pionie zasługuje na osobną wzmiankę: masz sekundy, aby przyciągnąć widza, a wyrazista ludzka twarz bije w tym zadaniu napisy na ekranie. Limit dźwięku poniżej 15 sekund idealnie pasuje do formatu – linia zaczepienia i tak jest mniej więcej tak długa.
OmniHuman lub inne narzędzie: krótki przewodnik
Na tej stronie dostępny jest także awatar AI Kling, sąsiadujący model ze zdjęciami i dźwiękiem w poziomach jakości Standard i Pro. Ogólna zasada: dla opanowanego prezentera w stylu korporacyjnym przy maksymalnej rozdzielczości wypróbuj tę; jeśli chodzi o żywotność, emocje i osobowość, zacznij od OmniHuman 1.5. Obydwa wymagają identycznych danych wejściowych, więc przepuszczanie plików przez każdy z nich i utrzymywanie silniejszego ujęcia kosztuje nic poza odrobiną równowagi.
Jeśli Twoim prawdziwym celem jest ponowne udźwiękowienie istniejącego materiału filmowego, a nie animacja nieruchomego materiału, Volcengine Lip Sync jest właściwym narzędziem — przepisuje usta w filmie, aby dopasować je do nowego dźwięku. W przypadku scen scenariuszowych z akcją obejmującą całe ciało obowiązują ogólne modele wideo, takie jak Kling 3.0; mówiące awatary są specjalistami od zbliżeń i mowy.
Częste pytania
Czy działa to tylko z prawdziwymi zdjęciami?
Nie — ilustracje i stylizowane portrety również są animowane, pod warunkiem, że twarz jest wyraźnie czytelna. Model buduje ekspresję i artykulację wokół oczu i ust, więc te cechy muszą być wyraźne na obrazie źródłowym.
Mój awatar wyszedł sztywny. Co poszło nie tak?
Prawie na pewno nagranie. Model odzwierciedla energię głosu, więc płaski odczyt daje płaską twarz. Nagraj ponownie wers z prawdziwą intonacją, pauzami i akcentami, a ekspresja postaci wzrośnie wraz z nią.
Jak zrobić coś dłuższego niż 15 sekund?
Każde pokolenie potrzebuje dźwięku trwającego krócej niż 15 sekund, dlatego podziel dłuższe przemówienie na fragmenty, wygeneruj każdy z tym samym portretem i połącz klipy w dowolnym edytorze wideo. Na statycznym tle nacięcia są ledwo zauważalne.