OmniHuman 1.5: retratos parlantes expresivos impulsados por tu voz
Bottom Line Up Front (BLUF): OmniHuman 1.5 es un generador de video con IA que crea un ser humano que habla a partir de una foto y una pista de audio. Lo que lo distingue de las herramientas básicas de sincronización de labios es cómo el personaje habita el discurso: el modelo escucha el ritmo y la emoción de la grabación y da forma a la mirada, la expresión y el movimiento de la cabeza a su alrededor, de modo que la persona en la pantalla parece querer decir lo que dice.
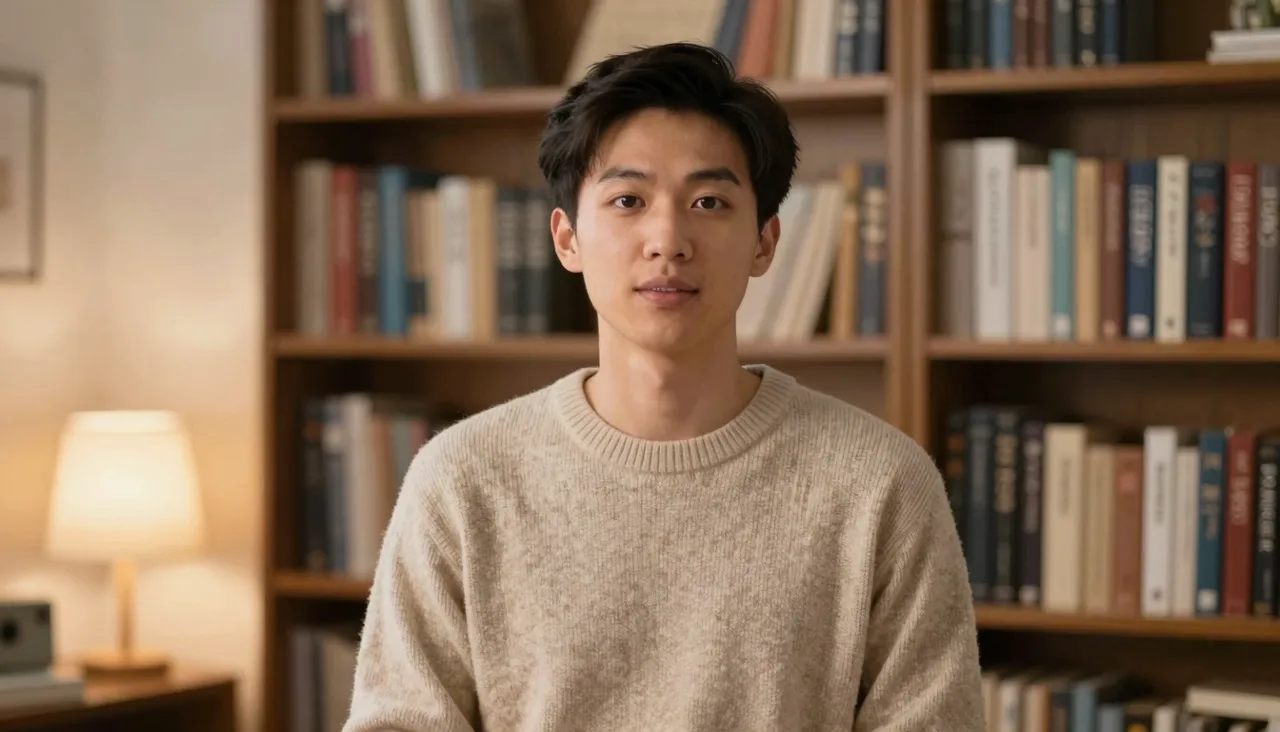
Por qué este avatar se siente diferente
La mayoría de las herramientas de fotografía parlante realizan el trabajo mecánicamente: el sonido entra, la boca sale. OmniHuman 1.5 lee la interpretación dentro del audio. Una línea excitada levanta las cejas, una pregunta suaviza la mirada, una pausa deja respirar al hablante. La salida se aleja de la "máscara animada" y se acerca a algo parecido a una entrega real en cámara.
La brecha se muestra más en el material emocional. Cualquier modelo de avatar puede sobrevivir a una narración plana, pero una felicitación sincera, un tono entusiasta o una línea cantada es donde este se gana su nombre. Cualquiera que sea el sentimiento que transmita tu grabación, el rostro en la pantalla lo capta y lo reproduce.
Entradas, formatos y el límite estricto
Los ingredientes son familiares: un retrato como JPEG, PNG o WebP, y una pista de voz como MP3, WAV, AAC, OGG o M4A, cada uno con un límite de 10 MB. La grabación debe durar menos de 15 segundos y, si la suya se excede, el formulario de generación tiene su propio recortador, por lo que aislar el fragmento correcto lleva unos segundos, no un viaje a un editor de audio.
Elija una imagen en la que la cara y la boca sean claramente visibles, pero no se sienta limitado a fotografías de estudio: las fotografías informales y las obras de arte estilizadas también se animan de manera convincente. Los videos terminados llegan al historial de tu generación, donde puedes descargar tomas, comparar versiones o reproducir la misma pista con un retrato diferente.
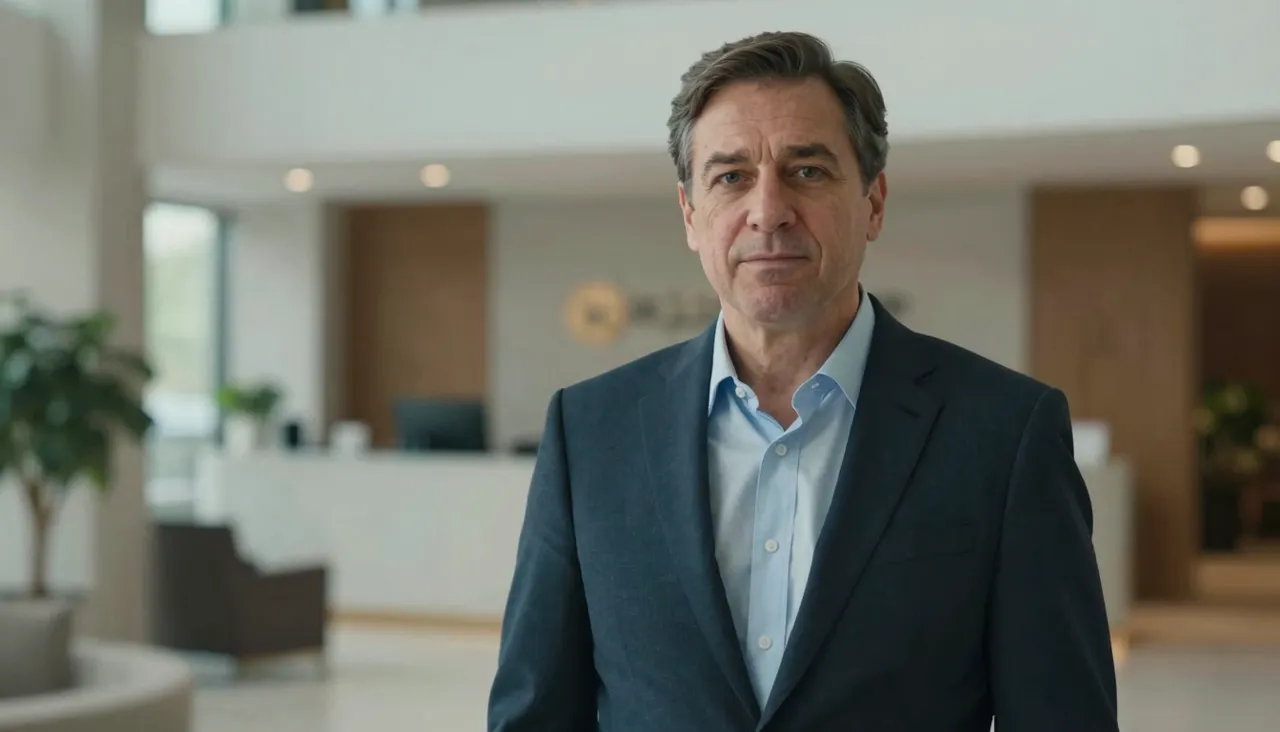
Obteniendo el resultado más expresivo
La palanca que más importa no es la foto, sino la grabación. Interpreta la línea como lo harías ante la cámara: pausas reales, énfasis real, sentimiento real. Una lectura monótona produce un carácter monótono, porque el modelo refleja fielmente lo que escucha. Grabar dos o tres entregas y generarlas todas es una forma barata de encontrar la toma que canta.
Para la imagen, la regla es un respiro. Una cara recortada de borde a borde no deja espacio para que se desarrolle el movimiento de la cabeza. Un encuadre con el pecho hacia arriba y aire alrededor de la cabeza le da al modelo espacio para las pequeñas inclinaciones y giros que venden la ilusión de una persona viva en lugar de un recorte en movimiento.
Escenarios donde brilla
Consíguelo cuando el carisma sea lo que se pueda entregar. Una promoción en la que un personaje realmente promociona la venta. Un retrato histórico que narra su propia historia para una guía de museo o un proyecto escolar. Una ilustración de portada cantando la primera línea de una canción. Cada uno de ellos vive o muere gracias a la animación emocional, que es exactamente la especialidad aquí.
El vídeo vertical corto merece su propia mención: tienes unos segundos para enganchar al espectador, y un rostro humano expresivo supera los subtítulos en pantalla en ese trabajo. El límite de audio de menos de 15 segundos coincide perfectamente con el formato; de todos modos, una línea de gancho tiene esa longitud.
OmniHuman u otra herramienta: una guía rápida
Este sitio también ofrece Kling AI Avatar, un modelo vecino de foto y audio con niveles de calidad Estándar y Pro. Regla general: para un presentador sereno, de estilo corporativo y con máxima resolución, pruebe ese; para vivacidad, emoción y personalidad, comience con OmniHuman 1.5. Ambos toman entradas idénticas, por lo que ejecutar sus archivos en cada uno y mantener la toma más fuerte no cuesta más que un poco de equilibrio.
Si su objetivo real es volver a expresar imágenes existentes en lugar de animar una imagen fija, Volcengine Lip Sync es la herramienta adecuada: reescribe las bocas en un video para que coincida con el nuevo audio. Y para escenas con guión con acción de cuerpo completo, se aplican modelos de vídeo generales como Kling 3.0; Los avatares parlantes son especialistas en primeros planos y discursos.
Preguntas frecuentes
¿Solo funciona con fotografías reales?
No: las ilustraciones y los retratos estilizados también se animan, siempre que el rostro sea claramente legible. El modelo genera expresión y articulación alrededor de los ojos y la boca, por lo que esas características deben ser distintas en la imagen de origen.
Mi avatar salió rígido. ¿Qué salió mal?
Es casi seguro que la grabación. El modelo refleja la energía de la voz, por lo que una lectura plana produce un rostro plano. Vuelva a grabar la línea con entonación, pausas y énfasis genuinos, y la expresividad del personaje aumentará con ella.
¿Cómo hago algo que dure más de 15 segundos?
Cada generación necesita un audio de menos de 15 segundos, así que divida un discurso más largo en partes, genere cada una con el mismo retrato y una los clips en cualquier editor de vídeo. Con un fondo estático, los cortes apenas se notan.