OmniHuman 1.5: ritratti parlanti espressivi guidati dalla tua voce
Bottom Line Up Front (BLUF): OmniHuman 1.5 è un generatore video AI che crea un essere umano parlante da una foto e una traccia audio. Ciò che lo distingue dagli strumenti base di sincronizzazione labiale è il modo in cui il personaggio vive il discorso: il modello ascolta il ritmo e le emozioni della registrazione e modella lo sguardo, l'espressione e il movimento della testa attorno ad esso, in modo che la persona sullo schermo sembri intendere quello che dice.
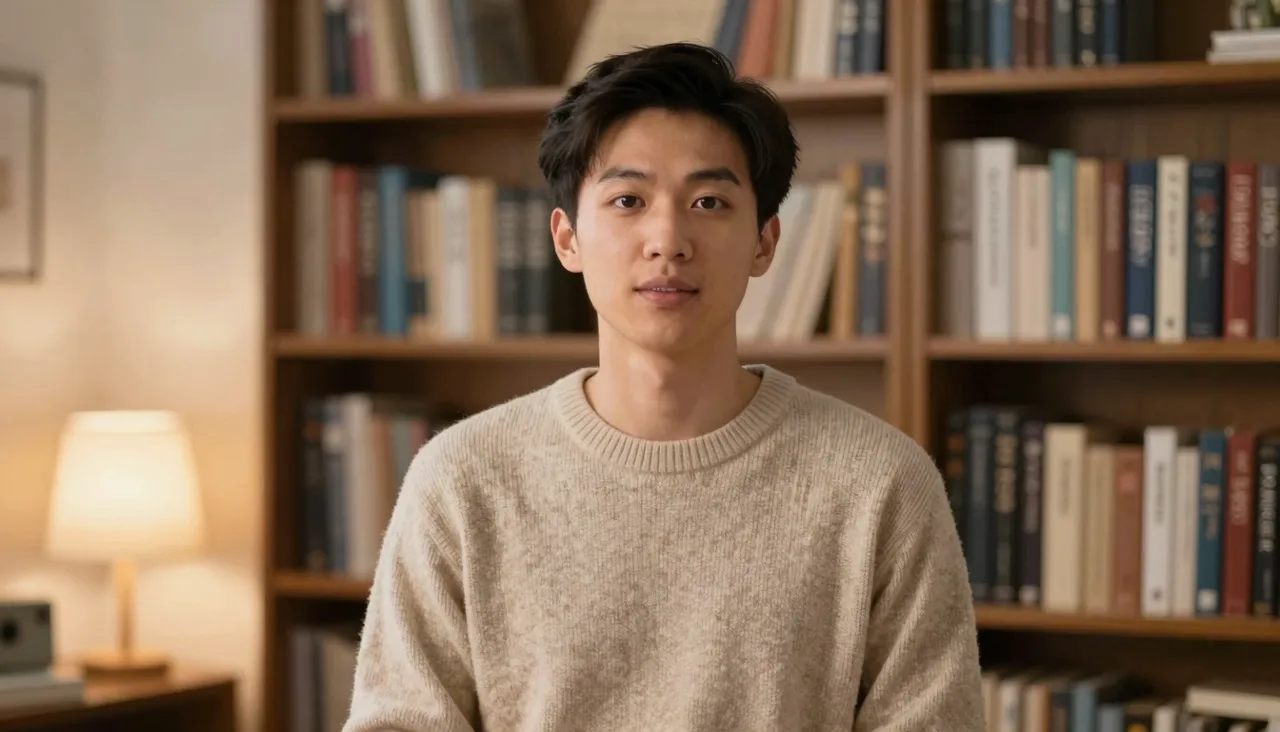
Perché questo avatar sembra diverso
La maggior parte degli strumenti per le foto parlanti trattano il lavoro in modo meccanico: il suono entra, la bocca si apre. OmniHuman 1.5 legge la performance all'interno dell'audio. Una linea concitata solleva le sopracciglia, una domanda addolcisce lo sguardo, una pausa lascia respirare chi parla. Il risultato si allontana dalla "maschera animata" e si avvicina a qualcosa che somiglia a un'effettiva consegna sulla fotocamera.
Il divario si manifesta maggiormente sul materiale emotivo. Qualsiasi modello di avatar può sopravvivere a una narrazione piatta, ma una sincera congratulazione, un tono entusiasta o una linea cantata è ciò che gli dà il nome. Qualunque sia la sensazione che trasmette la tua registrazione, il volto sullo schermo la riprende e la riproduce.
Ingressi, formati e limite rigido
Gli ingredienti sono familiari: un ritratto come JPEG, PNG o WebP e una traccia vocale come MP3, WAV, AAC, OGG o M4A, ciascuno limitato a 10 MB. La registrazione deve durare meno di 15 secondi e, se la tua dura troppo, il modulo di generazione ha il proprio trimmer, quindi isolare il frammento giusto richiede pochi secondi, non un viaggio in un editor audio.
Scegli un'immagine in cui il viso e la bocca siano chiaramente visibili, ma non sentirti limitato ai primi piani in studio: anche foto casuali e opere d'arte stilizzate si animano in modo convincente. I video finiti arrivano nella cronologia della tua generazione, dove puoi scaricare riprese, confrontare versioni o eseguire la stessa traccia con un ritratto diverso.
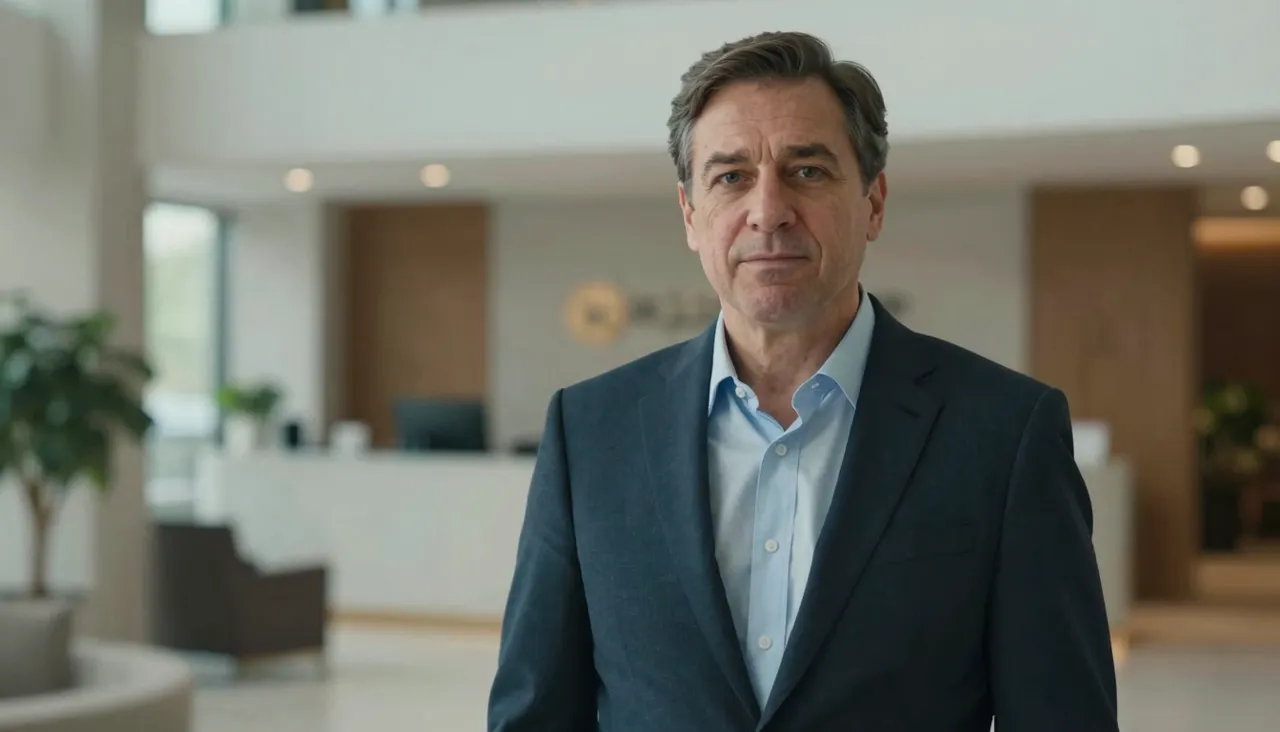
Ottenere il risultato più espressivo
La leva che conta di più non è la foto, ma la registrazione. Esegui la battuta come faresti davanti alla telecamera: pause vere, enfasi reale, sentimento reale. Una lettura monotona produce un carattere monotono, perché il modello rispecchia fedelmente ciò che sente. Registrare due o tre parti e generarle tutte è un modo economico per trovare la versione che fa più parlare di sé.
Per l'immagine la regola è il respiro. Un viso tagliato da bordo a bordo non lascia spazio per il movimento della testa. Un'inquadratura a petto in su con aria intorno alla testa dà al modello spazio per piccole inclinazioni e svolte che vendono l'illusione di una persona viva piuttosto che di un ritaglio in movimento.
Scenari in cui brilla
Raggiungilo quando il carisma è il risultato finale. Un promo in cui un personaggio promuove sinceramente la vendita. Un ritratto storico che racconta la propria storia per una guida museale o un progetto scolastico. Un'illustrazione di copertina che canta la riga di apertura di un brano. Ognuno di questi vive o muore grazie all'animazione emotiva, che è esattamente la specialità qui.
Un breve video verticale merita una menzione a parte: hai pochi secondi per catturare uno spettatore e un volto umano espressivo batte le didascalie sullo schermo in quel lavoro. Il limite audio inferiore a 15 secondi sembra corrispondere perfettamente al formato: una linea di hook è comunque lunga più o meno.
OmniHuman o un altro strumento: una guida rapida
Questo sito offre anche Kling AI Avatar, un modello con foto e audio adiacente con livelli di qualità Standard e Pro. Regola pratica approssimativa: per un presentatore composto, in stile aziendale alla massima risoluzione, prova quella; per vivacità, emozione e personalità, inizia con OmniHuman 1.5. Entrambi accettano input identici, quindi eseguire i file attraverso ciascuno e mantenere la presa più forte non costa altro che un piccolo equilibrio.
Se il tuo obiettivo reale è dare nuova voce a un metraggio esistente anziché animare un'immagine fissa, Volcengine Lip Sync è lo strumento giusto: riscrive le bocche in un video per adattarle al nuovo audio. E per le scene con script con azione di tutto il corpo, si applicano modelli video generali come Kling 3.0; gli avatar parlanti sono specialisti in primi piani e discorsi.
Domande frequenti
Funziona solo con fotografie reali?
No: anche le illustrazioni e i ritratti stilizzati si animano, a condizione che il volto sia chiaramente leggibile. Il modello costruisce l'espressione e l'articolazione attorno agli occhi e alla bocca, quindi tali caratteristiche devono essere distinte nell'immagine originale.
Il mio avatar è uscito rigido. Cosa è andato storto?
Quasi certamente la registrazione. Il modello rispecchia l'energia della voce, quindi una lettura piatta produce un viso piatto. Registra nuovamente la battuta con intonazione, pause ed enfasi autentiche, e con essa l'espressività del personaggio aumenta.
Come faccio a creare qualcosa che duri più di 15 secondi?
Ogni generazione ha bisogno di un audio inferiore a 15 secondi, quindi dividi un discorso più lungo in parti, genera ciascuna con lo stesso ritratto e unisci le clip in qualsiasi editor video. Con uno sfondo statico i tagli sono appena percettibili.