OmniHuman 1.5:由声音驱动的富有表现力的说话肖像
核心要点 (BLUF): OmniHuman 1.5 是一款人工智能视频生成器,可根据一张照片和一个音轨构建一个会说话的人。它与基本口型同步工具的不同之处在于角色如何表达讲话:模型聆听录音的节奏和情感,并塑造周围的目光、表情和头部运动,因此屏幕上的人似乎言出必行。
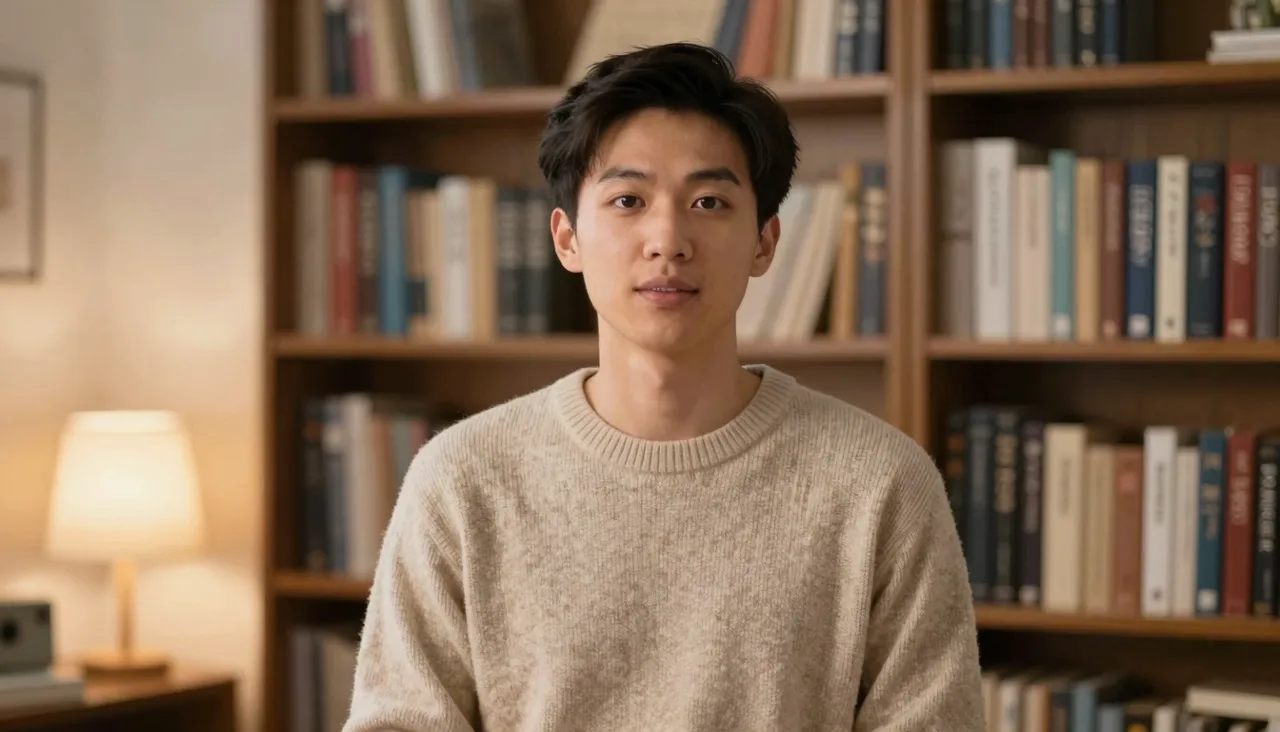
为什么这个头像感觉不一样
大多数有声照片工具都是机械地处理这项工作——声音输入,嘴巴张开。 OmniHuman 1.5 读取音频内的演奏。激动的台词让人扬起眉毛,问题让目光变得柔和,停顿让说话者喘口气。输出不再是“动画蒙版”,而是类似于实际的摄像机传送。
这种差距在情感材料上表现得最为明显。任何化身模型都可以在平淡的旁白中幸存下来,但衷心的祝贺、热情的音调或歌词才是这个化身模型的得名之处。无论您的录音带有什么感觉,屏幕上的面孔都会拾取并播放它。
输入、格式和硬限制
这些成分很熟悉:肖像为 JPEG、PNG 或 WebP,音轨为 MP3、WAV、AAC、OGG 或 M4A,每个上限为 10 MB。录音必须保持在 15 秒以内,如果您的录音超过了,生成形式有自己的修剪器,因此隔离正确的片段只需几秒钟,而不需要使用音频编辑器。
选择面部和嘴巴清晰可见的图像,但不要觉得局限于工作室头像:随意的照片和风格化的艺术作品也令人信服。完成的视频会出现在您的生成历史中,您可以在其中下载片段、比较版本或针对不同的肖像运行相同的曲目。
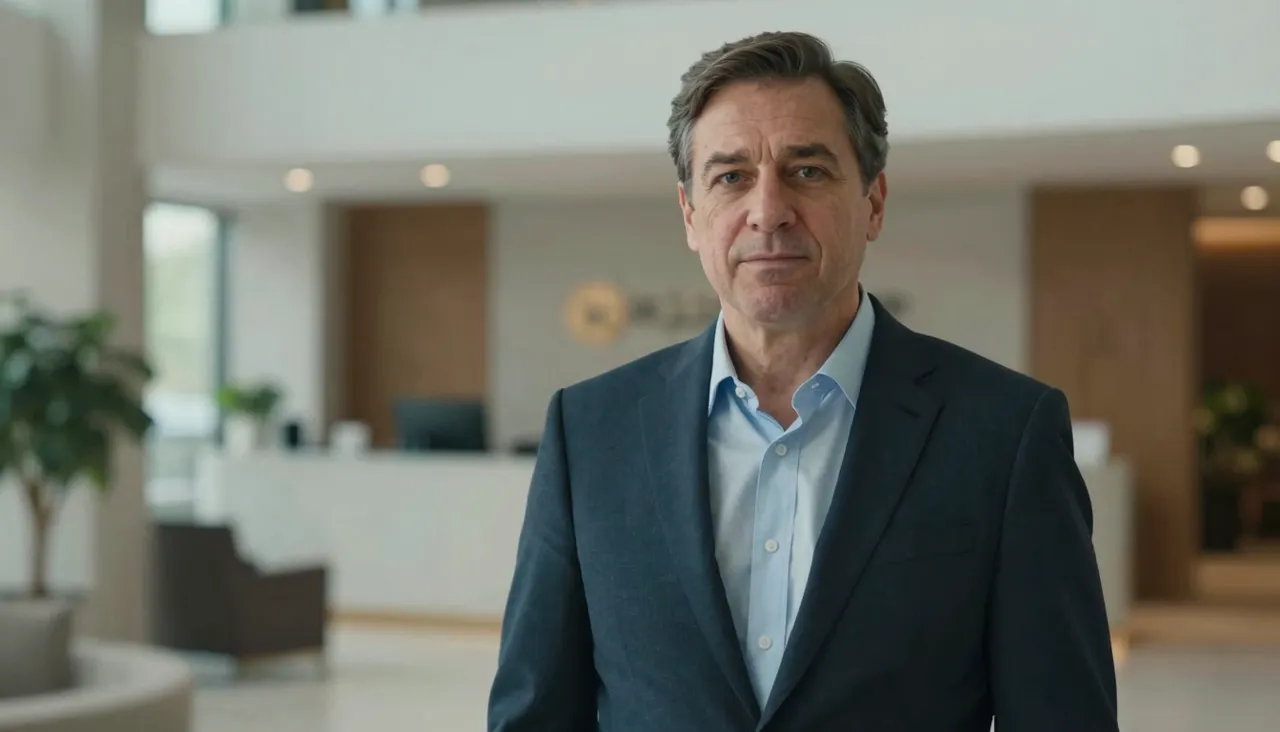
获得最具表现力的结果
最重要的杠杆不是照片,而是录音。像在镜头前那样表演台词:真正的停顿、真正的强调、真实的感觉。单调的阅读会产生单调的特征,因为模型忠实地反映了它所听到的内容。录制两到三个交付并生成所有这些交付是找到歌唱的镜头的一种廉价方法。
对于图像来说,规则是呼吸空间。边对边裁剪的脸部没有留下头部运动展开的空间。胸部向上的框架,头部周围有空气,为模型提供了小倾斜和旋转的空间,从而产生了活人的错觉,而不是移动的切口。
闪耀的场景
当魅力是可交付成果时,就去争取它。一个角色真诚地宣传促销的促销活动。为博物馆导游或学校项目讲述自己故事的历史肖像。封面艺术插图演唱歌曲的开场白。每个人的生死都取决于情感动画,这正是这里的特色。
简短的垂直视频值得一提:你有几秒钟的时间来吸引观众,而富有表现力的人脸胜过屏幕上的字幕。 15 秒以下的音频限制恰好与格式完美匹配——无论如何,钩线大约有那么长。
OmniHuman 或其他工具:快速指南
该网站还提供 Kling AI Avatar,这是一个邻近的照片加音频模型,具有标准和专业质量等级。粗略的经验法则是:对于一位冷静、企业风格的演示者来说,在最大分辨率下,尝试一下;为了活泼、情感和个性,从OmniHuman1.5开始。两者都采用相同的输入,因此通过每个文件运行文件并保持更强的输入只需要一点平衡即可。
如果您的实际目标是重新配音现有镜头而不是动画静止图像,Volcengine Lip Sync 是正确的工具 - 它会重写视频中的嘴巴以匹配新的音频。对于全身动作的脚本场景,适用Kling3.0等通用视频模型;会说话的化身是特写和演讲方面的专家。
常见问题
它只适用于真实照片吗?
不——插图和风格化的肖像也可以动画化,只要脸部清晰可见。该模型在眼睛和嘴巴周围构建表情和清晰度,因此这些特征需要在源图像中清晰可见。
我的头像僵硬了。出了什么问题?
几乎可以肯定是录音。该模型反映了声音的能量,因此平淡的读音会产生平淡的面孔。用真实的语调、停顿和重音重新录制台词,角色的表现力就会随之提高。
如何制作超过 15 秒的内容?
每一代都需要 15 秒以内的音频,因此将较长的语音分成多个块,生成具有相同肖像的每个块,然后在任何视频编辑器中加入剪辑。在静态背景下,切口几乎不明显。