OmniHuman 1.5: Ausdrucksstarke sprechende Porträts, angetrieben von Ihrer Stimme
Bottom Line Up Front (BLUF): OmniHuman 1.5 ist ein KI-Videogenerator, der aus einem Foto und einer Audiospur einen sprechenden Menschen erstellt. Was es von einfachen Lippensynchronisationswerkzeugen unterscheidet, ist die Art und Weise, wie die Figur in die Sprache eindringt: Das Modell hört auf den Rhythmus und die Emotionen der Aufnahme und formt Blick, Ausdruck und Kopfbewegung darum herum, sodass die Person auf dem Bildschirm scheinbar meint, was sie sagt.
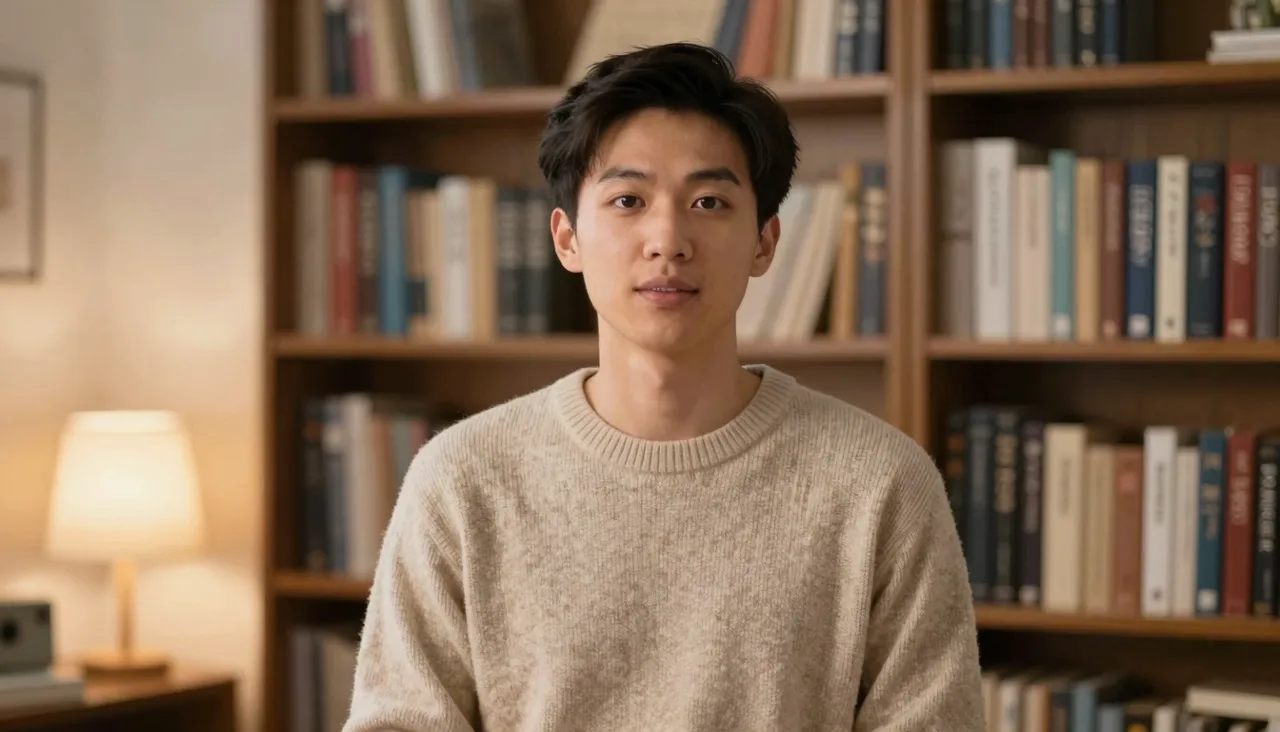
Warum sich dieser Avatar anders anfühlt
Die meisten sprechenden Fototools erledigen den Job mechanisch – Ton rein, Mund rausklappen. OmniHuman 1.5 liest die Performance im Audio. Eine aufgeregte Linie hebt die Augenbrauen, eine Frage mildert den Blick, eine Pause lässt den Redner aufatmen. Die Ausgabe tendiert weg von einer „animierten Maske“ und hin zu etwas, das einer tatsächlichen Wiedergabe vor der Kamera ähnelt.
Die Lücke zeigt sich am meisten bei emotionalem Material. Jedes Avatar-Modell kann eine flache Erzählung überleben, aber eine herzliche Gratulation, ein enthusiastischer Pitch oder eine gesungene Zeile sind es, wo dieses Modell seinen Namen verdient. Welches Gefühl auch immer Ihre Aufnahme vermittelt, das Gesicht auf dem Bildschirm nimmt es auf und gibt es wieder.
Eingaben, Formate und das harte Limit
Die Zutaten sind bekannt: ein Porträt als JPEG, PNG oder WebP und eine Sprachspur als MP3, WAV, AAC, OGG oder M4A, jeweils begrenzt auf 10 MB. Die Aufnahme muss unter 15 Sekunden bleiben – und wenn Ihre Aufnahme länger dauert, verfügt das Generierungsformular über einen eigenen Trimmer, sodass das Isolieren des richtigen Fragments Sekunden dauert und nicht den Gang zu einem Audio-Editor erfordert.
Wählen Sie ein Bild, bei dem Gesicht und Mund deutlich sichtbar sind, aber beschränken Sie sich nicht auf Studio-Kopfaufnahmen: Auch lockere Fotos und stilisierte Kunstwerke wirken überzeugend. Fertige Videos landen in Ihrem Generationsverlauf, wo Sie Takes herunterladen, Versionen vergleichen oder denselben Track mit einem anderen Porträt vergleichen können.
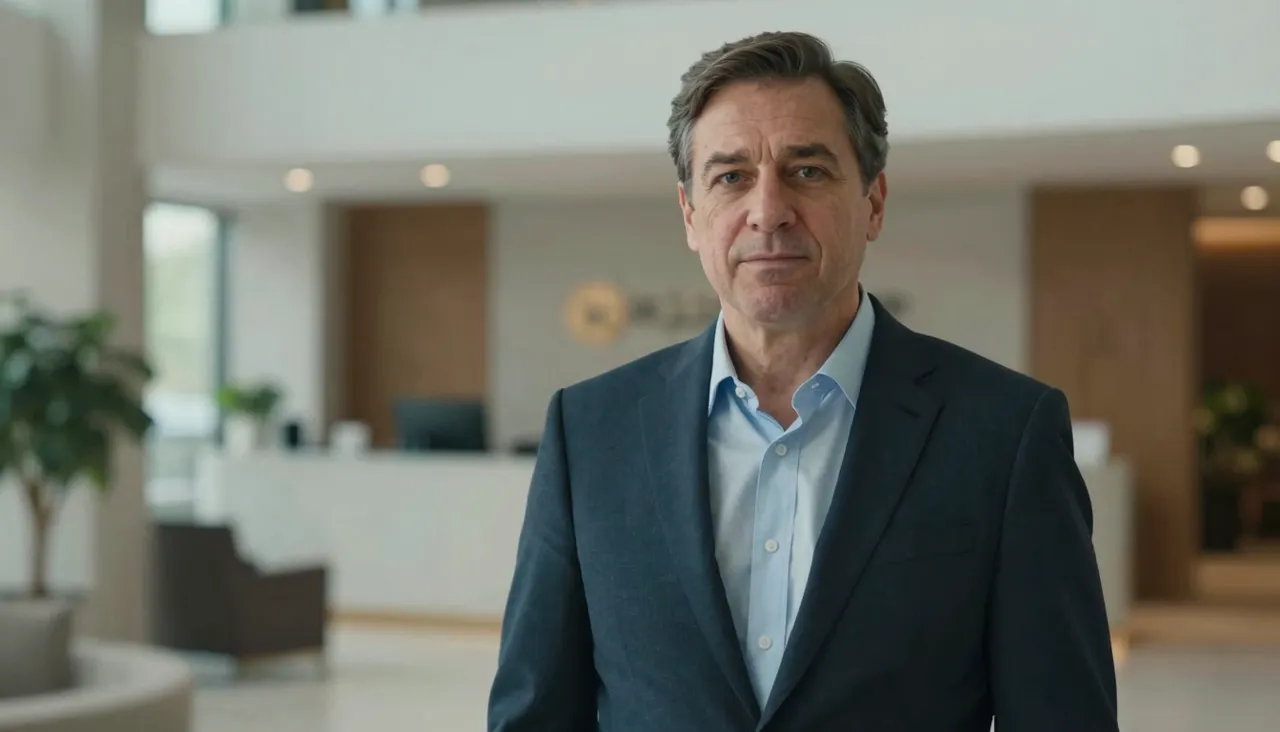
Das ausdrucksstärkste Ergebnis erzielen
Der entscheidende Hebel ist nicht das Foto, sondern die Aufnahme. Führen Sie die Zeile so aus, wie Sie es vor der Kamera tun würden: echte Pausen, echte Betonung, echtes Gefühl. Eine monotone Lesung erzeugt einen monotonen Charakter, da das Modell das, was es hört, originalgetreu widerspiegelt. Das Aufzeichnen von zwei oder drei Lieferungen und das Generieren aller davon ist eine kostengünstige Möglichkeit, den Take zu finden, der singt.
Für das Bild gilt: Freiraum zum Atmen. Ein von Kante zu Kante beschnittenes Gesicht lässt keinen Raum für die Entfaltung der Kopfbewegung. Eine Brustaufnahme mit Luft um den Kopf gibt dem Modell Raum für kleine Neigungen und Drehungen, die eher die Illusion einer lebenden Person als eines beweglichen Ausschnitts vermitteln.
Szenarien, in denen es glänzt
Greifen Sie danach, wenn Charisma gefragt ist. Eine Werbeaktion, bei der ein Charakter den Verkauf wirklich anpreist. Ein historisches Porträt, das seine eigene Geschichte für einen Museumsführer oder ein Schulprojekt erzählt. Eine Cover-Illustration, die die Eröffnungszeile eines Titels singt. Jeder von ihnen lebt oder stirbt von emotionaler Animation, und das ist genau die Spezialität hier.
Kurze vertikale Videos verdienen eine eigene Erwähnung: Sie haben Sekunden Zeit, um den Betrachter in den Bann zu ziehen, und ein ausdrucksstarkes menschliches Gesicht übertrifft dabei die Bildunterschriften auf dem Bildschirm. Die Audiobeschränkung von unter 15 Sekunden passt perfekt zum Format – eine Hookline ist ohnehin ungefähr so lang.
OmniHuman oder ein anderes Tool: eine Kurzanleitung
Diese Seite bietet auch Kling AI Avatar, ein benachbartes Foto-plus-Audio-Modell mit den Qualitätsstufen Standard und Pro. Grobe Faustregel: Versuchen Sie es mit diesem, wenn Sie einen gelassenen, unternehmenstypischen Vortrag mit maximaler Auflösung wünschen. Für Lebendigkeit, Emotion und Persönlichkeit beginnen Sie mit OmniHuman 1.5. Beide benötigen identische Eingaben, daher kostet es nur ein wenig Ausgewogenheit, Ihre Dateien durch beide zu laufen und die stärkere Einstellung beizubehalten.
Wenn Ihr eigentliches Ziel darin besteht, vorhandenes Filmmaterial neu zu vertonen, anstatt ein Standbild zu animieren, ist Volcengine Lip Sync das richtige Werkzeug – es schreibt Münder in einem Video neu, um sie an neue Audiodaten anzupassen. Und für Drehbuchszenen mit Ganzkörper-Action gelten allgemeine Videomodelle wie Kling 3.0; Sprechende Avatare sind Spezialisten für Nahaufnahmen und Sprache.
Häufige Fragen
Funktioniert es nur mit echten Fotos?
Nein – Illustrationen und stilisierte Porträts sind ebenfalls animiert, sofern das Gesicht deutlich lesbar ist. Das Modell baut Ausdruck und Artikulation rund um Augen und Mund auf, daher müssen diese Merkmale im Quellbild deutlich erkennbar sein.
Mein Avatar wirkte steif. Was ist schief gelaufen?
Mit ziemlicher Sicherheit die Aufnahme. Das Modell spiegelt die Energie der Stimme wider, sodass eine flache Lektüre ein flaches Gesicht ergibt. Nehmen Sie die Zeile mit echter Intonation, Pausen und Betonung noch einmal auf, und die Ausdruckskraft der Figur nimmt damit zu.
Wie erstelle ich etwas, das länger als 15 Sekunden dauert?
Jede Generation benötigt weniger als 15 Sekunden Audio. Teilen Sie daher eine längere Rede in Abschnitte auf, generieren Sie diese jeweils mit demselben Porträt und fügen Sie die Clips in einem beliebigen Videoeditor zusammen. Bei einem statischen Hintergrund sind die Schnitte kaum wahrnehmbar.