OmniHuman 1.5: uttrycksfulla talande porträtt som drivs av din röst
Bottom Line Up Front (BLUF): OmniHuman 1.5 är en AI-videogenerator som bygger en talande människa från ett foto och ett ljudspår. Det som skiljer den från grundläggande läppsynkroniseringsverktyg är hur karaktären lever i talet: modellen lyssnar på rytmen och känslorna i inspelningen och formar blicken, uttrycket och huvudrörelsen runt den, så personen på skärmen verkar mena vad de säger.
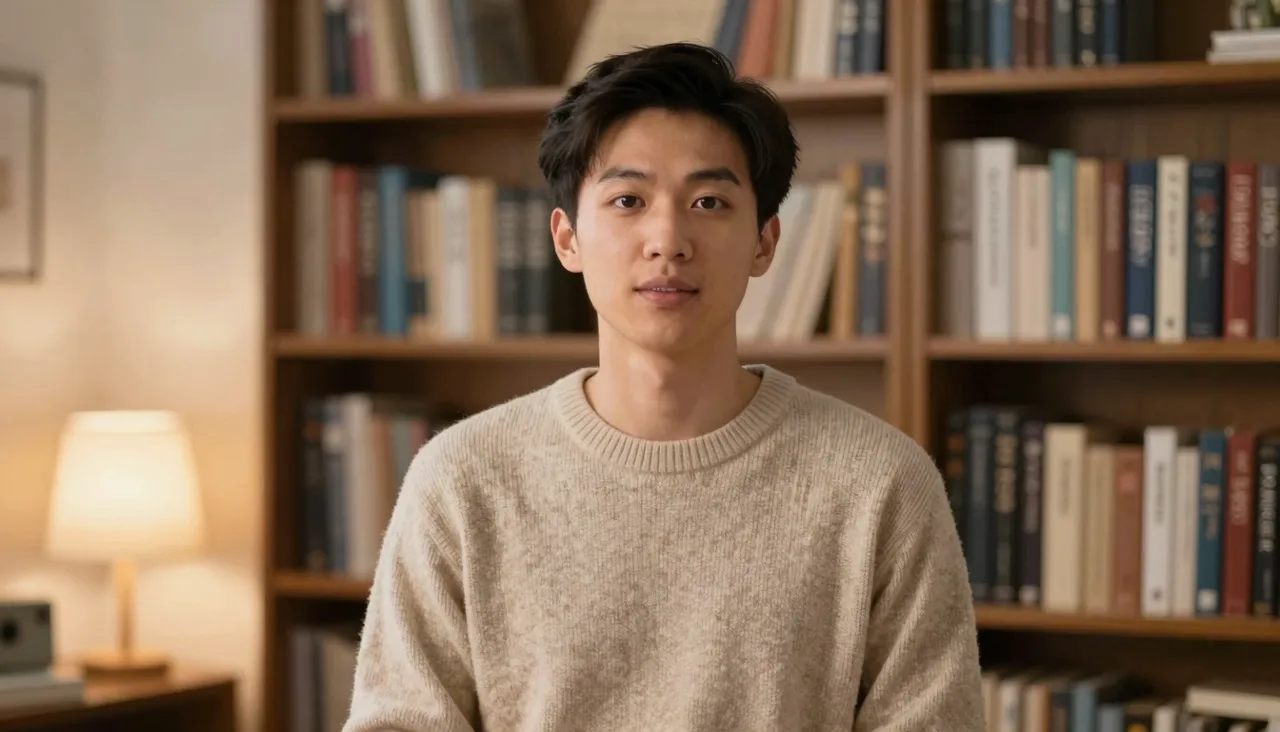
Varför den här avataren känns annorlunda
De flesta verktyg för talande foto hanterar jobbet mekaniskt – ljud in, munnen klaffar ut. OmniHuman 1.5 läser framförandet inuti ljudet. En upphetsad linje lyfter ögonbrynen, en fråga mjukar upp blicken, en paus låter talaren andas. Utgången lutar bort från "animerad mask" och mot något som liknar faktiska leveranser på kameran.
Gapet visar sig mest på känslomässigt material. Vilken avatarmodell som helst kan överleva ett platt berättande, men ett hjärtligt grattis, en entusiastisk tonhöjd eller en sjungen replik är där den här får sitt namn. Oavsett vilken känsla din inspelning bär, plockar ansiktet på skärmen upp den och spelar upp den.
Ingångar, format och den hårda gränsen
Ingredienserna är bekanta: ett porträtt som JPEG, PNG eller WebP, och ett röstspår som MP3, WAV, AAC, OGG eller M4A, var och en begränsad till 10 MB. Inspelningen måste vara under 15 sekunder — och om din tar slut har generationsformuläret sin egen trimmer, så att isolera rätt fragment tar sekunder, inte en resa till en ljudredigerare.
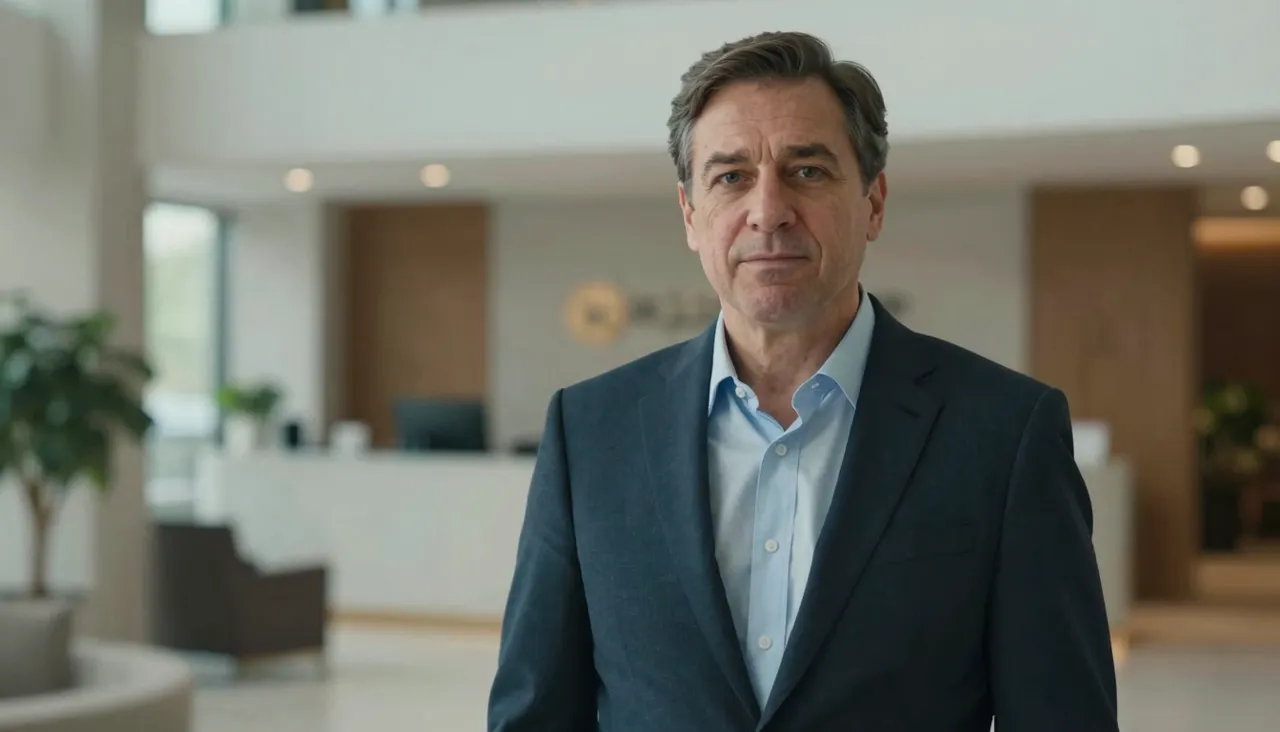
Välj en bild där ansiktet och munnen är tydligt synliga, men känn dig inte begränsade till headshots i studio: vardagliga foton och stiliserade konstverk animerar också övertygande. Färdiga videor hamnar i din generations historia, där du kan ladda ner tagningar, jämföra versioner eller köra samma spår mot ett annat porträtt.
Få det mest uttrycksfulla resultatet
Spaken som betyder mest är inte fotot – det är inspelningen. Utför repliken som du skulle göra på kameran: riktiga pauser, verklig betoning, verklig känsla. En monoton läsning ger en monoton karaktär, eftersom modellen troget speglar vad den hör. Att spela in två eller tre leveranser och generera alla är ett billigt sätt att hitta den låt som sjunger.
För bilden är regeln andrum. Ett ansikte beskuret kant till kant lämnar inget utrymme för huvudrörelser att veckla ut sig. En inramning på bröstet med luft runt huvudet ger modellen utrymme för de små lutningar och svängar som säljer illusionen av en levande person snarare än en rörlig utskärning.
Scenarier där det lyser
Nå efter det när karisma är leveransen. En kampanj där en karaktär verkligen hypar försäljningen. Ett historiskt porträtt som berättar sin egen historia för en museiguide eller ett skolprojekt. En omslagsillustration som sjunger inledningen av ett spår. Var och en av dessa lever eller dör på känslomässig animation, vilket är precis specialiteten här.
Kort vertikal video förtjänar sitt eget omnämnande: du får sekunder på dig att fånga en tittare, och ett uttrycksfullt mänskligt ansikte slår undertexter på skärmen på det jobbet. Ljudgränsen under 15 sekunder råkar matcha formatet perfekt - en kroklinje är ungefär så lång ändå.
OmniHuman eller ett annat verktyg: en snabbguide
Den här webbplatsen erbjuder också Kling AI Avatar, en närliggande foto-plus-ljudmodell med standard- och pro-kvalitetsnivåer. Grov tumregel: för en sammansatt presentatör i företagsstil med maximal upplösning, prova den; för livlighet, känslor och personlighet, börja med OmniHuman 1.5. Båda tar identiska ingångar, så att köra dina filer genom var och en och behålla den starkare tagningen kostar inget annat än lite balans.
Om ditt faktiska mål är att återskapa befintliga bilder snarare än att animera en stillbild, är Volcengine Lip Sync det rätta verktyget – det skriver om munnar i en video för att matcha nytt ljud. Och för manusscener med action för hela kroppen gäller generella videomodeller som Kling 3.0; Talande avatarer är specialister på närbilder och tal.
Vanliga frågor
Fungerar det bara med riktiga fotografier?
Nej – illustrationer och stiliserade porträtt animerar också, förutsatt att ansiktet är tydligt läsbart. Modellen bygger uttryck och artikulation runt ögonen och munnen, så dessa funktioner måste vara distinkta i källbilden.
Min avatar blev stel. Vad gick fel?
Nästan säkert inspelningen. Modellen speglar röstens energi, så en platt läsning ger ett platt ansikte. Spela in raden igen med äkta intonation, pauser och betoning, och karaktärens uttrycksfullhet stiger med den.
Hur gör jag något längre än 15 sekunder?
Varje generation behöver ljud under 15 sekunder, så dela upp ett längre tal i bitar, generera var och en med samma porträtt och gå med i klippen i valfri videoredigerare. Med en statisk bakgrund är skärningarna knappt märkbara.