OmniHuman 1.5: portrete expresive vorbitoare conduse de vocea ta
Bottom Line Up Front (BLUF): OmniHuman 1.5 este un generator video AI care construiește un om vorbitor dintr-o fotografie și o pistă audio. Ceea ce îl diferențiază de instrumentele de sincronizare a buzelor de bază este modul în care personajul locuiește în discurs: modelul ascultă ritmul și emoția înregistrării și modelează privirea, expresia și mișcarea capului în jurul acesteia, astfel încât persoana de pe ecran pare să spună ceea ce spune.
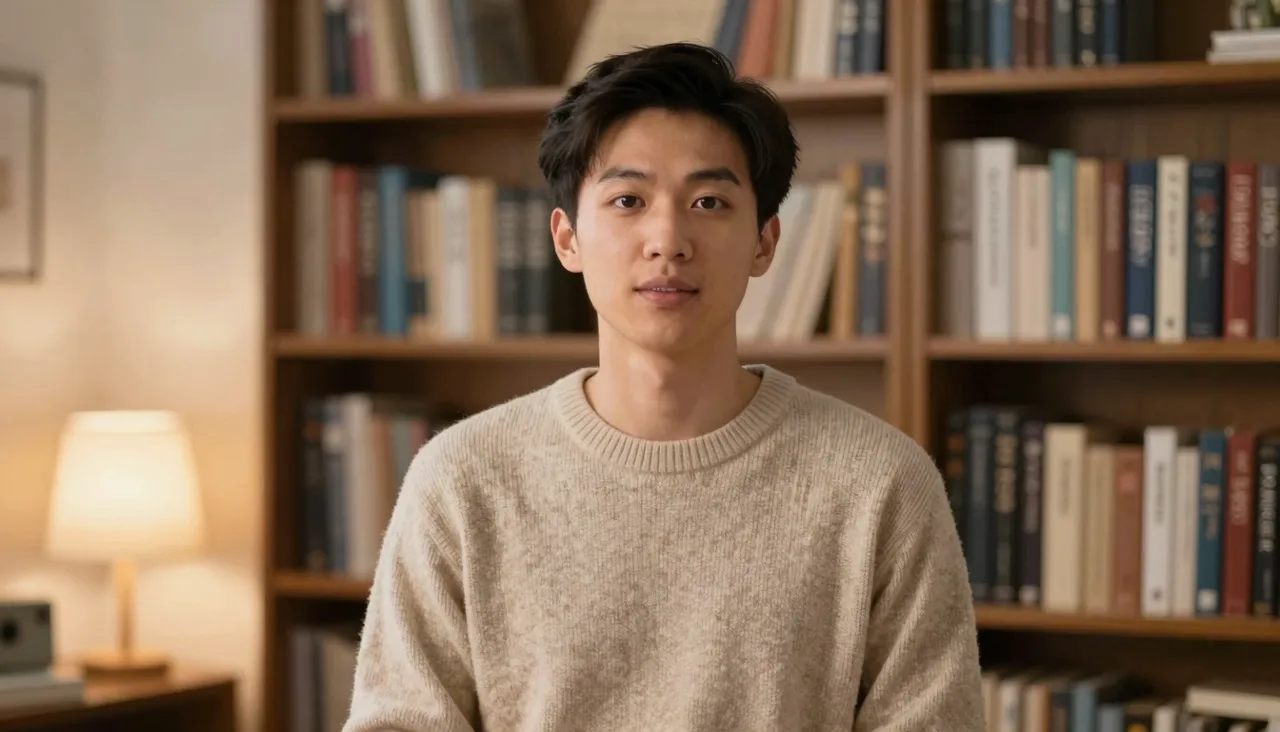
De ce acest avatar se simte diferit
Cele mai multe instrumente de fotografie care vorbesc tratează munca mecanic - sunet înăuntru, gura iese în afară. OmniHuman 1.5 citește performanța în interiorul audio. O linie emoționată ridică sprâncenele, o întrebare înmoaie privirea, o pauză lasă vorbitorul să respire. Ieșirea se înclină departe de „mască animată” și spre ceva care seamănă cu livrarea reală pe cameră.
Decalajul se vede cel mai mult pe materialul emoțional. Orice model de avatar poate supraviețui unei narațiuni plat, dar o felicitare sinceră, o prezentare entuziastă sau o linie cântată este locul în care aceasta își câștigă numele. Indiferent de senzația pe care o transmite înregistrarea ta, fața de pe ecran o preia și o redă.
Intrări, formate și limita tare
Ingredientele sunt familiare: un portret ca JPEG, PNG sau WebP și o pistă vocală ca MP3, WAV, AAC, OGG sau M4A, fiecare cu o limită de 10 MB. Înregistrarea trebuie să rămână sub 15 secunde – iar dacă a ta se depășește, formularul de generare are propriul său trimmer, așa că izolarea fragmentului potrivit durează câteva secunde, nu o călătorie la un editor audio.
Alegeți o imagine în care fața și gura să fie clar vizibile, dar să nu vă simțiți limitat la fotografiile de studio: fotografiile ocazionale și lucrările de artă stilizate se animă și ele în mod convingător. Videoclipurile terminate ajung în istoricul generației dvs., de unde puteți descărca retrageri, compara versiuni sau puteți rula aceeași piesă cu un alt portret.
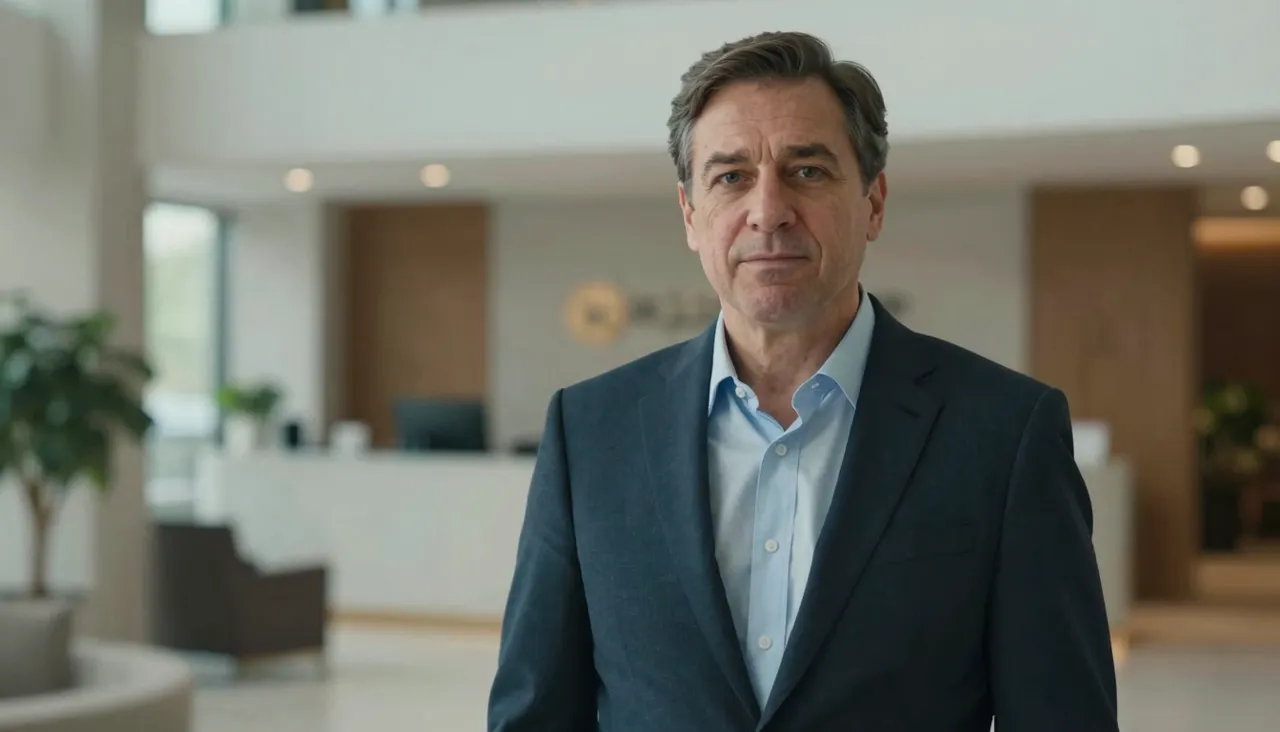
Obținerea celui mai expresiv rezultat
Pârghia care contează cel mai mult nu este fotografia, ci înregistrarea. Execută versul așa cum ai face cu camera: pauze reale, accent real, sentiment real. O lectură monotonă produce un caracter monoton, deoarece modelul oglindește fidel ceea ce aude. Înregistrarea a două sau trei livrări și a le genera pe toate este o modalitate ieftină de a găsi interpretarea care cântă.
Pentru imagine, regula este spațiu de respirație. O față tăiată margine la margine nu lasă spațiu pentru mișcarea capului să se desfășoare. O încadrare în piept în sus cu aer în jurul capului oferă modelului spațiu pentru micile înclinări și întoarceri care vând mai degrabă iluzia unei persoane vii decât un decupaj în mișcare.
Scenarii în care strălucește
Atinge-l atunci când carisma este livrabil. O promoție în care un personaj susține cu adevărat vânzarea. Un portret istoric care povestește propria sa poveste pentru un ghid de muzeu sau un proiect școlar. O ilustrație de coperta cântând linia de deschidere a unei piese. Fiecare dintre acestea trăiește sau moare pe baza animației emoționale, care este exact specialitatea aici.
Videoclipul scurt pe verticală merită propria sa mențiune: ai câteva secunde pentru a cuceri un spectator, iar o față umană expresivă bate subtitrările de pe ecran la acel job. Limita audio sub 15 secunde se potrivește perfect cu formatul – oricum o linie de cârlig este cam atât de lungă.
OmniHuman sau alt instrument: un ghid rapid
Acest site oferă, de asemenea, Kling AI Avatar, un model foto-plus-audio vecin cu niveluri de calitate Standard și Pro. Regula generală: pentru un prezentator compus, în stil corporativ, la rezoluție maximă, încercați-o pe aceea; pentru vivacitate, emoție și personalitate, începe cu OmniHuman 1.5. Ambele au intrări identice, așa că rularea fișierelor prin fiecare și menținerea valorii mai puternice nu costă altceva decât un mic echilibru.
Dacă obiectivul dvs. real este să rescrieți imaginile existente, mai degrabă decât să animați o imagine, Volcengine Lip Sync este instrumentul potrivit - rescrie gurile într-un videoclip pentru a se potrivi cu noul sunet. Și pentru scenele cu scenariu cu acțiune pe tot corpul, se aplică modele video generale precum Kling 3.0; avatarurile vorbitoare sunt specialiști în prim-planuri și vorbire.
Întrebări frecvente
Funcționează doar cu fotografii reale?
Nu — ilustrațiile și portretele stilizate sunt animate, de asemenea, cu condiția ca chipul să fie lizibil. Modelul construiește expresia și articulația în jurul ochilor și gurii, astfel încât aceste caracteristici trebuie să fie distincte în imaginea sursă.
Avatarul meu a ieșit rigid. Ce a mers prost?
Aproape sigur înregistrarea. Modelul oglindește energia vocii, astfel încât o citire plată dă o față plată. Reînregistrați versul cu intonație autentică, pauze și accent, iar expresivitatea personajului crește odată cu ea.
Cum fac ceva mai lung de 15 secunde?
Fiecare generație are nevoie de sunet sub 15 secunde, așa că împărțiți un discurs mai lung în bucăți, generați fiecare cu același portret și uniți-vă clipurile în orice editor video. Cu un fundal static, tăieturile abia se observă.