OmniHuman 1.5: आपकी आवाज़ से संचालित अभिव्यंजक बात करने वाले चित्र
Bottom Line Up Front (BLUF): OmniHuman 1.5 एक AI वीडियो जनरेटर है जो एक फोटो और एक ऑडियो ट्रैक से बोलने वाला इंसान बनाता है। जो चीज़ इसे बुनियादी लिप-सिंक टूल से अलग करती है, वह यह है कि पात्र कैसे भाषण देता है: मॉडल रिकॉर्डिंग की लय और भावना को सुनता है और उसके चारों ओर टकटकी, अभिव्यक्ति और सिर की गति को आकार देता है, इसलिए स्क्रीन पर मौजूद व्यक्ति का मतलब वही होता है जो वे कहते हैं।
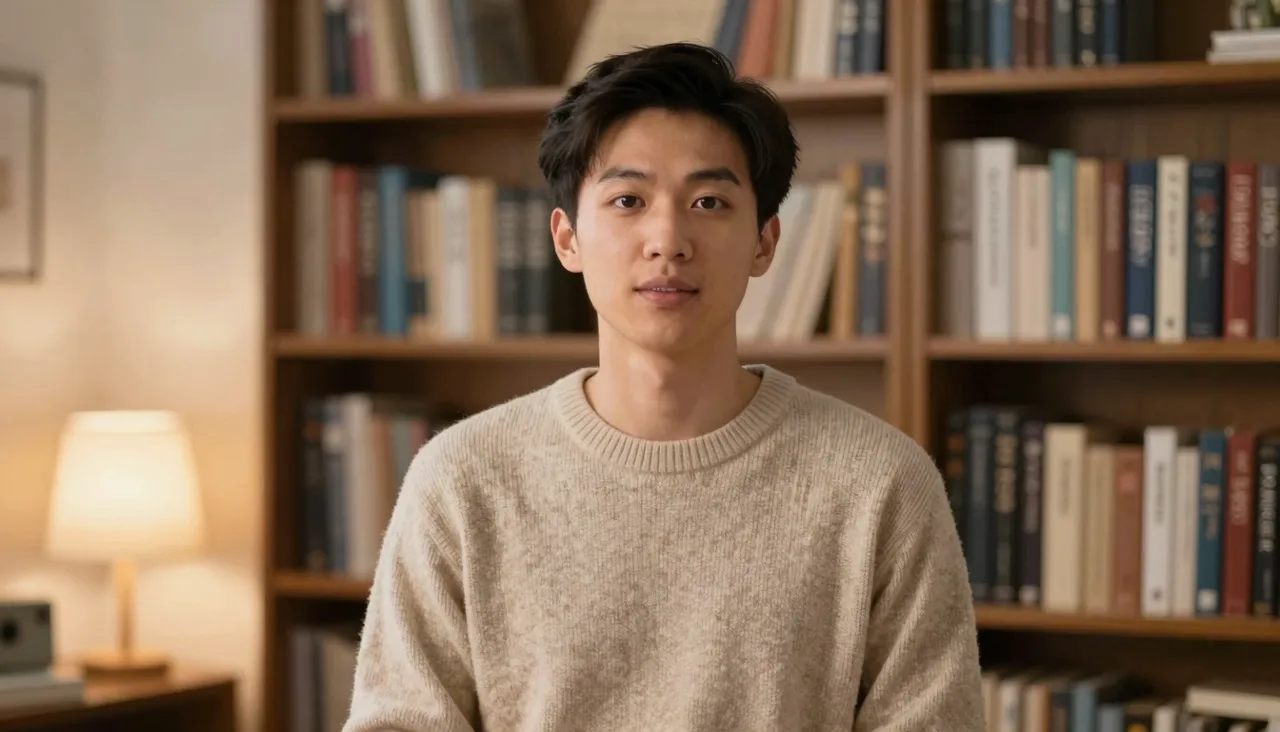
यह अवतार अलग क्यों लगता है?
अधिकांश टॉकिंग-फोटो उपकरण काम को यंत्रवत् करते हैं - ध्वनि अंदर, मुंह फड़फड़ाता है। OmniHuman 1.5 ऑडियो के अंदर प्रदर्शन को पढ़ता है। एक उत्साहित रेखा भौहें उठाती है, एक प्रश्न नज़र को नरम कर देता है, एक विराम वक्ता को सांस लेने देता है। आउटपुट "एनिमेटेड मास्क" से हटकर वास्तविक ऑन-कैमरा डिलीवरी से मिलता-जुलता है।
यह अंतर सबसे अधिक भावनात्मक सामग्री पर दिखता है। कोई भी अवतार मॉडल एक सपाट वर्णन से बच सकता है, लेकिन हार्दिक बधाई, एक उत्साही पिच या एक गाई हुई पंक्ति ही वह जगह है जहां यह अपना नाम कमाता है। आपकी रिकॉर्डिंग में जो भी भावना हो, स्क्रीन पर मौजूद चेहरा उसे पकड़ लेता है और चला देता है।
इनपुट, प्रारूप और कठिन सीमा
सामग्रियां परिचित हैं: JPEG, PNG या वेबपी के रूप में एक पोर्ट्रेट, और एमपी3, डब्ल्यूएवी, एएसी, ओजीजी या एम4ए के रूप में एक वॉयस ट्रैक, प्रत्येक की सीमा 10 MB है। रिकॉर्डिंग 15 सेकंड से कम समय तक रहनी चाहिए - और यदि आपकी रिकॉर्डिंग खत्म हो जाती है, तो जेनरेशन फॉर्म का अपना ट्रिमर होता है, इसलिए सही टुकड़े को अलग करने में कुछ सेकंड लगते हैं, ऑडियो संपादक की यात्रा नहीं।
ऐसी छवि चुनें जिसमें चेहरा और मुंह स्पष्ट रूप से दिखाई दे, लेकिन स्टूडियो हेडशॉट तक ही सीमित महसूस न करें: कैज़ुअल तस्वीरें और शैलीबद्ध कलाकृतियाँ भी प्रभावशाली ढंग से सजीव होती हैं। तैयार वीडियो आपकी पीढ़ी के इतिहास में आते हैं, जहां आप टेक डाउनलोड कर सकते हैं, संस्करणों की तुलना कर सकते हैं, या एक अलग पोर्ट्रेट के खिलाफ एक ही ट्रैक चला सकते हैं।
सबसे अभिव्यंजक परिणाम प्राप्त करना
जो लीवर सबसे अधिक मायने रखता है वह फोटो नहीं है - यह रिकॉर्डिंग है। लाइन को वैसे ही निष्पादित करें जैसे आप कैमरे पर करेंगे: वास्तविक विराम, वास्तविक जोर, वास्तविक अनुभूति। एक मोनोटोन रीडिंग एक मोनोटोन चरित्र का निर्माण करती है, क्योंकि मॉडल जो कुछ भी सुनता है उसे ईमानदारी से प्रतिबिंबित करता है। दो या तीन डिलीवरी रिकॉर्ड करना और उन सभी को तैयार करना, जो गाता है उसे ढूंढने का एक सस्ता तरीका है।
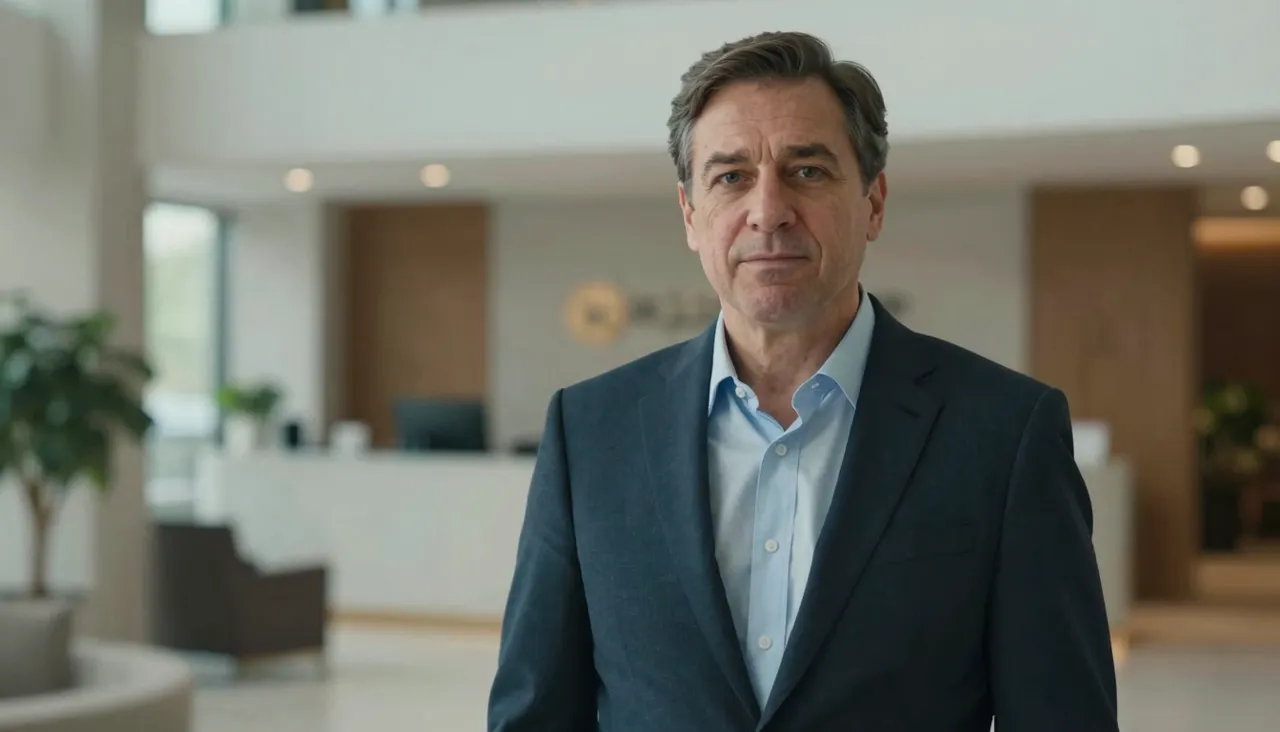
छवि के लिए, नियम श्वास कक्ष है। किनारे से किनारे तक कटा हुआ चेहरा सिर की गति को प्रकट करने के लिए कोई जगह नहीं छोड़ता है। सिर के चारों ओर हवा के साथ एक चेस्ट-अप फ़्रेमिंग मॉडल को छोटे झुकाव और मोड़ के लिए जगह देती है जो चलती कटआउट के बजाय एक जीवित व्यक्ति का भ्रम पैदा करती है।
परिदृश्य जहां यह चमकता है
जब करिश्मा उपलब्ध हो तो इसके लिए पहुंचें। एक प्रोमो जहां एक पात्र वास्तव में बिक्री का प्रचार करता है। एक संग्रहालय गाइड या स्कूल प्रोजेक्ट के लिए अपनी कहानी बताने वाला एक ऐतिहासिक चित्र। ट्रैक की शुरुआती पंक्ति गाते हुए एक कवर-आर्ट चित्रण। इनमें से प्रत्येक भावनात्मक एनीमेशन पर जीता या मरता है, जो वास्तव में यहाँ की विशेषता है।
लघु ऊर्ध्वाधर वीडियो अपने उल्लेख के योग्य है: आपको एक दर्शक को बांधने के लिए कुछ सेकंड मिलते हैं, और एक अभिव्यंजक मानवीय चेहरा उस काम में ऑन-स्क्रीन कैप्शन को हरा देता है। 15 सेकंड से कम की ऑडियो सीमा प्रारूप से पूरी तरह मेल खाती है - एक हुक लाइन वैसे भी इतनी लंबी होती है।
OmniHuman या कोई अन्य उपकरण: एक त्वरित मार्गदर्शिका
यह साइट Kling एआई अवतार भी प्रदान करती है, जो मानक और प्रो गुणवत्ता स्तरों के साथ एक पड़ोसी फोटो-प्लस-ऑडियो मॉडल है। सामान्य नियम: अधिकतम रिज़ॉल्यूशन वाले एक सधे हुए, कॉर्पोरेट शैली के प्रस्तुतकर्ता के लिए, उसे आज़माएँ; जीवंतता, भावना और व्यक्तित्व के लिए, OmniHuman 1.5 से प्रारंभ करें। दोनों समान इनपुट लेते हैं, इसलिए प्रत्येक के माध्यम से अपनी फ़ाइलों को चलाने और मजबूत टेक को बनाए रखने में थोड़े से संतुलन के अलावा कुछ भी खर्च नहीं होता है।
यदि आपका वास्तविक लक्ष्य स्थिर फुटेज को एनिमेट करने के बजाय मौजूदा फुटेज को फिर से आवाज देना है, तो Volcengine लिप सिंक सही उपकरण है - यह नए ऑडियो से मिलान करने के लिए वीडियो में मुंह को फिर से लिखता है। और फुल-बॉडी एक्शन वाले स्क्रिप्टेड दृश्यों के लिए, सामान्य वीडियो मॉडल जैसे Kling 3.0 लागू होते हैं; बात करने वाले अवतार क्लोज़-अप और भाषण में विशेषज्ञ हैं।
अक्सर पूछे जाने वाले सवाल
क्या यह केवल वास्तविक तस्वीरों के साथ ही काम करता है?
नहीं - चित्र और शैलीबद्ध चित्र भी सजीव होते हैं, बशर्ते चेहरा स्पष्ट रूप से पढ़ने योग्य हो। मॉडल आंखों और मुंह के आसपास अभिव्यक्ति और अभिव्यक्ति बनाता है, इसलिए स्रोत छवि में उन विशेषताओं को अलग होना आवश्यक है।
मेरा अवतार सख्त हो गया. क्या गलत हो गया?
लगभग निश्चित रूप से रिकॉर्डिंग। मॉडल आवाज की ऊर्जा को प्रतिबिंबित करता है, इसलिए एक सपाट पढ़ने से एक सपाट चेहरा मिलता है। वास्तविक स्वर, ठहराव और जोर के साथ पंक्ति को दोबारा रिकॉर्ड करें और इसके साथ ही चरित्र की अभिव्यक्ति बढ़ जाती है।
मैं 15 सेकंड से अधिक लंबी कोई चीज़ कैसे बना सकता हूँ?
प्रत्येक पीढ़ी को 15 सेकंड से कम के ऑडियो की आवश्यकता होती है, इसलिए लंबे भाषण को टुकड़ों में विभाजित करें, प्रत्येक को समान पोर्ट्रेट के साथ बनाएं, और क्लिप को किसी भी वीडियो संपादक में जोड़ें। स्थिर पृष्ठभूमि के साथ, कटौती मुश्किल से ध्यान देने योग्य होती है।