HappyHorse Referință la video: creați scene video AI din până la 9 imagini
Bottom Line Up Front (BLUF): HappyHorse Reference-to-Video este un generator video AI care funcționează dintr-un set întreg de imagini în loc de unul singur. Încărcați până la nouă imagini de referință și descrieți în text cum se combină: un personaj dintr-o fotografie, o ținută din alta, o locație dintr-o a treia - modelul le îmbină într-un clip coerent.
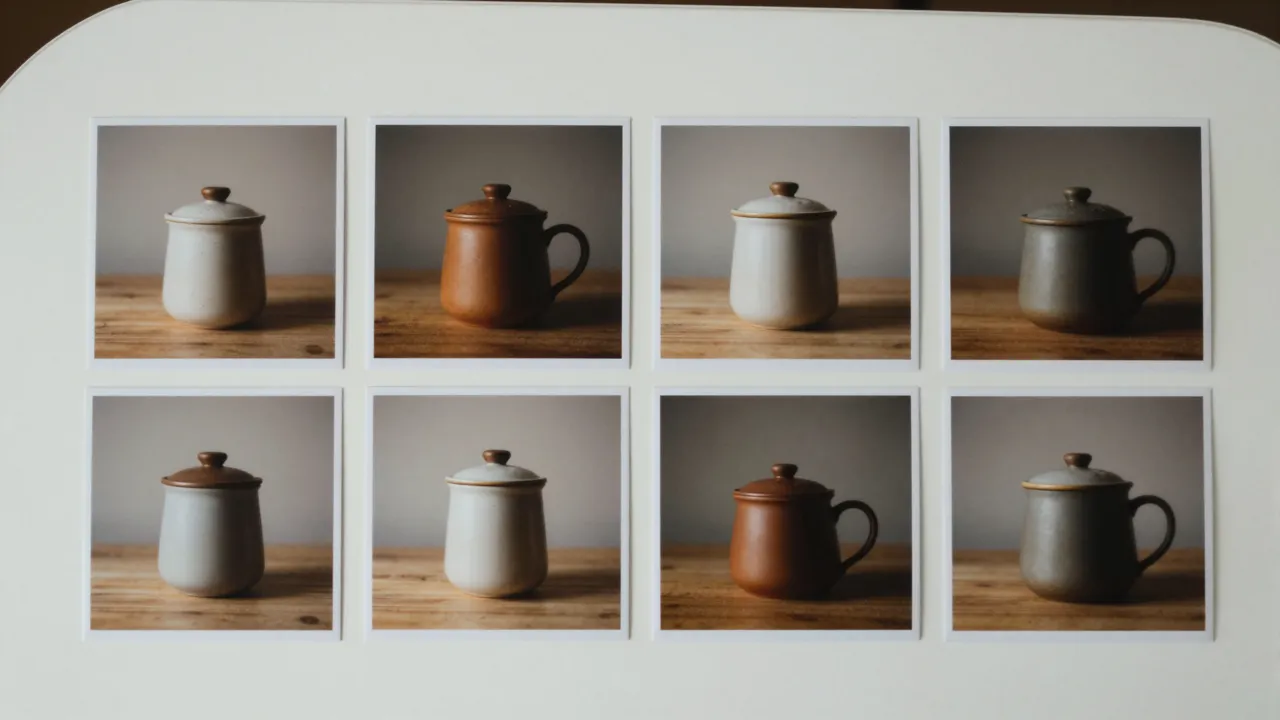
Compunerea unei scene din mai multe imagini
Caracteristica definitorie a acestui mod este până la nouă referințe pe generație. Fiecare imagine joacă un rol în viitorul clip: eroul, un al doilea personaj, o recuzită, o locație, o mostră de stil. Solicitarea dvs. explică cine este cine și ce se întâmplă: „omul din prima fotografie stă în cafenea din a treia fotografie, ținând cana din a doua”.
Aceasta rezolvă o problemă pe care nu o poate atinge imaginea-video: punerea lucrurilor într-un singur cadru care nu au fost niciodată fotografiate împreună. Un produs și un model din filmări diferite, un personaj pe un fundal pictat, doi eroi din sesiuni separate — toți ajung în aceeași scenă fără nicio compunere manuală.
Cum vă citește modelul referințele
Rețeaua nu lipește fotografiile dvs. în cadru. Le studiază — aspectul personajului, forma obiectului, paleta locației — și redesenează totul în mișcare. Acesta este motivul pentru care eroul se poate întoarce, merge și ridica lucruri în timp ce rămâne ușor de recunoscut. Cu cât referința este mai curată și cu atât mai puțină dezordine în jurul subiectului, cu atât transferul este mai fidel.
Ajutați-l cu cuvinte: atribuiți roluri în mod explicit și descrieți relațiile. „Femeia din imaginea 1, care poartă jacheta din imaginea 2, merge pe stradă din imaginea 3” funcționează mult mai bine decât un vag „fă un filmuleț frumos din pozele astea”. Voi definiți castingul; modelul trebuie doar să aducă la viață scena.
Formate de cadre de la povești la ecran lat
Spre deosebire de modul o singură fotografie, raportul de aspect este alegerea dvs.: ecran lat 16:9, vertical 9:16 și 3:4, pătrat 1:1 și clasic 4:3. Același set de referințe poate deveni un clip vertical de poveste și un video banner larg pentru un site web - trebuie doar să schimbați formatul și să rulați din nou.
Durata variază de la 3 la 15 secunde, cu ieșire 720p sau 1080p. Ciorne scurte ieftine la 720p sunt perfecte pentru a explora idei; salvați randamentul 1080p mai lung pentru versiunea finală. Câmpul de semințe vă permite să blocați o compoziție care vă place și să variați doar formularea.
Cazuri de utilizare: reclame, personaje recurente, cataloage
Cel mai profitabil scenariu este seria video cu un caracter persistent: o mascota de brand, un erou de benzi desenate, un prezentator virtual. Introduceți aceleași imagini de personaj în fiecare generație și obțineți o serie de clipuri în care eroul rămâne același. Pentru magazine, este o modalitate de a arăta un produs „în viața reală” prin asocierea fotografiei acestuia cu o fotografie interioară.
Strălucește și în munca de creație: construiește o scenă de basm din desenul unui copil și fotografia acestuia, aruncă un animal de companie într-o lume ilustrată, combină o schiță de costum cu un model real. Tot ceea ce obișnuia necesita colaje și retușare manuală se întâmplă într-o singură generație.
Alegerea unui set de referință care funcționează
Nu vă grăbiți să umpleți toate cele nouă sloturi. Cu cât adăugați mai multe imagini, cu atât este mai greu pentru model să decidă ce contează. Începeți cu două sau trei referințe cheie — erou, obiect, fundal — și adăugați mai multe numai atunci când clipului îi lipsește în mod clar un anumit detaliu. Fiecare imagine suplimentară diluează atenția rețelei.
Atenție la compatibilitate: un personaj fotografiat în lumina zilei pe o stradă de noapte cu neon obligă modelul să improvizeze, iar cusăturile încep să se arate. Referințele cu iluminare similară și o gamă apropiată de culori produc o imagine unificată care pare credibilă încă de la primul cadru.
Întrebări frecvente
Câte imagini de referință pot încărca?
De la unu la nouă pe generație. Două sau trei referințe cheie - erou, recuzită, fundal - sunt cel mai bun punct de plecare. Adăugați mai multe doar atunci când știți exact de ce detaliu al scenei este responsabilă fiecare nouă imagine.
Persoana din referința mea va rămâne recunoscută?
Modelul lucrează din greu pentru a păstra identitatea și, de obicei, asemănarea este bună, dar aceasta este o generație nouă, nu o copie a fotografiei. Un portret de prim-plan clar, fără alte persoane în cadru, plus o instrucțiune explicită de a păstra aspectul, îmbunătățește potrivirea.
Prin ce diferă acest lucru de imaginea-video obișnuită?
Obișnuit imagine-to-video animă o imagine și își păstrează compoziția. Aici aduci mai multe imagini sursă, iar modelul construiește o scenă nou-nouță din descrierea ta. Alegeți acest mod atunci când fotografia exactă de care aveți nevoie pur și simplu nu există.