VEO 3.1 Referens till video: ditt objekt, nya scener
Bottom Line Up Front (BLUF): VEO 3.1 Reference To Video är ett AI-videoläge där dina bilder leder och texten följer. Ladda upp en till tre referensbilder — en produkt, en karaktär, en stil — och beskriv vad som ska hända med dem. Modellen bär ditt igenkännbara föremål till en helt ny scen istället för att uppfinna en slumpmässig stand-in.
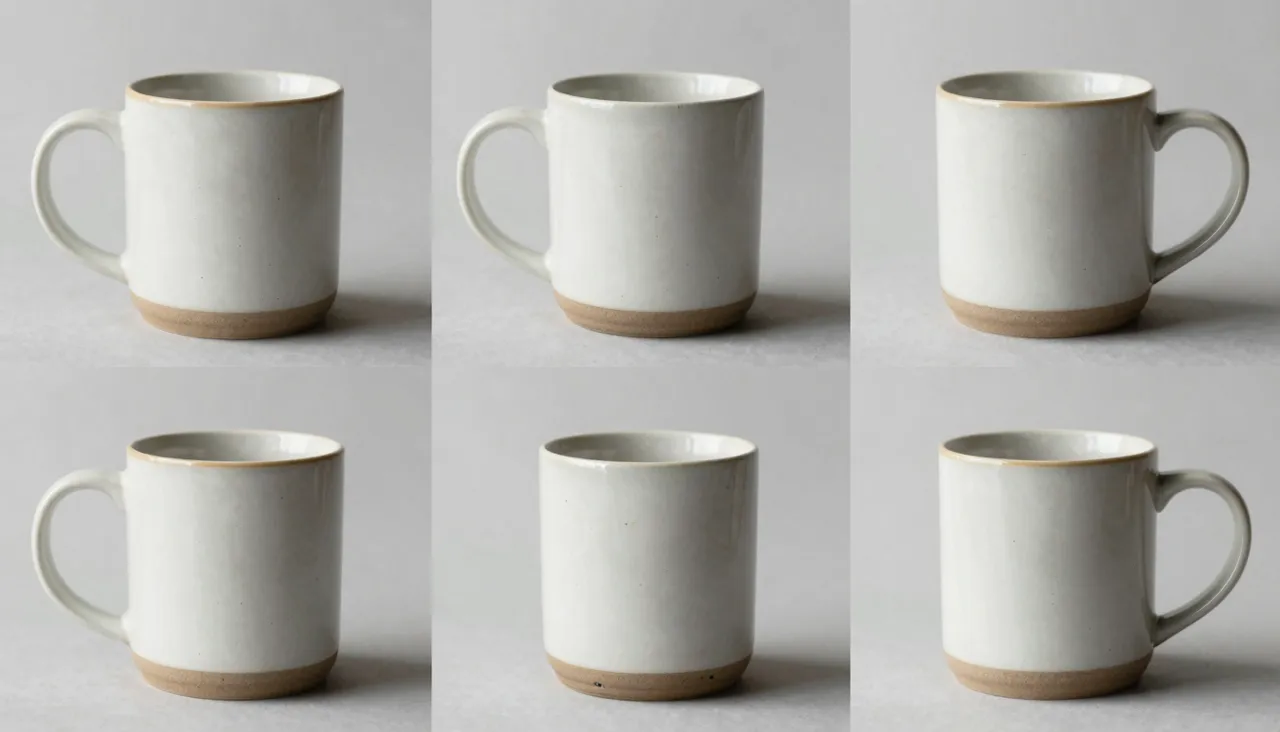
Vad hänvisning till video betyder
En vanlig generation uppfinner ramen på nytt varje gång: be om en sneaker på en löparidrottare så får du en sneaker, aldrig din. Referensläget fixar precis det. Du visar modellen ett specifikt objekt över en till tre bilder, och det objektet är det som visas i det färdiga klippet.
Referenser är inte öppnande eller stängande ramar – de är exempel. Modellen studerar hur ditt föremål eller karaktär ser ut, och skjuter sedan en ny scen runt den baserat på din text. Minst en bild är obligatorisk; läget startar helt enkelt inte utan referenser.
Hur det skiljer sig från bild till video
I klassisk bild-till-video blir bilden den första bildrutan, och handlingen växer ur den - samma komposition, samma vinkel. Referensläget är friare: scenen byggs från grunden enligt din uppmaning, medan bilderna bara dikterar hur deltagarna ska se ut.
De två lägena passar olika jobb. Att väcka ett specifikt foto till liv hör till standarden VEO 3.1. Att visa din produkt i inställningar där den aldrig fotograferades, eller gå en karaktär genom en serie olika klipp — det är vad Reference To Video finns för.
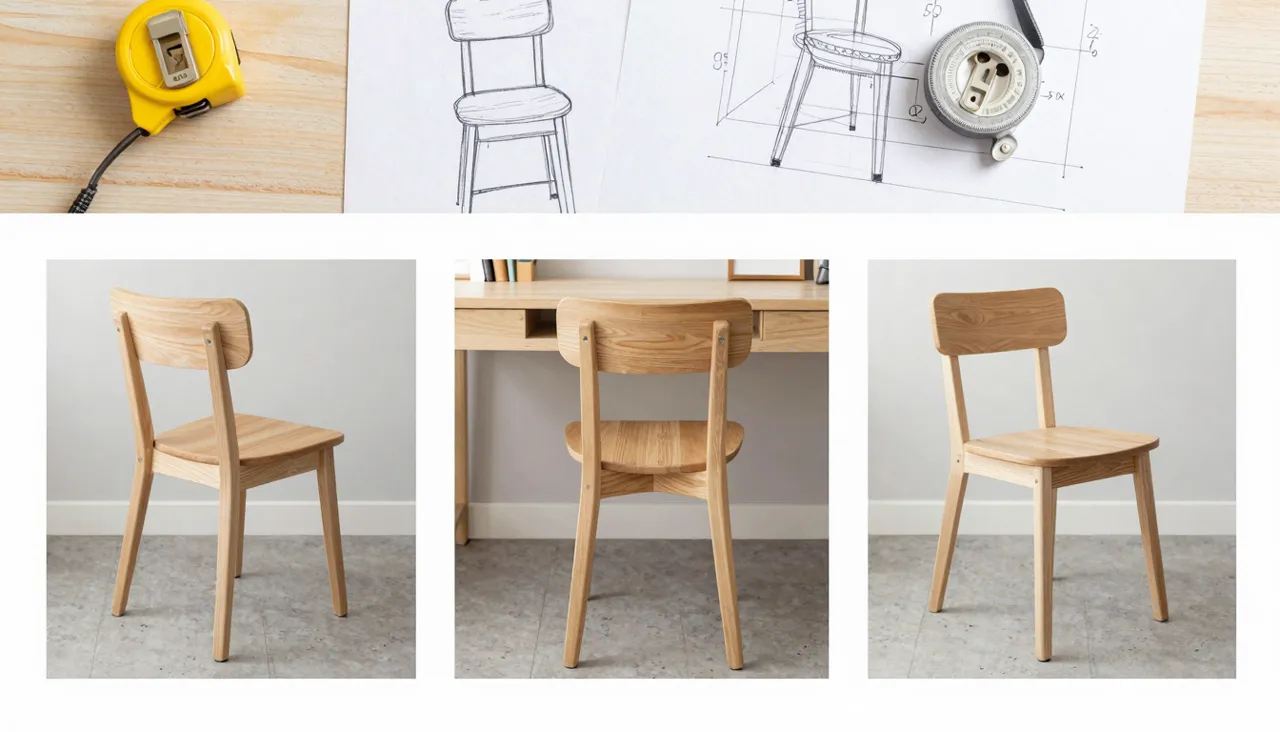
Välja referenser som fungerar
Regeln är enkel: modellen måste se föremålet tydligt. Använd skarpa bilder där motivet fyller en bra del av ramen, utan visuellt skräp runt det. För objekt med komplexa former hjälper två eller tre vinklar modellen att förstå volymen snarare än bara framifrån.
Hoppa över att beskriva vad referenserna redan visar i uppmaningen – beskriv scenen och handlingen istället: var objektet är, vad omger det, hur kameran rör sig, hur ljuset är. Ramformatet ställs in i alternativen: 16:9 liggande, 9:16 stående eller Auto.
Snabbläge och prissättning
Referensgenerering körs uteslutande på snabbnivån - Lite och kvalitet kan inte väljas här, och formuläret snäpps tillbaka till Snabbt om du försöker. I praktiken är det en fördel: renderingarna kommer snabbt tillbaka, så att du kan cykla igenom flera scenidéer med samma referensuppsättning i en sittning.
Kostnaden för ett klipp beror på genereringsparametrar och betalas från det platsomfattande tokensaldot. Misslyckade eller vägrade generationer kostar ingenting. Standard VEO innehållsregler gäller: inga barn i ram, inget djurplågeri, inget vuxenmaterial.
Där läget lyser
Det första stora användningsfallet är e-handel: med en handfull produktfoton kan du ta klipp för listor, annonser och sociala inlägg utan att hyra en studio. En såsflaska på en sommarpicknick, sneakers på en stadsrundtur, en ansiktskräm på en badrumshylla i marmor – allt från samma tre referenser.
Det andra är serieinnehåll med en återkommande hjälte: en varumärkesmaskot, en karaktär från dina illustrationer, ett signaturobjekt. Förbered referenserna en gång och du får en hel rad med videor där hjälten håller sig konsekvent från klipp till klipp. Resultaten lagras i historiken, redo att laddas ned eller utökas.
Vanliga frågor
Hur många referensbilder kan jag ladda upp?
Mellan ett och tre, och minst en krävs — läget startar inte utan referenser. För objekt med komplexa former hjälper modellen att fånga formen korrekt genom att tillhandahålla två eller tre vinklar.
Varför kan jag inte välja kvalitetsnivån?
Referens till video körs endast på Fast; det är en teknisk begränsning av läget, och formuläret återställer alla andra val till Snabb. Uppsidan är snabba renderingar och billig iteration av scenidéer.
Kommer objektet att matcha mina bilder exakt?
Modellen håller objektet igenkännligt, men det här är generering, inte kopiering - små detaljer kan glida. Rena referenser från flera vinklar förbättrar noggrannheten, och en off take kan helt enkelt återskapas.