VEO 3.1 비디오 참조: 개체, 새로운 장면
Bottom Line Up Front (BLUF): VEO 3.1 비디오 참조는 이미지가 먼저 나오고 텍스트가 따라오는 AI 비디오 모드입니다. 제품, 캐릭터, 스타일 등 1~3개의 참조 사진을 업로드하고 해당 사진으로 어떤 일이 일어날지 설명하세요. 이 모델은 임의의 스탠드인을 만드는 대신 인식 가능한 개체를 새로운 장면으로 전달합니다.
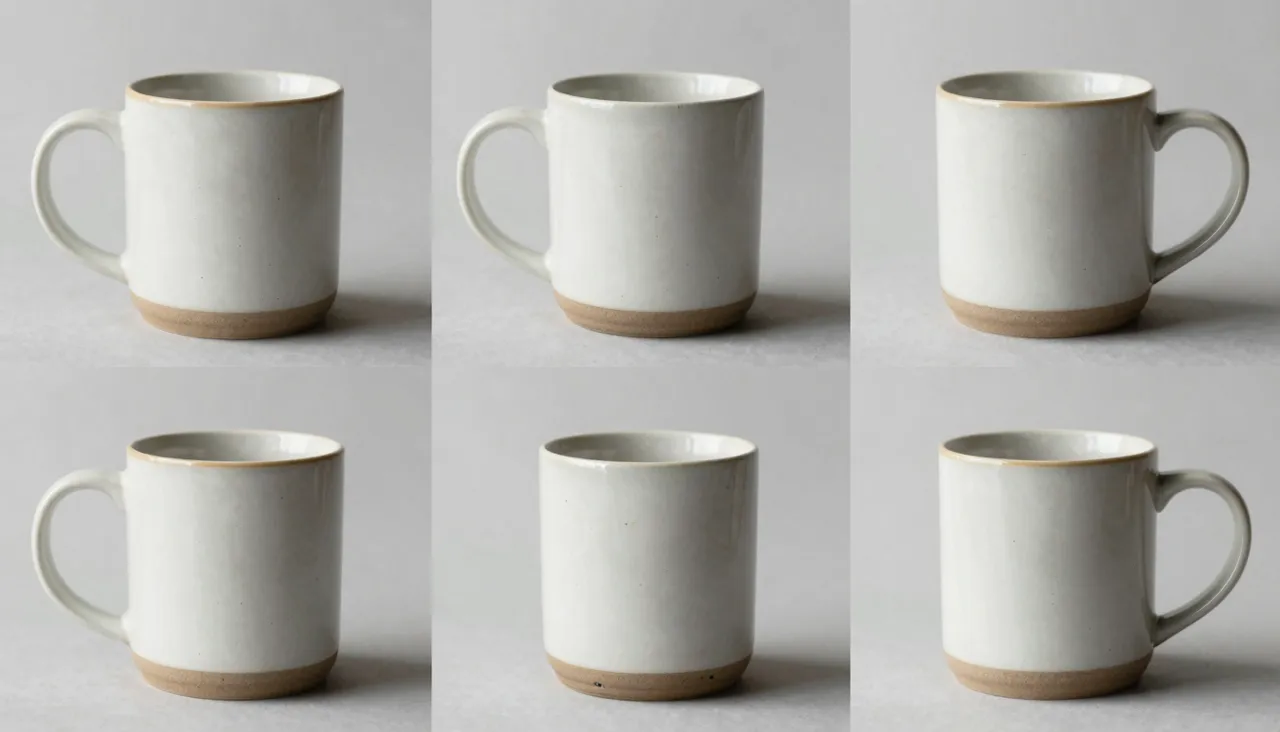
비디오 참조의 의미
일반 세대는 매번 프레임을 재창조합니다. 달리는 운동선수에게 운동화를 요청하면 운동화를 사지만 결코 당신의 것은 아닙니다. 레퍼런스 모드는 이를 정확하게 수정합니다. 1~3개의 이미지에 걸쳐 모델에 특정 개체를 표시하면 해당 개체가 완성된 클립에 나타납니다.
참조는 프레임을 열거나 닫는 것이 아니라 예시입니다. 모델은 아이템이나 캐릭터의 모양을 연구한 다음 텍스트를 기반으로 주변의 새로운 장면을 촬영합니다. 하나 이상의 이미지가 필수입니다. 모드는 참조 없이는 시작되지 않습니다.
이미지와 비디오의 차이점
전통적인 이미지-비디오에서는 사진이 첫 번째 프레임이 되고, 동일한 구성, 동일한 각도에서 동작이 확장됩니다. 참조 모드는 더욱 자유로워졌습니다. 장면은 프롬프트에 따라 처음부터 만들어지는 반면, 이미지는 참가자의 모습만 지시합니다.
두 가지 모드는 서로 다른 작업에 적합합니다. 특정 사진 한 장을 생생하게 표현하는 것은 표준 VEO 3.1에 속합니다. 사진을 찍지 않은 환경에서 제품을 보여주거나 일련의 다른 클립을 통해 한 캐릭터를 걷는 것, 이것이 바로 Reference To Video가 존재하는 이유입니다.
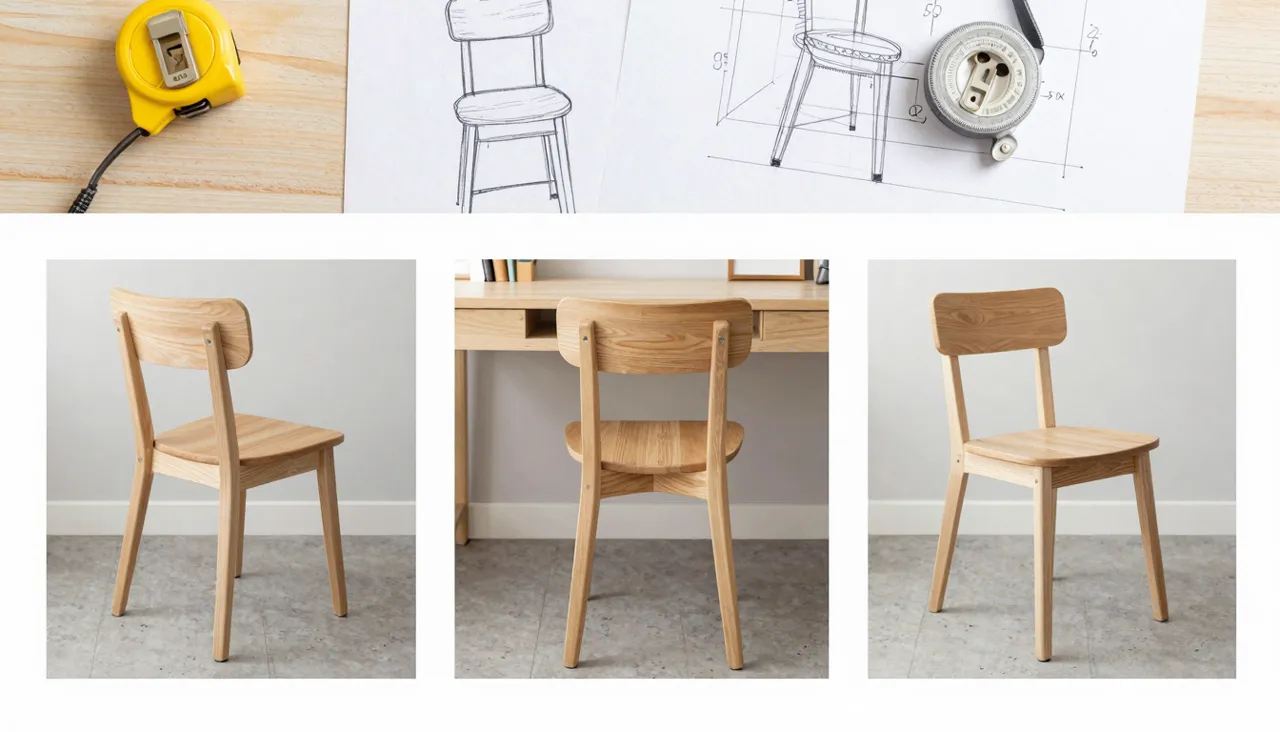
효과적인 참고자료 선택
규칙은 간단합니다. 모델은 물체를 명확하게 볼 수 있어야 합니다. 피사체가 프레임의 상당 부분을 채우고 주변이 시각적으로 어수선하지 않은 선명한 이미지를 사용하십시오. 복잡한 모양을 가진 물체의 경우 두 개 또는 세 개의 각도가 모델이 정면 보기보다 볼륨을 파악하는 데 도움이 됩니다.
프롬프트에서는 참조가 이미 보여주고 있는 내용을 설명하는 것을 건너뛰고 대신 장면과 동작을 설명하세요. 즉, 물체가 어디에 있는지, 주변에 무엇이 있는지, 카메라가 어떻게 움직이는지, 빛이 어떤지 등을 설명하세요. 프레임 형식은 16:9 가로, 9:16 세로 또는 자동 옵션에서 설정됩니다.
빠른 전용 모드 및 가격
참조 생성은 Fast 계층에서만 실행됩니다. Lite 및 Quality는 여기에서 선택할 수 없으며 시도하면 양식이 Fast로 다시 돌아갑니다. 실제로는 이것이 장점입니다. 렌더가 빠르게 반환되므로 동일한 참조 세트를 사용하여 한 번에 여러 장면 아이디어를 순환할 수 있습니다.
클립 비용은 생성 매개변수에 따라 다르며 사이트 전체 토큰 잔액에서 지불됩니다. 실패하거나 거부된 세대에는 비용이 들지 않습니다. 표준 VEO 콘텐츠 규칙이 적용됩니다. 프레임 안에 어린이가 없고, 동물 학대가 없고, 성인용 콘텐츠가 없습니다.
모드가 빛나는 곳
첫 번째 큰 사용 사례는 전자 상거래입니다. 몇 장의 제품 사진만 있으면 스튜디오를 임대하지 않고도 목록, 광고, 소셜 게시물용 클립을 촬영할 수 있습니다. 여름 소풍의 소스병, 시내 달리기의 운동화, 대리석 욕실 선반 위의 페이스 크림 - 모두 세 가지 레퍼런스에서 나온 것입니다.
두 번째는 반복되는 영웅, 즉 브랜드 마스코트, 일러스트레이션의 캐릭터, 시그니처 개체가 포함된 연속 콘텐츠입니다. 참조를 한 번 준비하면 영웅이 클립마다 일관성을 유지하는 전체 비디오 라인을 얻을 수 있습니다. 결과는 기록에 저장되어 다운로드하거나 확장할 수 있습니다.
자주 묻는 질문
참조 이미지는 몇 개까지 업로드할 수 있나요?
1~3개 중 하나 이상이 필요합니다. 참조가 없으면 모드가 시작되지 않습니다. 모양이 복잡한 물체의 경우 두 개 또는 세 개의 각도를 제공하면 모델이 형태를 정확하게 포착하는 데 도움이 됩니다.
품질 등급을 선택할 수 없는 이유는 무엇입니까?
비디오 참조는 Fast에서만 실행됩니다. 이는 모드의 기술적 제약이며 양식은 다른 선택 사항을 다시 Fast로 재설정합니다. 장점은 빠른 렌더링과 장면 아이디어에 대한 저렴한 반복입니다.
물체가 내 사진과 정확히 일치합니까?
모델은 객체를 인식할 수 있도록 유지하지만 이는 복사가 아닌 생성입니다. 작은 세부 사항이 떠다닐 수 있습니다. 여러 각도에서 깔끔한 참조를 하면 정확도가 향상되고 오프 테이크를 간단히 다시 생성할 수 있습니다.