Kling O1 bild-till-video: förvandla ett stillbild till rörligt material
Bottom Line Up Front (BLUF): Kling O1 Image-to-Video är en AI-videogenerator som animerar ett enda fotografi. Ladda upp en bild, skriv valfritt vad som ska hända i ramen, och modellen producerar ett kort klipp där stillbilden blir levande: en person blinkar och ler, vattnet skvalpar, kameran driver närmare. Inget redigeringsprogram, inga nyckelbilder – bara ett foto och en mening.
Hur foto-till-video-generering fungerar här
Börja med en bild. Släpp det i generationsformuläret, lägg till en kort rörelseuppmaning som "mannen vänder sig mot kameran och skrattar" eller "snön faller försiktigt över gatan" och kör jobbet. AI:n uppfinner de mellanliggande bildrutorna samtidigt som ansiktet, kläderna och bakgrunden hålls trogna din originalbild. Ju tydligare handlingsbeskrivningen är, desto närmare matchar resultatet det du föreställt dig.
Du kan också hoppa över uppmaningen helt och låta modellen bestämma hur scenen ska röra sig - ett bra sätt att utforska vad en bild kan. Varje färdigt klipp hamnar i din generationshistoria, där du kan ladda ner det, utöka det, ta den sista bildrutan eller köra samma foto igen med en skarpare uppmaning.
Ett foto eller två: att välja rätt läge
Denna modell accepterar upp till två bilder. Med ett enda foto väljer du mellan 5-sekunders och 10-sekunders klipp, och rörelsen utspelas framåt från den ramen. Lägg till en andra bild och varaktighetsintervallet öppnas upp till allt från 3 till 10 sekunder, eftersom generationen nu färdas mellan två ankarpunkter istället för att driva fritt.
Tvåbildsläget lyser när slutet är viktigt. Visa en produkt förpackad i den första ramen och färdigmonterad i den andra, och AI:n uppfinner en smidig transformation mellan dem. Det ger dig mycket mer kontroll över finalen än någon textuppmaning skulle kunna - du ger modellen bokstavligen dess destination.
Vilka bilder animerar bäst
Rena, väl upplysta bilder med ett uppenbart motiv fungerar bäst: ett porträtt, en produkt på en vanlig bakgrund, ett landskap, ett husdjur. Upptagna scener med folkmassor, liten text eller komplexa reflektioner ger nätverket för mycket att spåra på en gång, och fel smyger sig in när saker och ting rör sig. Om du är osäker, förenkla ramen innan du laddar upp.
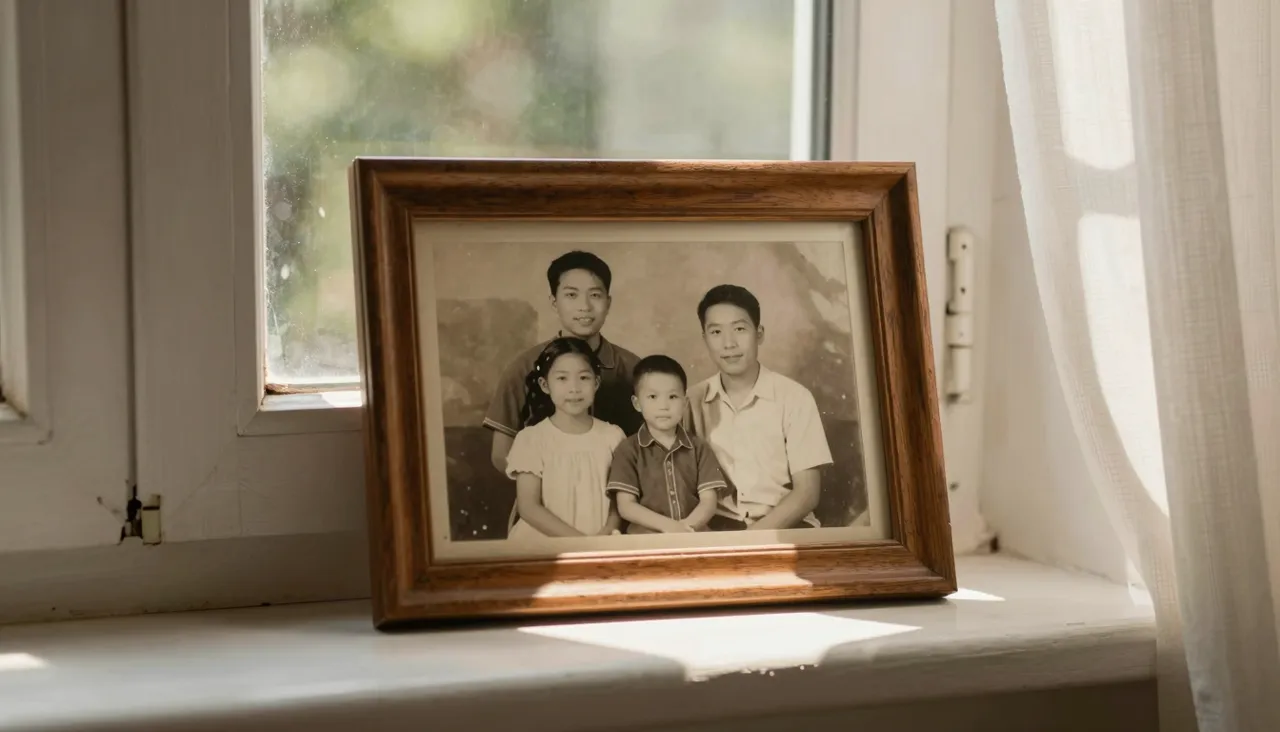
Vintage familjefoton är ett underbart användningsfall. Skanna ett gammalt tryck, ladda upp det och be om subtila rörelser - en blinkning, ett mjukt leende, hår som rör sig i en bris. Resultatet känns mycket mer personligt än något bildspel, och det tar några minuter. Håll bara den begärda rörelsen försiktig; Arkivbilder överlever sällan dramatisk action graciöst.
Praktiska användningsområden för animerade bilder
Vanliga jobb inkluderar berättelseomslag byggda från en vanlig selfie, levande bakgrunder för presentationer, animerade evenemangsaffischer och produktlistor som fångar ögat när shoppare rullar förbi. Överallt där en statisk bild känns platt, får några sekunders rörelse uppmärksamhet – och det är precis den nisch som detta verktyg fyller.
Avancerade användare behandlar varje klipp som en byggsten. Skapa en scen, dra ut dess sista bildruta, mata in den bilden igen med en ny uppmaning och fortsätt handlingen. Kedjat samman växer ett fotografi till en längre, sammanhängande sekvens där varje segment tar upp exakt där det föregående stannade.
Vanliga misstag att undvika
Den största är att överbelasta ett kort klipp med plot: "hon står upp, går över rummet, vänder sig om och vinkar" kommer helt enkelt inte att passa, så AI improviserar och resultatet glider ur kurs. Begär en eller två enkla åtgärder per generation och bygg längre berättelser genom kedja istället.
Suddiga eller mörka källfoton är den andra fällan. Modellen animerar din bild; den reparerar den inte, så en brusig ingång blir en brusig video. Slutligen, skriv uppmaningar om rörelse, inte utseende - nätverket ser redan hur personen ser ut, det behöver bara veta vad de ska göra.
Vanliga frågor
Måste jag skriva en uppmaning med mitt foto?
Nej. Lämna det tomt och modellen väljer en naturlig rörelse på egen hand. En uppmaning är värd att lägga till när du vill ha något specifikt - en viss gest, en kamerarörelse, en stämning - eftersom en enda tydlig mening styr resultatet märkbart.
Vad är poängen med att ladda upp en andra bild?
Två bilder definierar början och slutet av klippet, och AI:n bygger resan mellan dem. Det är det mest pålitliga sättet att kontrollera hur en video avslutas, och den låser också upp ett bredare intervall av varaktigheter, från 3 till 10 sekunder.
Ansiktet skev under rörelse — hur fixar jag det?
Använd ett skarpare, närmare beskuret källfoto och be om lugnare rörelser; snabba huvudsvängar är den vanliga boven. Att köra samma jobb igen hjälper också, eftersom varje generation producerar en lite annorlunda uppfattning.