VEO 3.1 Verweis auf Video: Ihr Objekt, neue Szenen
Bottom Line Up Front (BLUF): VEO 3.1 Reference To Video ist ein KI-Videomodus, bei dem Ihre Bilder vorangehen und der Text folgt. Laden Sie ein bis drei Referenzbilder hoch – ein Produkt, eine Figur, einen Stil – und beschreiben Sie, was damit passieren soll. Das Modell trägt Ihr erkennbares Objekt in eine brandneue Szene, anstatt einen zufälligen Ersatz zu erfinden.
Was der Verweis auf Video bedeutet
Eine normale Generation erfindet den Rahmen jedes Mal neu: Wenn Sie einen Laufsportler nach einem Sneaker fragen, bekommen Sie einen Sneaker, niemals Ihren. Der Referenzmodus behebt genau das. Sie zeigen dem Modell in ein bis drei Bildern ein bestimmtes Objekt, und dieses Objekt erscheint im fertigen Clip.
Referenzen sind keine Eröffnungs- oder Schlussrahmen, sondern Beispiele. Das Modell untersucht, wie Ihr Gegenstand oder Ihre Figur aussieht, und dreht dann basierend auf Ihrem Text eine neue Szene um ihn herum. Mindestens ein Bild ist obligatorisch; Ohne Referenzen startet der Modus einfach nicht.
Wie es sich von Bild zu Video unterscheidet
Bei der klassischen Bild-zu-Video-Bildübertragung wird das Bild zum ersten Bild, und daraus erwächst die Handlung – gleiche Komposition, gleicher Blickwinkel. Der Referenzmodus ist freier: Die Szene wird nach Ihren Vorgaben von Grund auf neu erstellt, während die Bilder lediglich vorgeben, wie die Teilnehmer aussehen sollen.
Die beiden Modi eignen sich für unterschiedliche Aufgaben. Ein bestimmtes Foto zum Leben zu erwecken gehört zum Standard VEO 3.1. Ihr Produkt in Umgebungen zu zeigen, in denen es noch nie fotografiert wurde, oder eine Figur durch eine Reihe verschiedener Clips zu führen – dafür gibt es „Reference To Video“.
Referenzen auswählen, die funktionieren
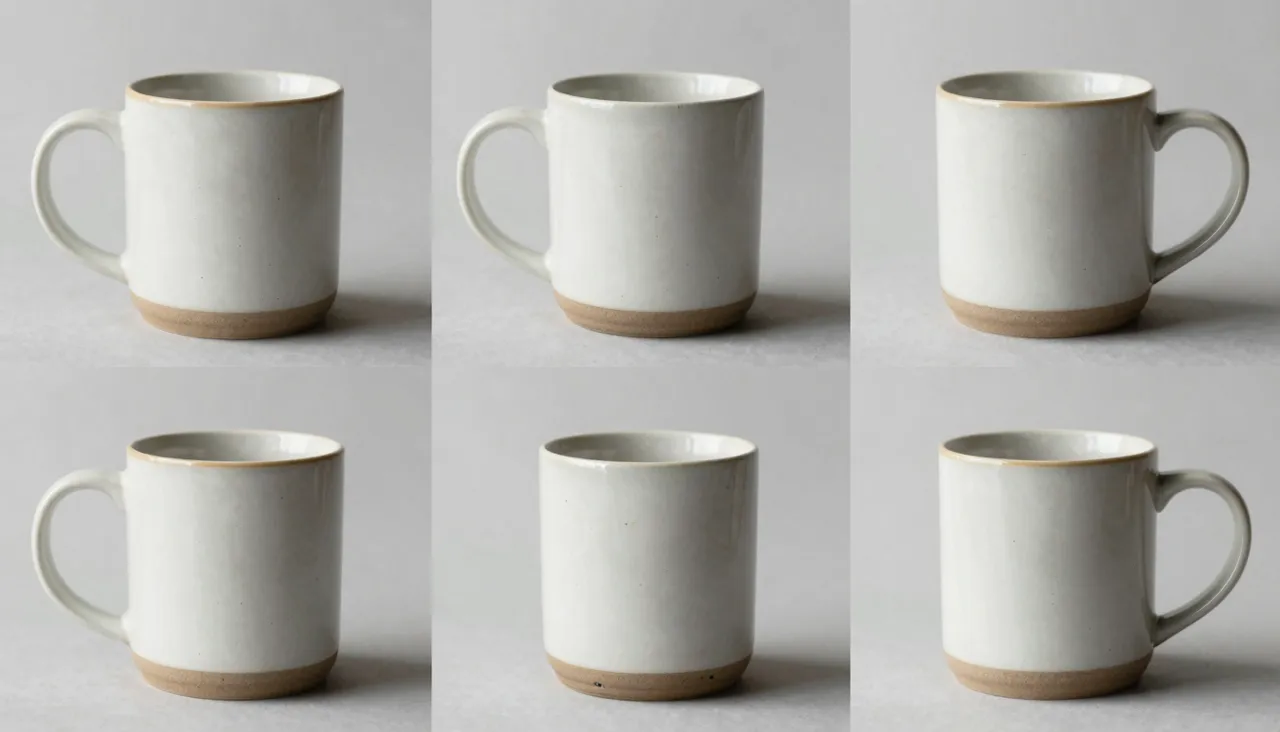
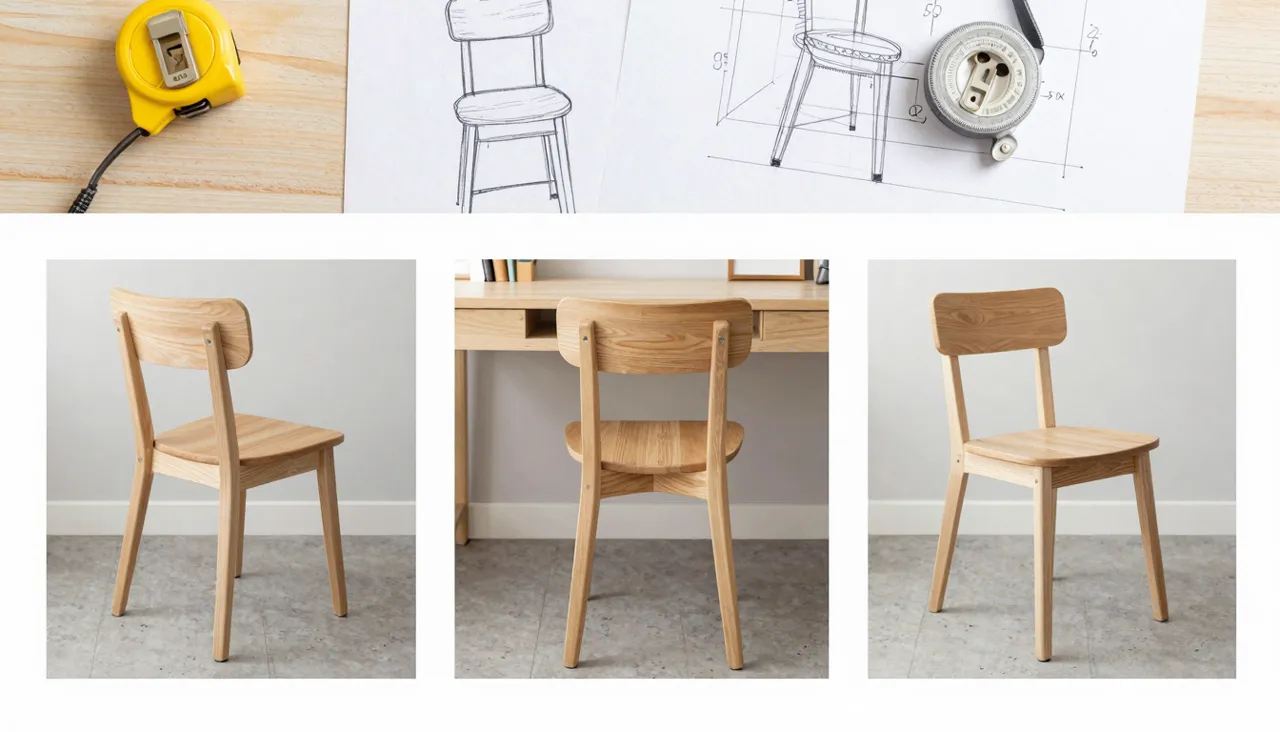
Die Regel ist einfach: Das Modell muss das Objekt klar sehen. Verwenden Sie scharfe Bilder, bei denen das Motiv einen guten Teil des Bildes ausfüllt, ohne dass es optisch durcheinander kommt. Bei Objekten mit komplexen Formen helfen zwei oder drei Winkel dem Modell, das Volumen und nicht nur die Vorderansicht zu erfassen.
Überspringen Sie in der Eingabeaufforderung die Beschreibung dessen, was die Referenzen bereits zeigen – beschreiben Sie stattdessen die Szene und die Aktion: wo sich das Objekt befindet, was es umgibt, wie sich die Kamera bewegt, wie das Licht ist. Das Rahmenformat wird in den Optionen eingestellt: 16:9 Querformat, 9:16 Hochformat oder Auto.
Nur-Fast-Modus und Preise
Die Referenzgenerierung läuft ausschließlich auf der Fast-Stufe – Lite und Quality können hier nicht ausgewählt werden, und das Formular springt zurück auf Fast, wenn Sie es versuchen. In der Praxis ist das ein Vorteil: Die Renderings kommen schnell zurück, sodass Sie mehrere Szenenideen mit demselben Referenzsatz in einer Sitzung durchgehen können.
Die Kosten eines Clips hängen von den Generierungsparametern ab und werden aus dem standortweiten Token-Guthaben bezahlt. Fehlgeschlagene oder verweigerte Generationen kosten nichts. Es gelten die üblichen VEO-Inhaltsregeln: keine Kinder im Bild, keine Tierquälerei, kein Material für Erwachsene.
Wo der Modus glänzt
Der erste große Anwendungsfall ist E-Commerce: Mit einer Handvoll Produktfotos können Sie Clips für Listings, Anzeigen und Social-Media-Beiträge drehen, ohne ein Studio zu mieten. Eine Soßenflasche bei einem Sommerpicknick, Turnschuhe beim Stadtlauf, eine Gesichtscreme auf einem Badezimmerregal aus Marmor – alles aus denselben drei Referenzen.
Beim zweiten handelt es sich um serielle Inhalte mit einem wiederkehrenden Helden: einem Markenmaskottchen, einer Figur aus Ihren Illustrationen, einem charakteristischen Objekt. Bereiten Sie die Referenzen einmal vor und Sie erhalten eine ganze Reihe von Videos, in denen der Held von Clip zu Clip einheitlich bleibt. Die Ergebnisse werden im Verlauf gespeichert und können heruntergeladen oder erweitert werden.
Häufige Fragen
Wie viele Referenzbilder kann ich hochladen?
Zwischen eins und drei, und mindestens eine ist erforderlich – der Modus startet nicht ohne Referenzen. Bei Objekten mit komplexen Formen hilft die Bereitstellung von zwei oder drei Winkeln dabei, dass das Modell die Form genau erfasst.
Warum kann ich die Qualitätsstufe nicht auswählen?
Reference To Video läuft nur auf Fast; Dies ist eine technische Einschränkung des Modus und das Formular setzt alle anderen Optionen auf „Schnell“ zurück. Der Vorteil sind schnelle Renderings und eine kostengünstige Iteration von Szenenideen.
Passt das Objekt genau zu meinen Fotos?
Das Modell sorgt dafür, dass das Objekt erkennbar bleibt, aber es handelt sich hierbei um eine Generierung, nicht um ein Kopieren – kleine Details können abweichen. Saubere Referenzen aus mehreren Winkeln verbessern die Genauigkeit und ein Off-Take kann einfach neu generiert werden.