VEO 3.1 Odniesienie do wideo: Twój obiekt, nowe sceny
Bottom Line Up Front (BLUF): VEO 3.1 Odniesienie do wideo to tryb wideo AI, w którym prowadzą obrazy, a tekst podąża za nimi. Prześlij od jednego do trzech zdjęć referencyjnych — produktu, postaci, stylu — i opisz, co powinno się z nimi stać. Model przenosi rozpoznawalny obiekt w zupełnie nową scenę, zamiast wymyślać przypadkowe zastępstwo.
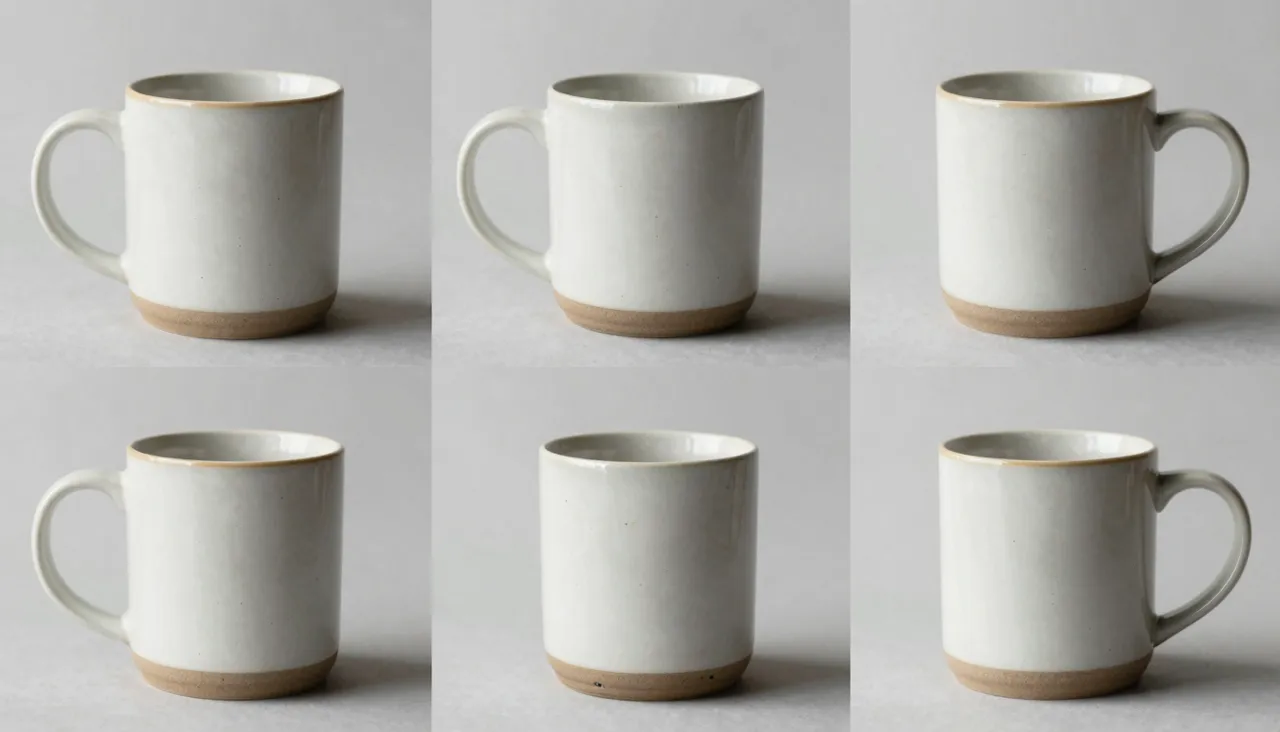
Co oznacza odniesienie do wideo
Zwykłe pokolenie za każdym razem wymyśla nowe ramy: poproś biegającego sportowca o tenisówki, a dostaniesz tenisówki, nigdy swoje. Tryb referencyjny dokładnie to naprawia. Pokazujesz modelowi konkretny obiekt na jednym do trzech obrazów, a obiekt ten pojawia się w gotowym klipie.
Odniesienia nie są ramkami otwierającymi ani zamykającymi — są to przykłady. Model bada, jak wygląda Twój przedmiot lub postać, a następnie kręci wokół niego nową scenę na podstawie Twojego tekstu. Co najmniej jedno zdjęcie jest obowiązkowe; tryb po prostu nie uruchomi się bez odniesień.
Czym różni się od obrazu do wideo
W klasycznym przypadku obrazu na wideo obraz staje się pierwszą klatką, z której wyrasta akcja — ta sama kompozycja, ten sam kąt. Tryb referencyjny jest bardziej swobodny: scena jest budowana od podstaw zgodnie z Twoimi podpowiedziami, a obrazy jedynie dyktują, jak powinni wyglądać jej uczestnicy.
Obydwa tryby odpowiadają różnym zadaniom. Ożywienie jednego konkretnego zdjęcia należy do standardu VEO 3.1. Pokazywanie produktu w miejscach, w których nigdy nie był fotografowany, lub oprowadzanie jednej postaci po serii różnych klipów — po to właśnie istnieje Reference To Video.
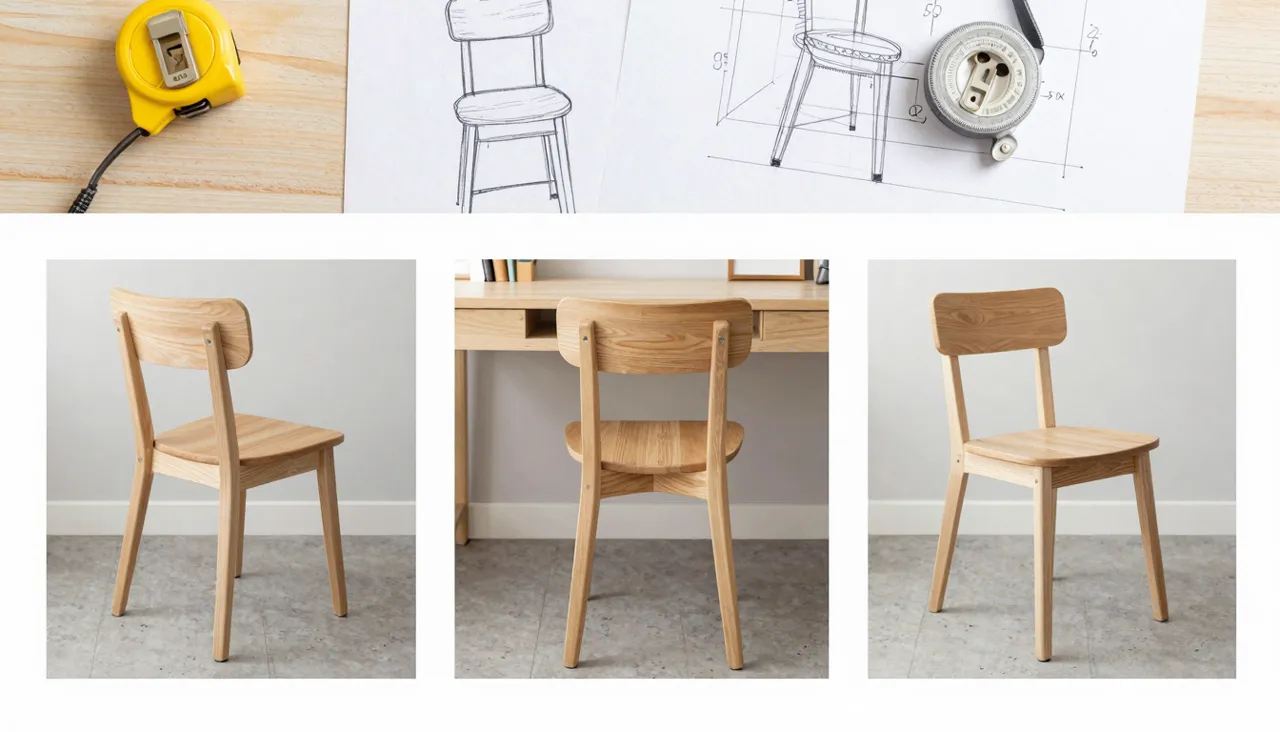
Wybór referencji, które działają
Zasada jest prosta: model musi wyraźnie widzieć obiekt. Używaj ostrych zdjęć, w których obiekt zajmuje większą część kadru, bez wizualnego bałaganu wokół niego. W przypadku obiektów o skomplikowanych kształtach dwa lub trzy kąty pomagają modelowi uchwycić objętość, a nie tylko widok z przodu.
W monicie pomiń opisywanie tego, co już pokazują odniesienia — zamiast tego opisz scenę i akcję: gdzie znajduje się obiekt, co go otacza, jak porusza się kamera, jakie jest światło. Format ramki ustawia się w opcjach: 16:9 poziomo, 9:16 portret lub Auto.
Tryb Tylko szybki i ceny
Generowanie referencji działa wyłącznie na warstwie Fast — nie można tutaj wybrać opcji Lite i Jakość, a jeśli spróbujesz, formularz zostanie przywrócony do wersji Fast. W praktyce jest to zaletą: rendery wracają szybko, więc możesz przeglądać kilka pomysłów na sceny z tym samym zestawem odniesienia podczas jednego posiedzenia.
Koszt klipu zależy od parametrów generacji i jest opłacany z salda tokenów obejmującego całą witrynę. Pokolenia, które zawiodły lub odmówiły, nic nie kosztują. Obowiązują standardowe zasady dotyczące treści VEO: brak dzieci w kadrze, brak okrucieństwa wobec zwierząt i brak materiałów dla dorosłych.
Gdzie tryb świeci
Pierwszym dużym przypadkiem użycia jest handel elektroniczny: za pomocą kilku zdjęć produktów możesz kręcić klipy do ofert, reklam i postów w mediach społecznościowych bez wynajmowania studia. Butelka sosu na letnim pikniku, trampki podczas biegu po mieście, krem do twarzy na marmurowej półce w łazience – wszystko z tych samych trzech referencji.
Drugi to content seryjny z powracającym bohaterem: maskotką marki, postacią z Twoich ilustracji, obiektem popisowym. Przygotuj odniesienia raz, a otrzymasz całą linię filmów, w których bohater będzie spójny w każdym klipie. Wyniki są przechowywane w historii, gotowe do pobrania lub rozszerzenia.
Częste pytania
Ile obrazów referencyjnych mogę przesłać?
Od jednego do trzech, a przynajmniej jeden jest wymagany — tryb nie uruchomi się bez referencji. W przypadku obiektów o skomplikowanych kształtach zapewnienie dwóch lub trzech kątów pomaga modelowi dokładnie uchwycić formę.
Dlaczego nie mogę wybrać poziomu jakości?
Odniesienie do wideo działa tylko w trybie Fast; jest to ograniczenie techniczne tego trybu i formularz resetuje każdy inny wybór z powrotem do opcji Szybki. Zaletą są szybkie rendery i tanie iteracje pomysłów na sceny.
Czy obiekt będzie dokładnie pasował do moich zdjęć?
Model sprawia, że obiekt jest rozpoznawalny, ale to jest generowanie, a nie kopiowanie – drobne szczegóły mogą się przesunąć. Czyste odniesienia pod różnymi kątami poprawiają dokładność, a ujęcie można po prostu zregenerować.