HappyHorse Referencia a vídeo: crea escenas de vídeo con IA a partir de hasta 9 imágenes
Bottom Line Up Front (BLUF): HappyHorse Reference-to-Video es un generador de vídeo con IA que funciona a partir de un conjunto completo de imágenes en lugar de una sola. Cargue hasta nueve imágenes de referencia y describa en texto cómo se combinan: un personaje de una foto, un atuendo de otra, una ubicación de una tercera; el modelo los fusiona en un clip coherente.
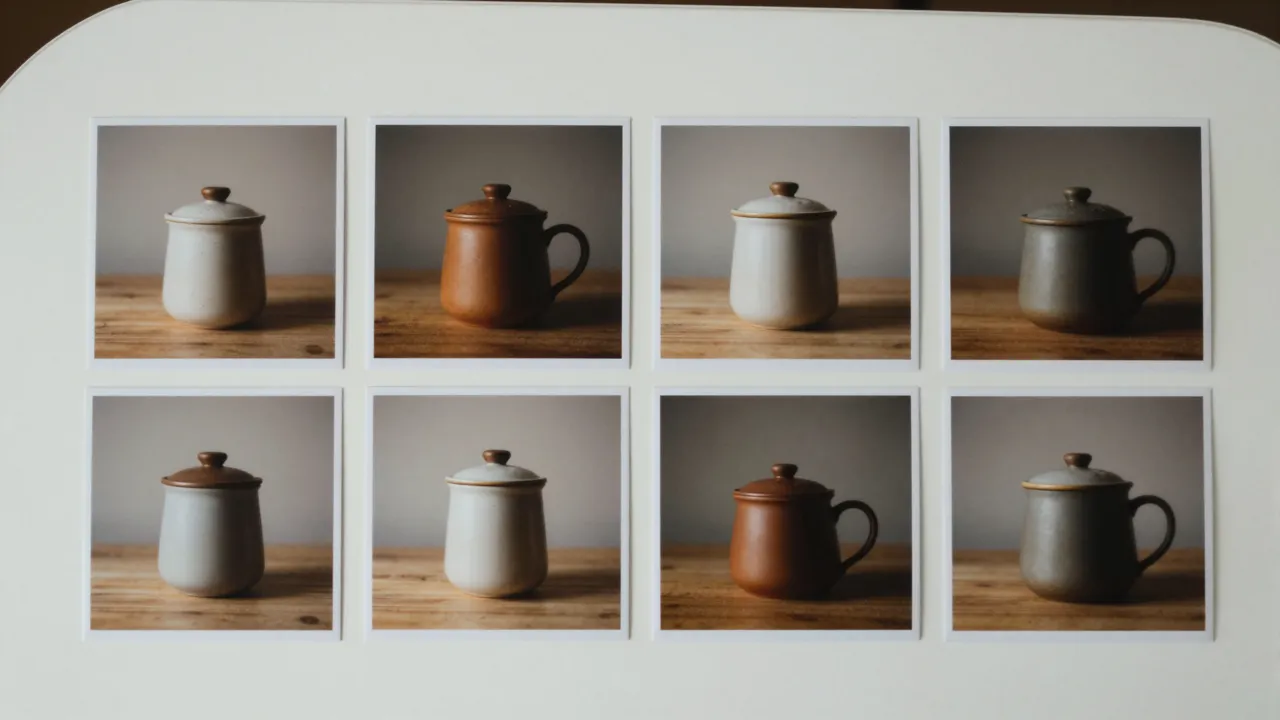
Componer una escena a partir de varias imágenes.
La característica distintiva de esta modalidad es hasta nueve referencias por generación. Cada imagen juega un papel en el futuro clip: el héroe, un segundo personaje, un accesorio, una ubicación, una muestra de estilo. Su mensaje explica quién es quién y qué sucede: "el hombre de la primera foto se sienta en el café de la tercera foto, sosteniendo la taza de la segunda".
Esto resuelve un problema que la simple imagen en video no puede solucionar: poner cosas en un cuadro que nunca fueron fotografiadas juntas. Un producto y un modelo de diferentes sesiones, un personaje sobre un fondo pintado, dos héroes de distintas sesiones, todos terminan en la misma escena sin ninguna composición manual.
Cómo lee el modelo tus referencias
La red no pega tus imágenes en el marco. Los estudia (la apariencia del personaje, la forma del objeto, la paleta de la ubicación) y vuelve a dibujar todo en movimiento. Por eso el héroe puede girar, caminar y recoger cosas sin dejar de ser reconocible. Cuanto más limpia sea la referencia y menos desorden haya alrededor del tema, más fiel será la transferencia.
Ayúdalo con palabras: asigna roles explícitamente y describe las relaciones. "La mujer de la imagen 1, con la chaqueta de la imagen 2, camina por la calle de la imagen 3" funciona mucho mejor que un vago "haz un bonito vídeo con estas imágenes". Tú defines el casting; el modelo sólo tiene que darle vida a la escena.
Formatos de fotogramas desde historias hasta pantalla ancha
A diferencia del modo de foto única, aquí la relación de aspecto es tu elección: pantalla ancha 16:9, vertical 9:16 y 3:4, cuadrada 1:1 y clásica 4:3. El mismo conjunto de referencias puede convertirse en un clip de historia vertical y en un vídeo de banner ancho para un sitio web; simplemente cambie el formato y vuelva a ejecutarlo.
La duración varía de 3 a 15 segundos, con salida 720p o 1080p. Los borradores cortos y económicos a 720p son perfectos para explorar ideas; guarde el render 1080p más largo para la versión final. El campo inicial te permite bloquear una composición que te guste y variar solo la redacción.
Casos de uso: anuncios, personajes recurrentes, catálogos
El escenario más gratificante son las series de vídeos con un personaje persistente: una mascota de marca, un héroe cómico, un presentador virtual. Introduce las mismas imágenes de personajes en cada generación y obtendrás una serie de clips en los que el héroe permanece igual. Para las tiendas, es una manera de mostrar un producto "en la vida real" combinando su fotografía con una del interior.
También brilla en el trabajo creativo: construye una escena de cuento de hadas a partir del dibujo de un niño y su foto, coloca una mascota en un mundo ilustrado, combina un boceto de disfraz con un modelo real. Todo lo que antes requería collages y retoques manuales ocurre en una sola generación.
Elegir un conjunto de referencia que funcione
No se apresure a llenar los nueve espacios. Cuantas más imágenes agregues, más difícil será para el modelo decidir qué importa. Comience con dos o tres referencias clave (héroe, objeto, fondo) y agregue más solo cuando al clip le falte claramente un detalle específico. Cada imagen extra diluye la atención de la red.
Esté atento a la compatibilidad: un personaje fotografiado a la luz del día contra una calle nocturna de neón obliga al modelo a improvisar y las costuras comienzan a verse. Las referencias con iluminación similar y una gama de colores cercana producen una imagen unificada que parece creíble desde el primer fotograma.
Preguntas frecuentes
¿Cuántas imágenes de referencia puedo subir?
De uno a nueve por generación. Dos o tres referencias clave (héroe, utilería, trasfondo) es el mejor punto de partida. Agregue más solo cuando sepa exactamente de qué detalle de la escena es responsable cada nueva imagen.
¿La persona de mi referencia seguirá siendo reconocible?
El modelo trabaja duro para preservar su identidad y, por lo general, el parecido es bueno, pero se trata de una nueva generación, no una copia de la foto. Un retrato nítido en primer plano sin otras personas en el encuadre, además de una instrucción explícita para mantener la apariencia, mejora la combinación.
¿En qué se diferencia esto de la conversión de imagen a vídeo normal?
La conversión de imagen a vídeo normal anima una imagen y mantiene su composición. Aquí traes varias imágenes de origen y el modelo crea una escena completamente nueva a partir de tu descripción. Elija este modo cuando la toma exacta que necesita simplemente no exista.