HappyHorse Riferimento a video: crea scene video AI da un massimo di 9 immagini
Bottom Line Up Front (BLUF): HappyHorse Reference-to-Video è un generatore video AI che funziona da un intero set di immagini anziché da una singola. Carica fino a nove immagini di riferimento e descrivi nel testo come si combinano: un personaggio da una foto, un vestito da un'altra, un luogo da una terza: il modello li unisce in un'unica clip coerente.
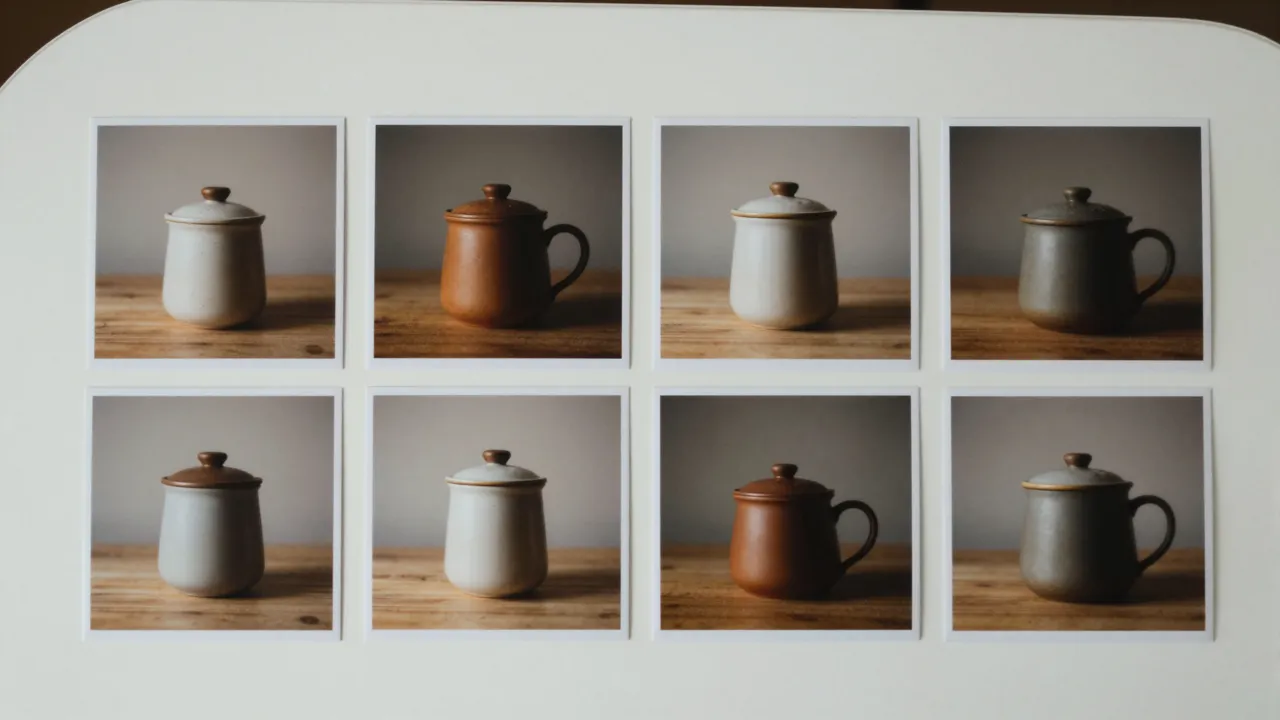
Composizione di una scena da più immagini
La caratteristica distintiva di questa modalità è fino a nove riferimenti per generazione. Ogni immagine gioca un ruolo nella clip futura: l'eroe, un secondo personaggio, un oggetto di scena, una location, un campione di stile. Il tuo suggerimento spiega chi è chi e cosa succede: "l'uomo della prima foto siede nel bar della terza foto, con in mano la tazza della seconda".
Ciò risolve un problema che la semplice conversione da immagine a video non può risolvere: mettere in un fotogramma cose che non sono mai state fotografate insieme. Un prodotto e un modello provenienti da riprese diverse, un personaggio su uno sfondo dipinto, due eroi provenienti da sessioni separate: finiscono tutti nella stessa scena senza alcuna composizione manuale.
Come il modello legge i tuoi riferimenti
La rete non incolla le tue immagini nella cornice. Li studia - l'aspetto del personaggio, la forma dell'oggetto, la tavolozza del luogo - e ridisegna tutto in movimento. Ecco perché l'eroe può girarsi, camminare e raccogliere oggetti rimanendo riconoscibile. Più il riferimento è pulito e meno disordinato attorno all'argomento, più fedele sarà il trasferimento.
Aiutatelo con le parole: assegnate i ruoli in modo esplicito e descrivete le relazioni. "La donna dell'immagine 1, che indossa la giacca dell'immagine 2, cammina per la strada dell'immagine 3" funziona molto meglio di un vago "fai un bel video da queste immagini". Sei tu a definire il casting; la modella deve solo dare vita alla scena.
Formati di frame dalle storie al widescreen
A differenza della modalità a foto singola, qui le proporzioni sono a vostra scelta: widescreen 16:9, verticale 9:16 e 3:4, quadrato 1:1 e classico 4:3. Lo stesso set di riferimenti può diventare una clip di storia verticale e un video banner ampio per un sito Web: basta cambiare formato ed eseguire nuovamente.
La durata varia da 3 a 15 secondi, con uscita 720p o 1080p. Brevi bozze economiche a 720p sono perfette per esplorare idee; salva il rendering 1080p più lungo per la versione finale. Il campo seed ti consente di bloccare una composizione che ti piace e di variare solo la dicitura.
Casi d'uso: annunci, personaggi ricorrenti, cataloghi
Lo scenario più gratificante sono le serie video con un personaggio persistente: una mascotte del marchio, un eroe dei fumetti, un presentatore virtuale. Inserisci le stesse immagini dei personaggi in ogni generazione e otterrai una serie di clip in cui l'eroe rimane lo stesso. Per i negozi è un modo per mostrare un prodotto "dal vivo" abbinando alla sua foto uno scatto di interni.
Brilla anche nel lavoro creativo: costruisci una scena da favola dal disegno di un bambino e dalla sua foto, immergi un animale domestico in un mondo illustrato, combina uno schizzo di un costume con un modello reale. Tutto ciò che prima richiedeva collage e ritocchi manuali avviene in un'unica generazione.
Scegliere un set di riferimento che funzioni
Non abbiate fretta di riempire tutti e nove gli slot. Più immagini aggiungi, più difficile sarà per la modella decidere cosa conta. Inizia con due o tre riferimenti chiave (eroe, oggetto, sfondo) e aggiungine altri solo quando nella clip manca chiaramente un dettaglio specifico. Ogni immagine in più diluisce l'attenzione della rete.
Fai attenzione alla compatibilità: un personaggio ripreso alla luce del giorno su una strada notturna al neon costringe il modello a improvvisare e le cuciture iniziano a essere visibili. I riferimenti con illuminazione simile e una gamma di colori ravvicinata producono un'immagine unificata che sembra credibile fin dal primo fotogramma.
Domande frequenti
Quante immagini di riferimento posso caricare?
Da uno a nove per generazione. Due o tre riferimenti chiave – eroe, oggetto di scena, sfondo – sono il miglior punto di partenza. Aggiungine altre solo quando sai esattamente di quale dettaglio della scena è responsabile ciascuna nuova immagine.
La persona di mio riferimento resterà riconoscibile?
Il modello lavora duramente per preservare l'identità e di solito la somiglianza è buona, ma si tratta di una nuova generazione, non di una copia della foto. Un ritratto ravvicinato nitido senza altre persone nell'inquadratura, oltre a un'istruzione esplicita per mantenere l'aspetto, migliora la corrispondenza.
In cosa differisce dalla normale conversione da immagine a video?
La normale conversione da immagine a video anima un'immagine e ne mantiene la composizione. Qui porti diverse immagini sorgente e il modello costruisce una scena nuova di zecca dalla tua descrizione. Scegli questa modalità quando semplicemente non esiste lo scatto esatto di cui hai bisogno.