HappyHorse ビデオへの参照: 最大 9 枚の画像から AI ビデオ シーンを構築
Bottom Line Up Front (BLUF): HappyHorse Reference-to-Video は、単一の写真ではなく一連の写真から動作する AI ビデオ ジェネレーターです。最大 9 枚の参照画像をアップロードし、それらがどのように組み合わされるかをテキストで説明します。1 枚の写真のキャラクター、別の写真の衣装、3 枚目の写真の場所など、モデルはそれらを 1 つの一貫したクリップに結合します。
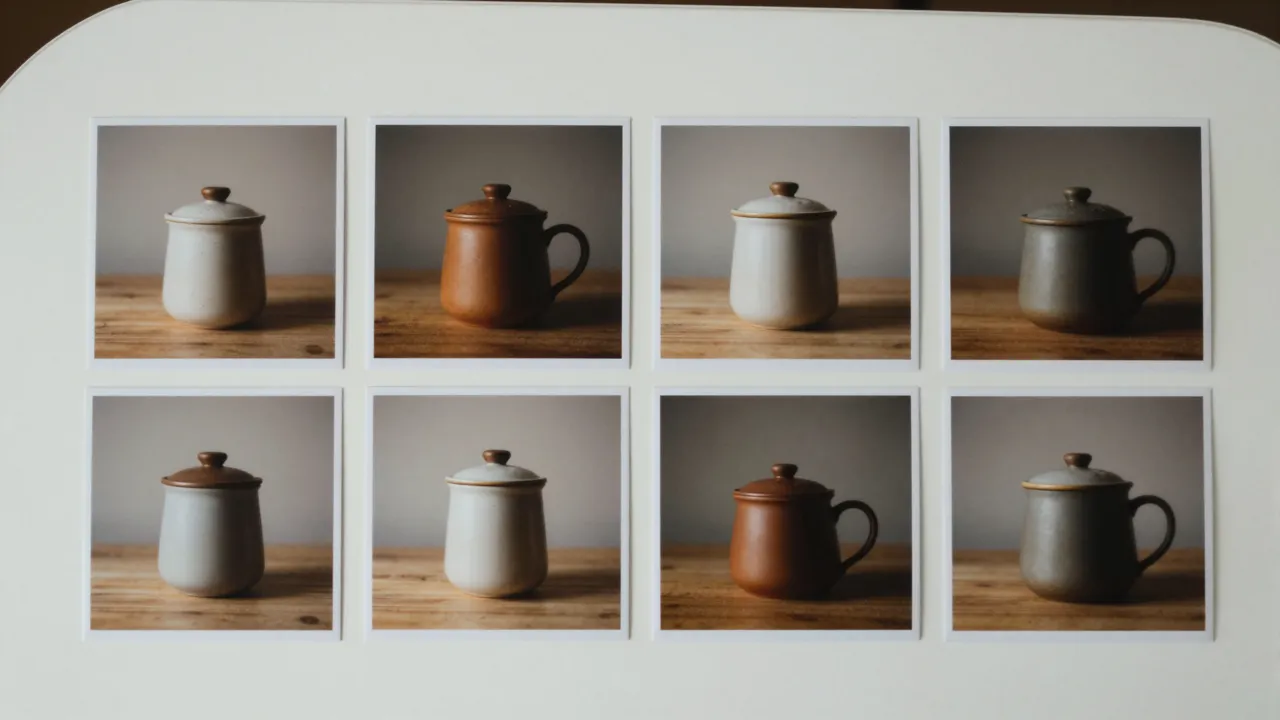
複数の写真からシーンを構成する
このモードの特徴は、1 世代あたり最大 9 つの参照を作成できることです。各画像は、ヒーロー、2 番目のキャラクター、小道具、場所、スタイル サンプルなど、将来のクリップで役割を果たします。プロンプトには、誰が誰で、何が起こったのかが説明されています。「最初の写真の男性は、3 番目の写真のカフェに座っており、2 番目の写真のマグカップを持っています。」
これにより、一緒に撮影されたことがないものを 1 つのフレームに収めるという、単純な画像からビデオへの変換では解決できない問題が解決されます。さまざまな撮影からの製品とモデル、ペイントされた背景に対するキャラクター、別々のセッションからの 2 人のヒーローなど、手動で合成することなく、すべて同じシーンに仕上がります。
モデルが参照を読み取る方法
ネットワークはあなたの写真をフレームに貼り付けません。キャラクターの見た目、オブジェクトの形状、場所のパレットなどを研究し、動きのあるものすべてを再描画します。だからこそ、主人公は認識され続けながら、向きを変え、歩き、物を拾うことができるのです。リファレンスがきれいで、被写体の周りが散らかっていないほど、転送はより忠実になります。
言葉を使って説明しましょう。役割を明示的に割り当て、関係を説明します。 「画像 1 の女性が画像 2 のジャケットを着て、画像 3 の通りを歩いている」という表現は、漠然とした「これらの写真から素敵なビデオを作成する」よりもはるかに効果的です。キャストを定義するのはあなたです。モデルはシーンに命を吹き込むだけで十分です。
ストーリーからワイドスクリーンまでのフレーム形式
単一写真モードとは異なり、ここでのアスペクト比は自由に選択できます: ワイドスクリーン 16:9、垂直スクリーン 9:16 と 3:4、正方形 1:1、クラシック 4:3。同じリファレンス セットを、Web サイトの縦長のストーリー クリップや幅広のバナー ビデオにすることができます。形式を切り替えて再実行するだけです。
継続時間の範囲は 3 ~ 15 秒で、出力は 720p または 1080p です。 720p の安価な短いドラフトは、アイデアを検討するのに最適です。より長い 1080p レンダリングを最終バージョン用に保存します。シードフィールドを使用すると、好みの構成をロックして、文言のみを変更できます。
使用例: 広告、繰り返し登場するキャラクター、カタログ
最も価値のあるシナリオは、ブランドのマスコット、コミックヒーロー、バーチャルプレゼンターなどの永続的なキャラクターを備えたビデオシリーズです。同じキャラクターの画像を各世代にフィードすると、ヒーローが同じままの一連のクリップが得られます。店舗にとっては、商品の写真と室内写真を組み合わせることで、商品を「実際に」見せる方法です。
クリエイティブな仕事にも威力を発揮します。子供の絵と写真からおとぎ話のようなシーンを構築したり、イラストの世界にペットをドロップしたり、衣装のスケッチと実際のモデルを組み合わせたりできます。コラージュや手動レタッチが必要だったすべての作業が 1 世代で完了します。
機能するリファレンス セットの選択
急いで 9 つのスロットすべてを埋めようとしないでください。追加する画像が増えるほど、モデルが何が重要かを判断するのが難しくなります。 2 つまたは 3 つの主要なリファレンス (ヒーロー、オブジェクト、背景) から始めて、クリップに特定のディテールが明らかに欠けている場合にのみ追加します。余分な画像があると、ネットワークの注目が薄れてしまいます。
互換性に注意してください。ネオンの夜道を背景に日中にキャラクターを撮影すると、モデルは即興で動くことになり、継ぎ目が見え始めます。同様の照明と近い色の範囲を使用したリファレンスでは、最初のフレームから信じられるような統一された画像が生成されます。
Frequently asked questions
参考画像は何枚アップロードできますか?
世代ごとに 1 人から 9 人まで。 2 つまたは 3 つの重要な参考資料 (ヒーロー、小道具、背景) が最良の出発点です。それぞれの新しい画像がシーンのどの詳細を担当しているのかが正確にわかっている場合にのみ、追加を追加します。
私の参照先の人物は認識され続けるでしょうか?
モデルはアイデンティティを維持するために懸命に努力しており、通常は類似性が良好ですが、これは写真のコピーではなく、新しい世代です。フレーム内に他の人がいない鮮明なクローズアップポートレートに加え、外観を維持するための明示的な指示により、一致度が向上します。
これは通常の画像からビデオへの変換とどのように異なりますか?
通常の画像からビデオへの変換では、1 つの画像をアニメーション化し、その構成を維持します。ここでは、いくつかのソース画像を持ち込むと、モデルが説明に基づいてまったく新しいシーンを構築します。必要な正確なショットが存在しない場合は、このモードを選択してください。