Kling O1 Image-to-Video: trasforma una foto fissa in un filmato in movimento
Bottom Line Up Front (BLUF): Kling O1 Image-to-Video è un generatore video AI che anima una singola fotografia. Carica un'immagine, opzionalmente digita cosa dovrebbe accadere nell'inquadratura e il modello produce un breve clip in cui l'immagine fissa prende vita: una persona sbatte le palpebre e sorride, l'acqua si increspa, la fotocamera si avvicina. Nessun software di editing, nessun fotogramma chiave: solo una foto e una frase.
Come funziona la generazione di foto in video qui
Inizia con un'immagine. Inseriscilo nel modulo di generazione, aggiungi un breve messaggio di movimento come "l'uomo si gira verso la telecamera e ride" o "la neve cade dolcemente sulla strada" ed esegui il lavoro. L'intelligenza artificiale inventa i fotogrammi intermedi mantenendo il viso, i vestiti e lo sfondo fedeli allo scatto originale. Più chiara è la descrizione dell'azione, più l'output corrisponderà a ciò che hai immaginato.
Puoi anche saltare del tutto la richiesta e lasciare che sia il modello a decidere come dovrebbe muoversi la scena: un buon modo per esplorare di cosa è capace un'immagine. Ogni clip finita arriva nella cronologia della tua generazione, dove puoi scaricarla, estenderla, catturare il fotogramma finale o riprodurre nuovamente la stessa foto con un prompt più nitido.
Una foto o due: scegliere la modalità giusta
Questo modello accetta fino a due immagini. Con una singola foto puoi scegliere tra clip da 5 e 10 secondi e il movimento si svolge in avanti da quel fotogramma. Aggiungi una seconda immagine e l'intervallo di durata si apre da 3 a 10 secondi, perché la generazione ora viaggia tra due punti di ancoraggio invece di andare alla deriva liberamente.
La modalità a due immagini brilla quando conta il finale. Mostra un prodotto confezionato nel primo fotogramma e completamente assemblato nel secondo, e l'intelligenza artificiale inventa una trasformazione fluida tra loro. Ciò ti dà molto più controllo sul finale di quanto potrebbe fare qualsiasi suggerimento testuale: consegni letteralmente al modello la sua destinazione.
Quali immagini si animano meglio
Gli scatti puliti e ben illuminati con un soggetto ovvio funzionano meglio: un ritratto, un prodotto su uno sfondo semplice, un paesaggio, un animale domestico. Scene movimentate con folla, testo minuscolo o riflessi complessi danno alla rete troppo da tracciare contemporaneamente e si insinuano dei problemi man mano che le cose si muovono. In caso di dubbi, semplifica il frame prima del caricamento.
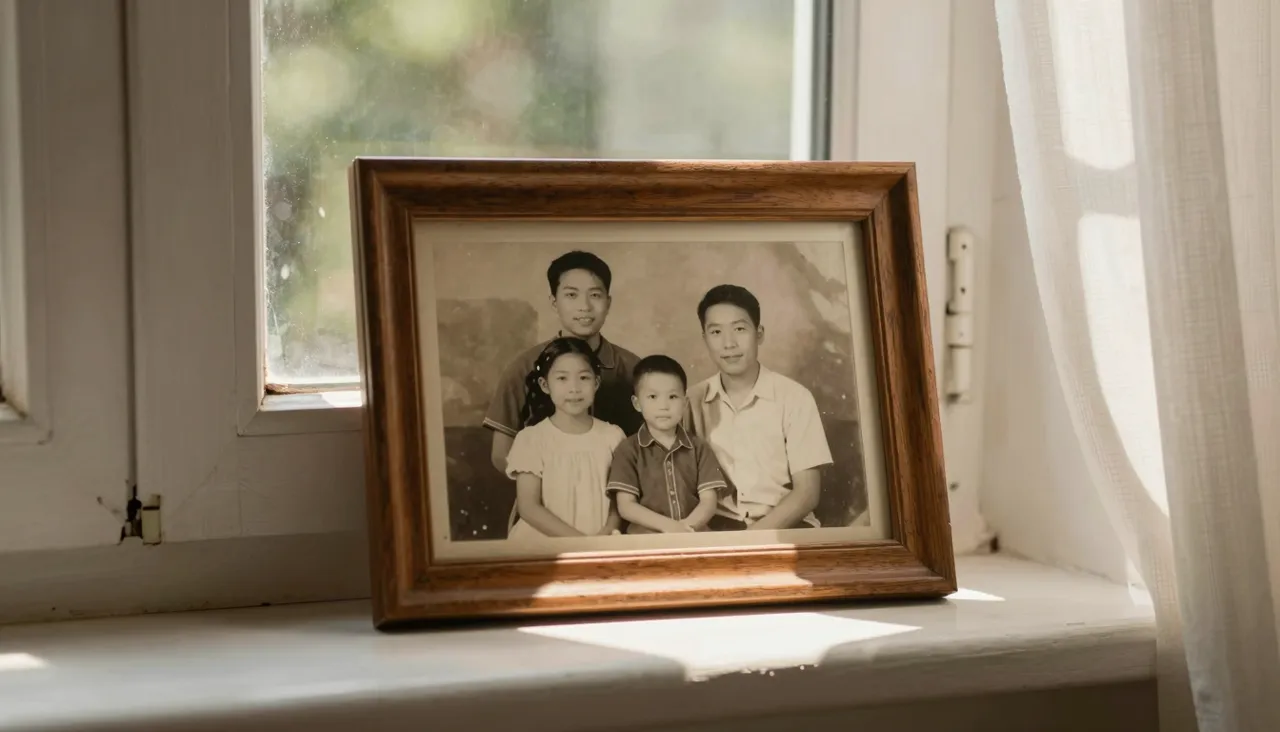
Le foto di famiglia vintage sono un meraviglioso caso d'uso. Scansiona una vecchia stampa, caricala e richiedi un movimento sottile: un battito di ciglia, un sorriso dolce, i capelli mossi dalla brezza. Il risultato sembra molto più personale di qualsiasi presentazione e richiede pochi minuti. Mantieni semplicemente delicato il movimento richiesto; le immagini d'archivio raramente sopravvivono con grazia all'azione drammatica.
Usi pratici per le foto animate
I lavori più comuni includono copertine di storie realizzate a partire da un normale selfie, sfondi viventi per presentazioni, poster di eventi animati ed elenchi di prodotti che attirano l'attenzione mentre gli acquirenti scorrono. Ovunque un'immagine statica sembri piatta, pochi secondi di movimento attirano l'attenzione - e questa è esattamente la nicchia che questo strumento riempie.
Gli utenti esperti trattano ogni clip come un elemento costitutivo. Genera una scena, estrai l'ultimo fotogramma, reinserisci quel fotogramma con un nuovo prompt e continua l'azione. Concatenate insieme, una fotografia si trasforma in una sequenza più lunga e coerente in cui ogni segmento riprende esattamente da dove si era interrotto quello precedente.
Errori comuni da evitare
Il più grande è sovraccaricare una breve clip con la trama: "lei si alza, cammina attraverso la stanza, si gira e saluta" semplicemente non si adatta, quindi l'intelligenza artificiale improvvisa e il risultato va fuori rotta. Richiedi una o due azioni semplici per generazione e costruisci invece storie più lunghe tramite il concatenamento.
Le foto di origine sfocate o scure sono l’altra trappola. Il modello anima la tua immagine; non lo ripara, quindi un input rumoroso diventa un video rumoroso. Infine, scrivi suggerimenti sul movimento, non sull'aspetto: la rete vede già come appare la persona, deve solo sapere cosa dovrebbe fare.
Domande frequenti
Devo scrivere un messaggio con la mia foto?
No. Lascialo vuoto e il modello sceglierà da solo un movimento naturale. Vale la pena aggiungere un suggerimento quando desideri qualcosa di specifico (un gesto particolare, un movimento della telecamera, uno stato d'animo) perché una singola frase chiara guida notevolmente il risultato.
Qual è lo scopo di caricare una seconda immagine?
Due immagini definiscono l'inizio e la fine della clip e l'intelligenza artificiale costruisce il viaggio tra di loro. È il modo più affidabile per controllare come finisce un video e sblocca anche una gamma più ampia di durate, da 3 a 10 secondi.
Il viso si è deformato durante il movimento: come posso risolverlo?
Utilizza una foto sorgente più nitida e ritagliata più ravvicinata e chiedi un movimento più calmo; i giri veloci della testa sono il solito colpevole. Anche ripetere lo stesso lavoro aiuta, poiché ogni generazione produce una versione leggermente diversa.