Jimeng 4.5 – ein KI-Bildgenerator, der die Dinge einfach hält
Bottom Line Up Front (BLUF): Jimeng 4.5 ist ein KI-Bildgenerator, der eine Klartextbeschreibung in kurzer Zeit in fertige Bilder umwandelt. Es gibt keine Wand aus Schiebereglern und Schaltern, was es zu einem praktischen Ausgangspunkt macht, wenn Sie noch nie zuvor Bilder erstellt haben. Sie können auch ein eigenes Foto anhängen und es vom Model nacharbeiten lassen. Alles läuft im Browser auf einem gemeinsamen Token-Guthaben.
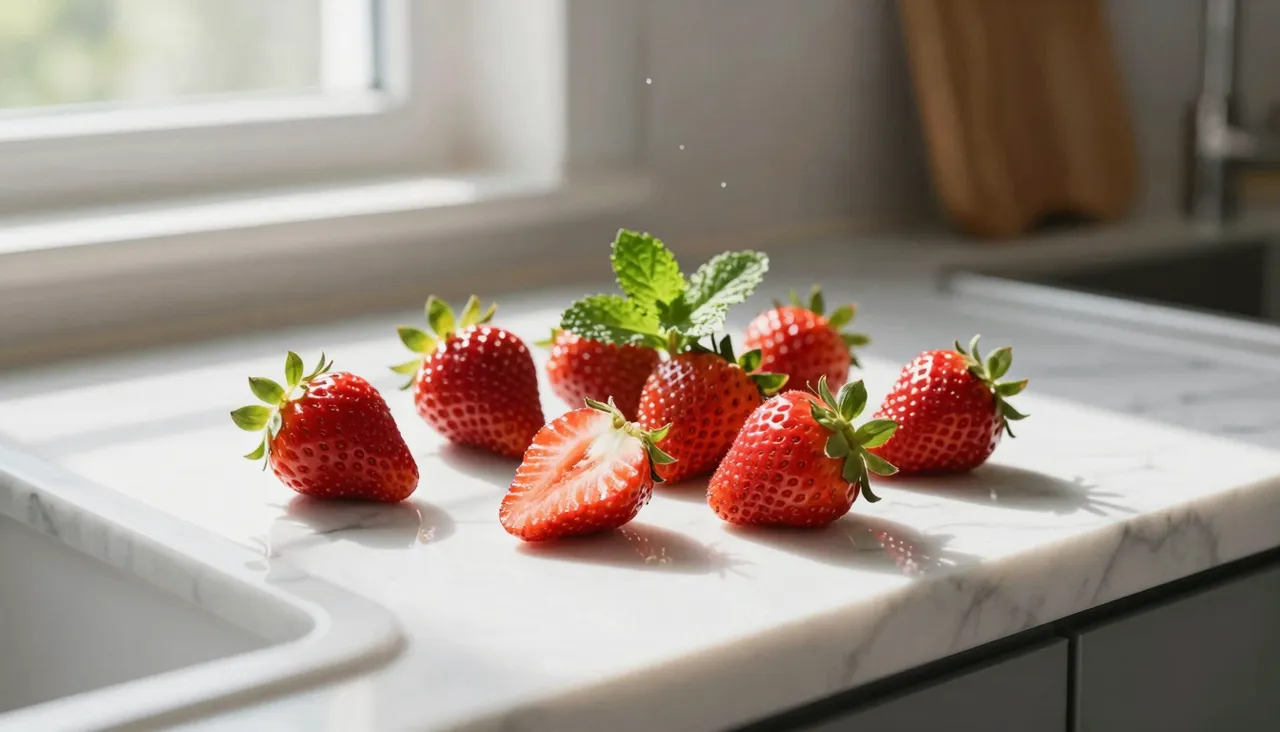
Was dieses Modell kann
Der Kernmodus ist Text-zu-Bild. Beschreiben Sie eine Szene mit alltäglichen Worten – eine gemütliche Küche im Morgenlicht, eine Katze im Raumanzug, ein Banner mit Sonnenuntergang in den Bergen – und das Modell kümmert sich selbstständig um Komposition, Beleuchtung und Details. Sie brauchen keinen Prompt-Engineering-Jargon; Meist genügt ein klarer Satz darüber, was in den Rahmen gehört.
Der zweite Modus funktioniert von Ihrem Foto aus. Hängen Sie ein Bild an die Anfrage an und die Generation wird darauf aufbauen: den Hintergrund austauschen, den Kunststil ändern, das Motiv neu gestalten, es in eine andere Umgebung verschieben. Das ist praktisch, wenn Sie eine kontrollierte Variation einer bestimmten Aufnahme statt eines zufälligen neuen Bildes benötigen.
Mehrere Varianten aus einer Anfrage
Anstelle eines einzelnen Bildes kann Jimeng 4.5 eine ganze Reihe von Aufnahmen Ihrer Eingabeaufforderung zurückgeben. Sie werden als Raster in Ihrem Verlauf angezeigt und jeweils einzeln in voller Größe geöffnet. Der Vergleich von Interpretationen nebeneinander ist ein blindes Neuwürfeln: Man wählt die stärkste aus und lädt sie sofort herunter.
Wenn keine der Varianten landet, führen Sie die Eingabeaufforderung mit einer kleinen Änderung erneut aus – eine Wiederholungsschaltfläche stellt Ihren vorherigen Text wieder her, sodass Sie eine Farbe anpassen, ein Detail hinzufügen oder ein Objekt mit Wörtern ausschließen können. Zwei oder drei Runden wie diese bringen einem normalerweise viel näher als beim ersten Versuch.
So verwandeln Sie Ihr Foto in Kunst
Klicken Sie auf das Referenzfeld und laden Sie ein Bild hoch – JPG, PNG oder WebP bis zu 10 MB. Schreiben Sie dann, was sich ändern soll: Machen Sie daraus eine Aquarellillustration, ersetzen Sie den Hintergrund durch eine Nachtstadt, verwandeln Sie diesen Schnappschuss in ein Filmplakat. Das Modell sorgt dafür, dass das Motiv erkennbar bleibt, und überarbeitet den Rest entsprechend Ihren Worten.
Diese Version akzeptiert eine einzelne Referenz. Vermeiden Sie daher den Versuch, mehrere Fotos in einer Anfrage zusammenzuführen – andere Modelle auf der Website übernehmen Aufträge im Collage-Stil. Bei einem Foto ist das Verhalten jedoch vorhersehbar: Was Sie ändern möchten, wird geändert, und alles andere bleibt nah am Original.
Wo es am besten passt
Typische Aufgaben: Illustrationen für Blogbeiträge und soziale Medien, Cover, Avatare, schnelle Konzeptskizzen, um sie einem Kunden zu zeigen, Präsentationshintergründe. Wenn Sie heute ein anständiges Bildmaterial benötigen und kein Designer in der Nähe ist, ist ein kurzes Formular mit einem Textfeld genau das richtige Maß an Schnittstelle.
Für inszenierte Szenen, die eine präzise Steuerung erfordern – mehrere Charaktere, strenger Bildausschnitt, fein abgestimmte Detaildichte – ist das neuere Jimeng 5.0 mit seinen erweiterten Einstellungen die bessere Wahl. Für Alltagsbilder bietet die vierte Generation mehr Reichweite, als die meisten Menschen jemals nutzen.
Häufige Anfängerfehler
Am häufigsten handelt es sich um eine aus zwei Wörtern bestehende Eingabeaufforderung. Das Modell entspricht den Anforderungen, die Ausgabe ist jedoch generisch. Fügen Sie Kontext hinzu: Ort der Szene, Tageszeit, Stimmung und Stil – fotorealistisch, Illustration, 3D-Rendering. Ein paar Besonderheiten verbessern die Ergebnisse mehr als alle sogenannten magischen Schlüsselwörter.
Der zweite Fehler besteht darin, beim ersten Versuch eine perfekte Übereinstimmung zu erwarten. Die Generierung erfolgt iterativ: Schauen Sie sich die Varianten an, verfeinern Sie den Wortlaut und führen Sie ihn erneut durch. Alles, was Sie erstellen, bleibt in Ihrem Verlauf, sodass kein Versuch umsonst ist und Sie jederzeit zu einer Version zurückkehren können, die Ihnen gefällt.
Häufige Fragen
Benötige ich Fähigkeiten zum schnellen Schreiben?
Nein. Beschreiben Sie die Szene so, als würden Sie einen Künstler informieren. Konkrete Details zu Ort, Licht, Stil und Stimmung sind weitaus wichtiger als eine spezielle Syntax. Nach einigen Generationen werden Sie ein Gefühl dafür bekommen, welche Worte das Ergebnis steuern.
Kann ich mein eigenes Foto hochladen?
Ja – ein Bild bis zu 10 MB pro Anfrage. Das Modell verwendet es als Basis und wendet die von Ihnen beschriebenen Änderungen an: einen neuen Hintergrund, einen anderen Kunststil, eine andere Umgebung, während das Motiv weiterhin erkennbar bleibt.
Was ist, wenn mir das Ergebnis nicht gefällt?
Wiederholen Sie es mit einer präziseren Beschreibung. Mit der Wiederholungstaste kehren Sie zur vorherigen Eingabeaufforderung zurück. Am meisten hilft es, einen Stil explizit zu benennen und mehrdeutige Formulierungen zu entfernen. Jeder Lauf erzeugt neue Varianten und frühere bleiben im Verlauf gespeichert.