AI Text to Speech Free: Exprimați-vă textul cu o rețea neuronală în browser
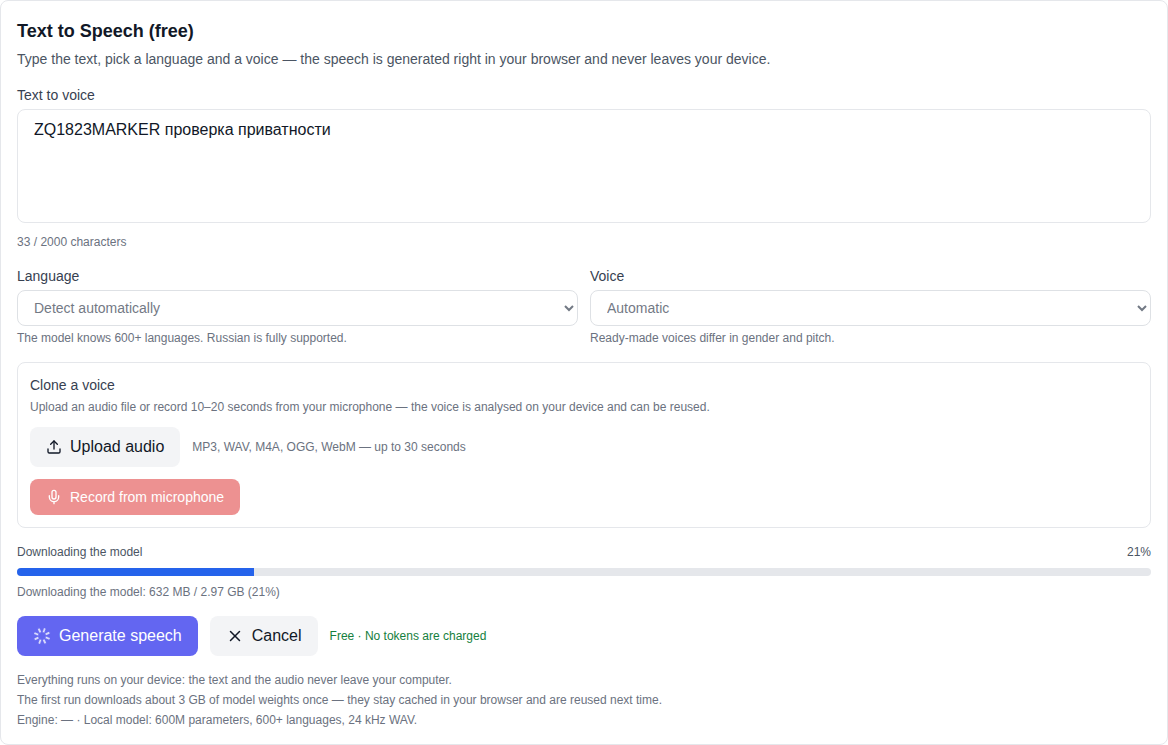
Acum vă puteți exprima textul cu o rețea neuronală gratuit, fără nimic de instalat: the Text to Speech (gratuit) modelul a sosit în Video secțiune. Se rulează chiar în browser - tastați textul, alegeți o limbă și o voce, iar câteva secunde mai târziu ascultați și descărcați fișierul audio finalizat. Nici textul, nici înregistrarea vocală nu sunt încărcate nicăieri: totul este calculat pe propriul dispozitiv.
De ce este gratuit
Serviciile obișnuite de vorbire sintetizează sunetul pe propriile servere și percepe bani sau jetoane pentru el. Aici modelul este încărcat în browser și folosește placa grafică a computerului (WebGPU, cu procesorul ca alternativă). Serverul servește doar codul instrumentului și greutățile modelului - nu are nimic de calculat, așa că nu sunt taxate jetoane și numărul de generații este nelimitat.
Confidențialitatea este și gratuită: textul pe care îl exprimați și înregistrarea vocii rămân pe dispozitiv. Acest lucru contează atunci când exprimați mesaje, documente sau note personale.
Cum trimiteți textul vocal cu o rețea neuronală: pas cu pas
- Deschideți Secțiunea video si alege Text to Speech (gratuit) în lista de modele — se află în partea de jos, lângă celelalte instrumente gratuite.
- Inserați textul în câmpul „Text în voce” – până la 2000 de caractere odată.
- Alegeți limba. Dacă nu sunteți sigur, lăsați „Detecta automat”.
- Alegeți o voce: feminină sau masculină, mai mare sau mai joasă, o șoaptă - sau una dintre vocile dvs. salvate.
- Apăsați „Generați vorbire” și așteptați să se termine. Puteți reda rezultatul pe pagină și îl puteți descărca ca fișier WAV.
600+ limbi
Modelul este multilingv: cunoaște mai mult de 600 de limbi. Pentru text mixt, puteți lăsa activată detectarea automată a limbii sau alegeți limba de care aveți nevoie - lista include engleză, germană, franceză, spaniolă, chineză, japoneză, arabă și alte zeci, la îndemână atunci când exprimați videoclipuri pentru mai multe țări.
Cum se clonează o voce
Puteți clona o voce în două moduri - ambele sunt gratuite și ambele sunt calculate pe dispozitiv:
- Încărcați un fișier audio. MP3, WAV, M4A, OGG sau WebM până la 30 de secunde funcționează bine.
- Înregistrați de la microfon. 10-20 de secunde de vorbire curată, fără muzică sau zgomot sunt suficiente.
După analiză, instrumentul transformă înregistrarea într-un profil vocal și îl stochează în browser. De atunci încolo, alegeți acea voce din listă și exprimați orice text cu propria voce, fără a încărca din nou înregistrarea. Profilurile sunt păstrate local și supraviețuiesc unei reîncărcări a paginii.
Ce trebuie să știi înainte de prima alergare
- Browser. Un Chrome sau Edge recent pe un desktop funcționează cel mai bine. Fără WebGPU modelul cade înapoi la procesor și este vizibil mai lent - instrumentul vă avertizează sincer despre asta.
- Prima alergare. Browserul descarcă greutățile modelului o dată (aproximativ 3 GB) și le memorează în cache. Începe imediat rulările ulterioare.
- Memorie. Este nevoie de aproximativ 3 GB de memorie liberă. Pe un dispozitiv slab instrumentul afișează un avertisment clar în loc să se blocheze.
- Rezultat. Fișierul terminat este un 24 kHz WAV, gata să fie introdus în cronologia de editare.
Pentru cine este
Textul neuronal în vorbire acoperă o mulțime de sarcini de zi cu zi: exprimarea unui clip pentru rețelele de socializare, realizarea unei versiuni audio a unui articol, nararea unei prezentări, verificarea modului în care sună un scenariu sau pur și simplu ascultarea unui document în loc să-l citească. Dacă aveți nevoie de vocea unei anumite persoane, clonați-o dintr-o scurtă înregistrare.
Aceeași secțiune are și alte instrumente gratuite care rulează chiar în browser: hartă de adâncime, eliminarea fundalului video şi Upscaler video și imagine.
Întrebări frecvente
Este chiar gratuit? Da. Nu se percepe nici un jetoane pentru acest model și nu are API plătită - computerul dvs. face treaba.
Textul meu este încărcat? Nu. Nici textul, nici sunetul nu părăsesc dispozitivul; numai codul instrumentului și greutățile modelului provin de la server.
Cât timp îi ia? O frază scurtă durează de obicei mai puțin de un minut după ce modelul a fost descărcat o dată; textul mai lung durează mai mult, iar bara de progres arată unde se află.