免费人工智能文本转语音:在浏览器中使用神经网络为您的文本配音
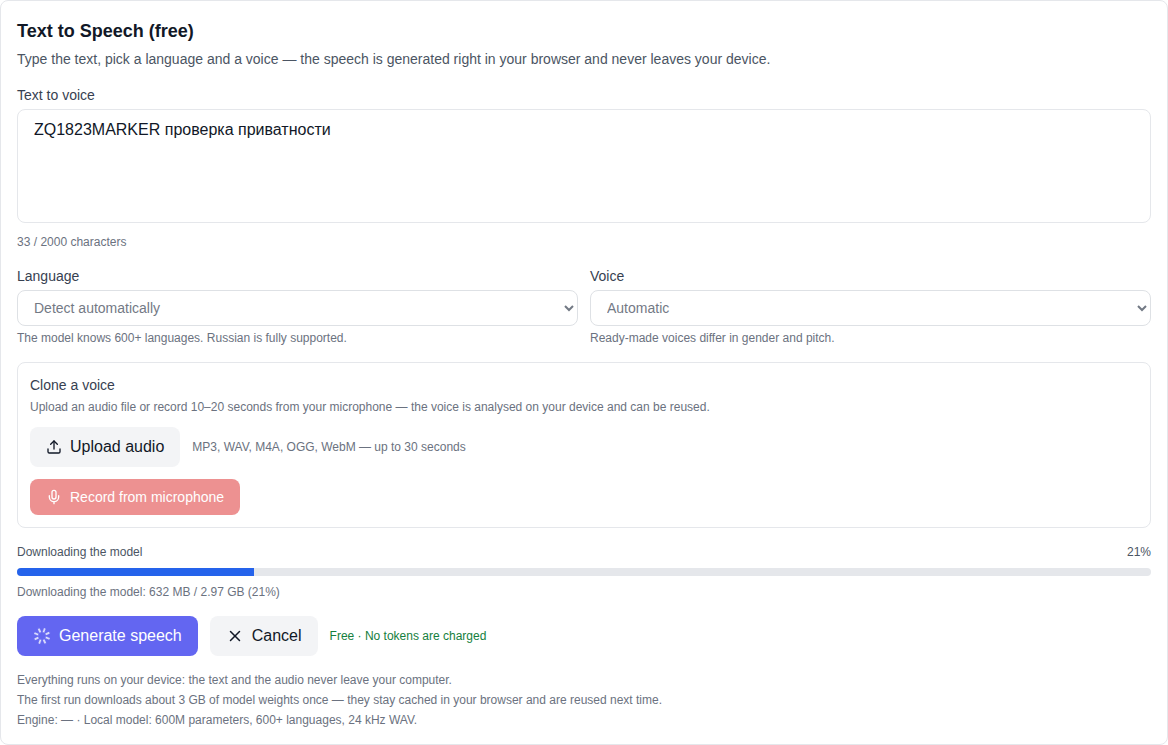
现在,您可以使用神经网络免费为您的文本配音,无需安装任何内容: 文字转语音(免费) 模型已经到达 视频 部分。它直接在您的浏览器中运行 - 输入文本,选择语言和声音,几秒钟后您就可以收听并下载完成的音频文件。文本和录音都不会上传到任何地方:一切都在您自己的设备上计算。
为什么它是免费的
常规语音服务在自己的服务器上合成音频并为此收取费用或代币。这里模型被加载到浏览器中并使用计算机的显卡(WebGPU,处理器作为后备)。服务器仅提供工具的代码和模型权重——它没有任何可计算的内容,因此不收取任何代币费用,并且生成的数量是无限的。
隐私也是免费的:您发出的文本和录音都保留在您的设备上。当您表达消息、文件或个人笔记时,这一点很重要。
如何使用神经网络对文本进行语音:一步一步
- 打开 视频部分 并选择 文字转语音(免费) 在模型列表中 - 它位于最底部,旁边是其他免费工具。
- 将文本粘贴到“文本到语音”字段中 - 一次最多 2000 个字符。
- 选择语言。如果您不确定,请保留“自动检测”。
- 选择一种声音:女声或男声、高音或低音、耳语或您保存的声音之一。
- 按“生成语音”并等待其完成。您可以在页面上播放结果并将其下载为WAV文件。
600+ 语言
该模型是多语言的:它了解 600 多种语言。对于混合文本,您可以打开自动语言检测,或选择您需要的语言 - 该列表包括英语、德语、法语、西班牙语、中文、日语、阿拉伯语等数十种语言,当您为多个国家/地区的视频配音时,这很方便。
如何克隆声音
您可以通过两种方式克隆语音 - 两种方式都是免费的,并且都是在您的设备上计算的:
- 上传音频文件。 MP3、WAV、M4A、OGG 或 WebM 最多 30 秒即可。
- 从麦克风录制。 10-20 秒干净的讲话(没有音乐或噪音)就足够了。
分析后,该工具会将录音转换为语音配置文件并将其存储在您的浏览器中。从那时起,您只需从列表中选择该声音,并用您自己的声音说出任何文本,而无需再次上传录音。配置文件保存在本地并在页面重新加载后继续存在。
第一次运行前需要了解什么
- 浏览器。 最近在桌面上使用的 Chrome 或 Edge 效果最佳。如果没有WebGPU,模型会回退到处理器并且速度明显变慢——该工具会诚实地警告您这一点。
- 第一次运行。 浏览器下载一次模型权重(大约3 GB)并缓存它们。稍后的运行立即开始。
- 记忆。 需要大约 3 GB 的可用内存。在性能较弱的设备上,该工具会显示清晰的警告而不是崩溃。
- 结果。 完成的文件是 24 kHz WAV,可以放入您的编辑时间轴中。
它是为谁而设
神经文本到语音涵盖了大量的日常工作:为社交媒体剪辑配音、制作文章的音频版本、为演示文稿做旁白、检查脚本听起来如何,或者只是听文档而不是阅读它。如果您需要特定人的声音,请从简短的录音中克隆它。
同一部分还有其他可以在浏览器中运行的免费工具: 深度图, 视频背景去除器 和 视频和图像升级器.
常见问题
真的免费吗? 是的。该模型不收取任何代币费用,也没有付费 API — 您的计算机即可完成工作。
我的文字上传了吗? 不会。文本和音频都不会离开您的设备;只有工具的代码和模型权重来自服务器。
多久时间? 模型下载一次后,一个简短的短语通常需要不到一分钟的时间;较长的文本需要更长的时间,进度条会显示它所在的位置。