Jak sprawić, by Seedance 2.0 mówił w Twoim języku: 2 sposoby
Seedance 2.0 doskonale nadaje się do scen dialogowych, ale wers napisany alfabetem innym niż łaciński — w naszym przykładzie cyrylicą — nie zawsze jest wyraźnie wymawiany. Istnieją dwa sposoby, aby model mówił w Twoim języku: szybki i precyzyjny.
Sposób 1: napisz linię literami łacińskimi
Przeliteruj słowa literami łacińskimi. Dla języka rosyjskiego „Privet, kak dela?” staje się Privet, kak dela? Zapisz to tak, jak brzmi, a nie według ścisłych zasad transliteracji — to powie modelowi, jakiego dźwięku potrzebujesz.
Zwiększa to szansę na wyraźną mowę, ale jej nie gwarantuje. Zaletą jest szybkość i prostota: żadnych dodatkowych narzędzi, wystarczy edytować tekst w wierszu poleceń i uruchomić generację.
Sposób 2: utwórz głos z wyprzedzeniem
Zsyntetyzuj potrzebną linię w generatorze głosu, a następnie prześlij gotowy dźwięk do Seedance 2.0 i odwołuj się do niego w wierszu poleceń — model akceptuje dźwięk wraz z tekstem i obrazami oraz podkłada głos scenie za pomocą Twojego nagrania.
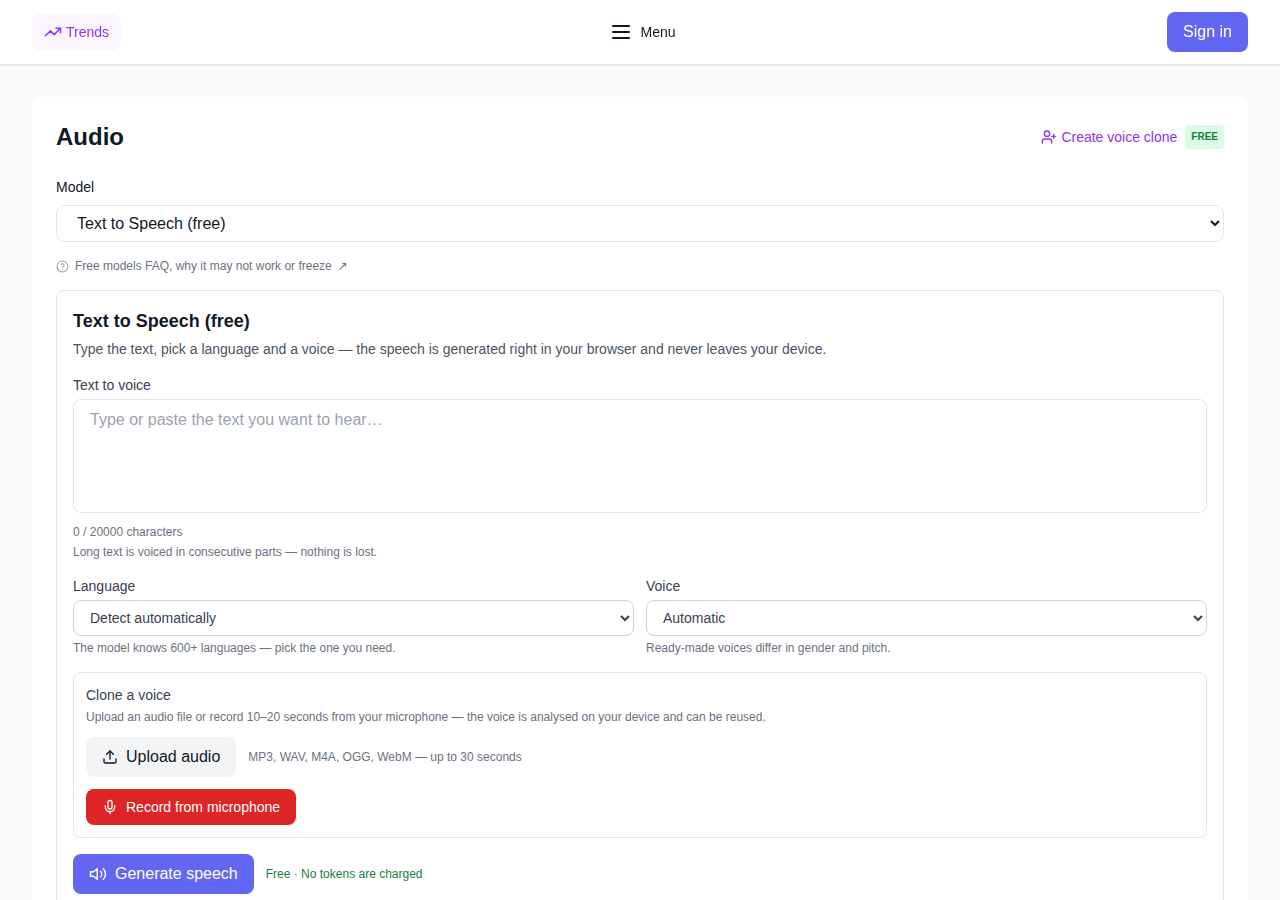
Możesz wygenerować swój własny głos za darmo — w narzędziu przeglądarki Tekst na mowę (bezpłatny): działa bezpośrednio w przeglądarce, nie są pobierane żadne tokeny, a Twój tekst nigdy nie opuszcza urządzenia.
Jeśli potrzebujesz pauz i konkretnych intonacji, to znaczy tani: Tekst na mowę z intonacją narzędzie dodaje pauzy i akcenty, cena zależy od rozmiaru tekstu i jest wyświetlana przed rozpoczęciem.
Który wybrać
- Litery łacińskie — szybki i prosty: dobry do przeciągów i krótkich codziennych linii.
- Gotowy głos — bardziej precyzyjny głos i intonacja: w przypadku ważnych dialogów w filmie.
Często zadawane pytania
Czy mogę przesłać własny głos do Seedance? Tak: wygeneruj linię w generatorze głosu i prześlij plik audio do Seedance 2.0 wraz z podpowiedzią — model akceptuje dźwięk jako sygnał wejściowy.
Czy generowanie głosu jest płatne? Nie, podstawowe narzędzie do rozpoznawania mowy w przeglądarce jest bezpłatne i nie pobiera żadnych tokenów. Opcją płatną jest mowa z pauzami i intonacjami; jego cena jest wyświetlana przed rozpoczęciem.
Który sposób jest bardziej niezawodny? Gotowe nagranie dźwiękowe: głos i intonacja są dokładnie takie, jakie stworzyłeś – model nie zgaduje, odtwarza.