Aktorstwo głosowe Gemini TTS: 30 głosów i wszystkie ustawienia
W sekcji "Audio" pojawiło się nowe narzędzie - podkład głosowy w dialogach Gemini TTS. Zamienia gotowy scenariusz w dźwięk: określasz mówcy, ich głosy i charakter, a usługa wypowiada linijki jedna po drugiej i zwraca gotowe MP3.
Co to za instrument
To nie jest czytanie jednym głosem jednego tekstu, ale całością dialog z wieloma mówcami. Każda postać ma swój własny głos, akcent, styl prezentacji i tempo, a kwestie brzmią tak, jak zostały zamierzone: rozmowa między prezenterami, skecz, wywiad, wersety bohaterów filmu.
Dostępne dwa modele:
- Gemini 3.8 Flash TTS — ekspresyjne aktorstwo głosowe: bogatsze emocje, bardziej naturalny rytm, lepsza kontrola przekazu. Nadaje się do podcastów, audiobooków i podkładów głosowych.
- Gemini 3.8 Flash-Lite TTS — ta sama mechanika jest tańsza i szybsza: w przypadku dużych wolumenów, wersji roboczych i czytania tekstów na głos.
Jakie ustawienia są dostępne?
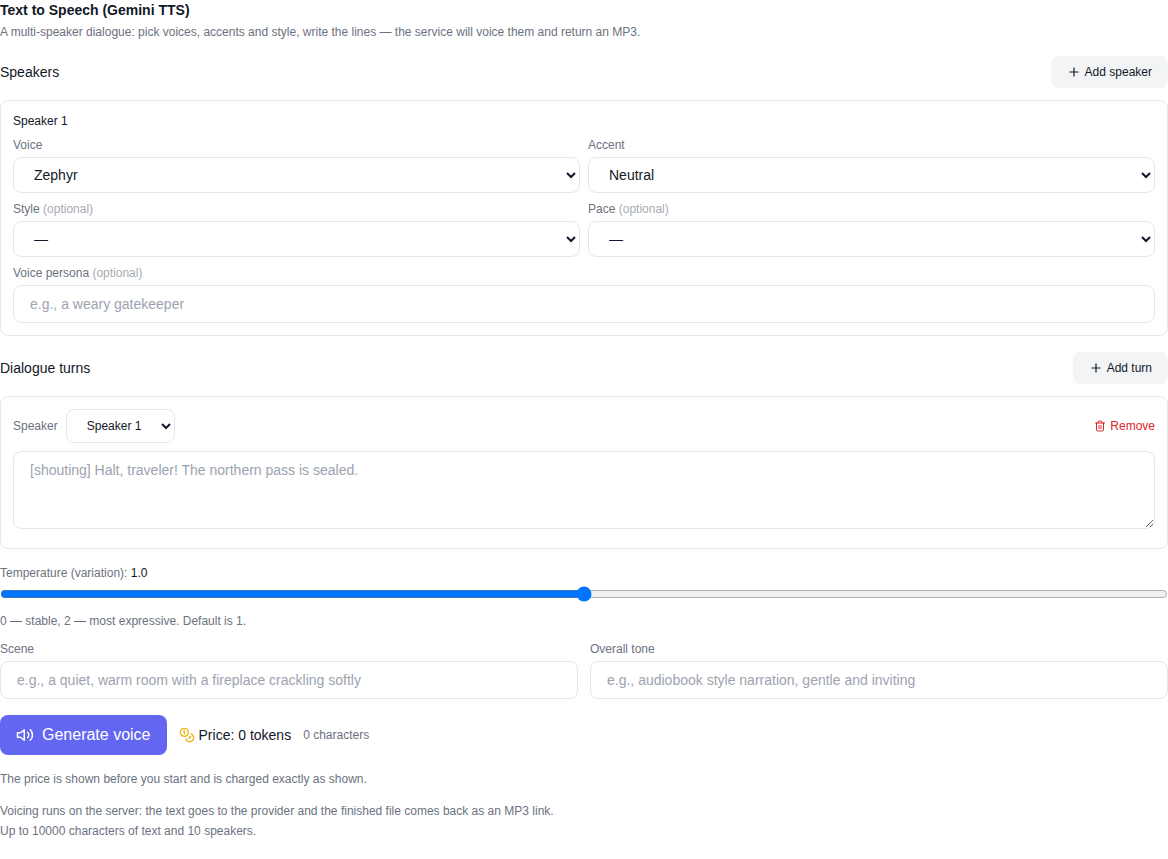
Interfejs wyświetla wszystkie parametry zapewniane przez model aktorstwa głosowego:
- Mówcy. Od jednego do kilku znaków; każdy ma swój własny podpis „Speaker 1”, „Speaker 2” itd., dzięki którym repliki są powiązane z głosem.
- 30 głosów - od miękkiej narracji po energiczną i „newsową”.
- 8 akcentów - neutralny, amerykański (generał, „dolina”, południowy), brytyjski (RP i Brixton), transatlantycki, australijski.
- 6 stylów serwowania — uśmiech w głosie, spiker, szept, empatia, promo i „suchy” równy ton.
- 4 stawki mowy - naturalny, tupot, gładki „dryf” i szarpany.
- Charakter głosowy - dowolny opis, np. „ciepły gawędziarz” lub „surowy strażnik bramy”.
- Temperatura - od 0 do 2: niższa - bardziej stabilna i przewidywalna, wyższa - żywsza i bardziej zróżnicowana.
- Scena i ogólny ton - opis scenerii („cichy pokój z trzaskającym kominkiem”) i stylu narracji („audiobook, miękki i zachęcający”).
- Repliki — każda linia dialogu do 10 000 znaków; zachowana jest kolejność replik.
Jak nagłośnić dialog: krok po kroku
- Otwarte Sekcja „Dźwięk”. i wybierz model Gemini 3.8 Flash TTS Lub Flash-LiteTTS - znajdują się na dole listy modeli.
- Dodaj mówcy i dostosuj głos, akcent, styl i tempo każdej osoby.
- Napisz linie dialogu i wskaż każdego mówcę.
- W razie potrzeby wprowadź opis sceny, ogólny ton i temperaturę.
- Spójrz na cenę - jest ona widoczna PRZED premierą i jest przeliczana w miarę wpisywania tekstu.
- Kliknij „Głos”, a kiedy będziesz gotowy, posłuchaj wyniku i pobierz MP3.
Ile to kosztuje
Cena wyliczana jest na podstawie rzeczywistej objętości tekstu: im dłuższe repliki, tym wyższy koszt, i jest to widoczne przed premierą – po generacji nie ma niespodzianek. Płatność odbywa się za pomocą tokenów witryny, tak jak w przypadku innych płatnych generacji; w przypadku niepowodzenia tokeny są zwracane automatycznie. Cennik można przeglądać bezpośrednio w formularzu: kwota jest aktualizowana w trakcie wpisywania skryptu.
Często zadawane pytania
Czy mogę podkładać głos w dialogach pomiędzy dwiema lub większą liczbą postaci? Tak, każdy mówca ma swój własny głos i ustawienia, linie zmieniają się.
W jakim formacie jest wynik? MP3 - możesz go posłuchać na stronie i pobrać jednym przyciskiem.
W jakich językach mówi modelka? Model jest wielojęzyczny: odtwarza teksty w kilkudziesięciu językach, w tym rosyjskim i angielskim.
Co wybrać: Flash czy Flash-Lite? Dla wyrazistych projektów - Flash, dla dużych wolumenów i wersji roboczych - Flash-Lite: mechanika jest taka sama, ale tańsza i szybsza.
Czy muszę zapłacić, żeby spróbować? Odpis następuje w momencie rozpoczęcia aktorstwa głosowego, a w przypadku wystąpienia błędu tokeny zwracane są automatycznie.