← 所有文章
配音 Gemini TTS:30 种语音和所有设置
在「音频」板块上线了一个新工具——Gemini TTS 对话配音。它能把现成的脚本直接变成声音:你设定说话者、他们的声音和性格,服务会依次为每一句台词配音,最后返回一个现成的 MP3 文件。
这是什么乐器
这不是用一种声音朗读一篇文章,而是一篇完整的文章 多人对话。每个角色都有自己的声音、口音、演示风格和节奏 - 而且台词听起来就像他们想要的那样:演示者之间的对话、短剧、采访、视频中角色的台词。
有两种型号可供选择:
- Gemini 3.8 Flash TTS — 富有表现力的配音:情感更丰富,节奏更自然,传递控制更精细。适用于播客、有声读物、画外音。
- Gemini 3.8 Flash-Lite TTS —同样的机制更便宜、更快:对于大卷、草稿和大声朗读文本。
有哪些设置可用?
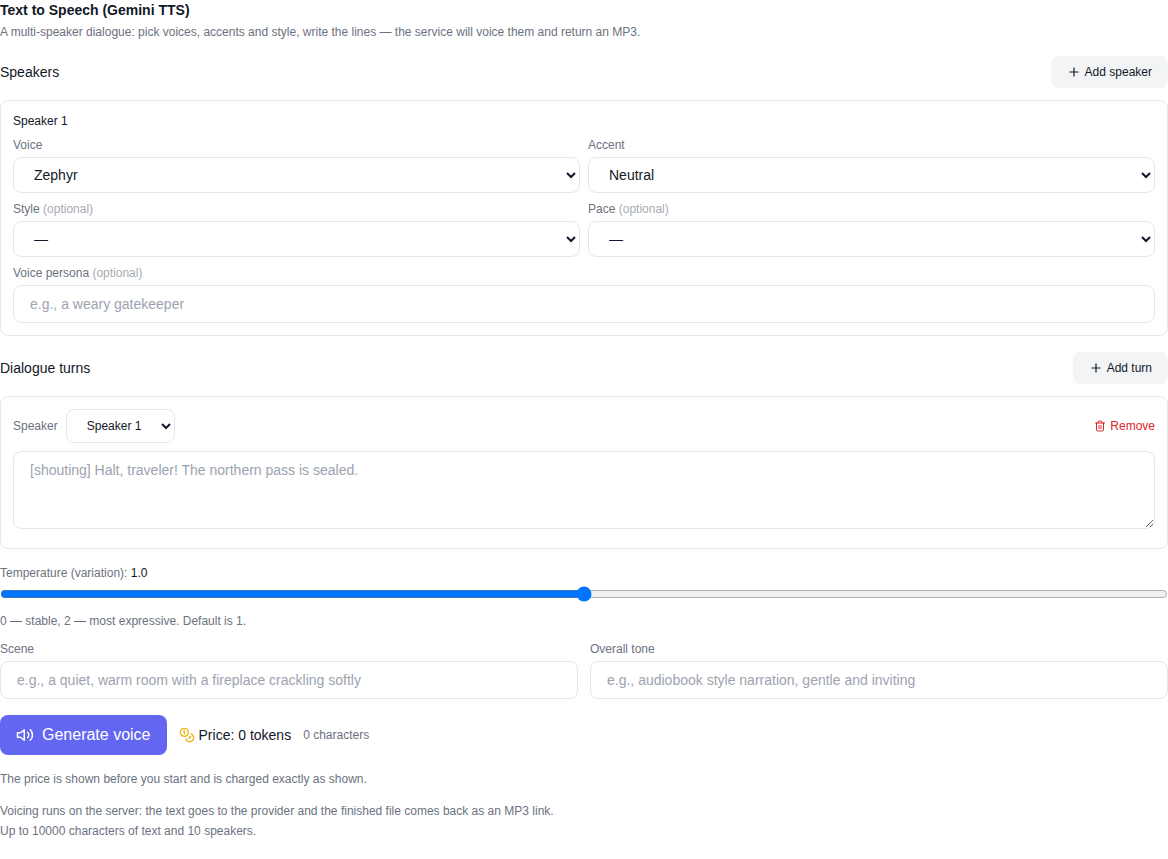
界面显示了配音模型提供的所有参数:
- 扬声器。 从一个到几个字符;每个都有自己的签名“Speaker 1”、“Speaker 2”等,通过这些签名将副本与语音相关联。
- 30 票 - 从柔和的叙事到充满活力的“新闻”。
- 8种口音 - 中立,美国(一般,“山谷”,南部),英国(RP和布里克斯顿),跨大西洋,澳大利亚。
- 6 种服务风格 ——声音中的微笑、播音员、低语、同理心、宣传和“干”均匀的语气。
- 4 语速 - 自然、流畅、流畅的“漂移”和生涩。
- 配音角色 - 自由描述,例如“温暖的讲故事的人”或“严厉的看门人”。
- 温度 - 从 0 到 2:较低 - 更加稳定和可预测,较高 - 更加活跃且更加多样化。
- 场景和总体基调 - 对环境的描述(“一个安静的房间,有噼啪作响的壁炉”)和叙述风格(“一本有声读物,柔和而诱人”)。
- 复制品 — 每行对话最多 10,000 个字符;副本的顺序被保留。
如何进行语音对话:一步一步
- 打开 “音频”部分 并选择型号 Gemini 3.8 Flash TTS 或者 Flash-LiteTTS - 它们位于型号列表的底部。
- 添加扬声器并自定义每个人的声音、口音、风格和节奏。
- 写下对话台词并确定每句台词的说话者。
- 如果需要,请填写场景描述、整体色调和温度。
- 查看价格 - 它在发布之前可见,并在您输入文本时重新计算。
- 单击“语音”,准备好后,收听结果并下载MP3。
它要多少钱
价格是根据实际文本量来计算的:复制品越长,成本就越高,而且在推出前就可见——一代后就没有什么惊喜了。与其他付费代一样,使用站点代币进行支付;如果不成功,则自动返回令牌。价格指南可以直接以以下形式查看:输入脚本时金额会更新。
常见问题
我可以为两个或多个角色之间的对话配音吗? 是的,每个扬声器都有自己的声音和设置,线路轮流。
结果是什么格式? MP3 - 页面即可收听,一键下载。
模型会说哪些语言? 该模型是多语言的:它可以用数十种语言来语音文本,包括俄语和英语。
选择什么:Flash 还是Flash-Lite? 对于富有表现力的项目 - Flash,对于大容量和草稿 - Flash-Lite:机制是相同的,但更便宜、更快。
我需要付费才能尝试吗? 注销发生在配音开始时,如果出现错误,代币会自动返还。