Нейросеть для видео: генерация по тексту, оживление фото и дубляж
Современная нейросеть для видео способна закрыть полный цикл создания визуального контента: сгенерировать ролик с нуля по тексту (Text-to-Video), превратить статичную фотографию в динамичную сцену (Image-to-Video) или перевести видео на другой язык с точной синхронизацией губ (Lip-Sync). В каталоге NeuralSpace в разделе «Видео» собраны передовые генеративные модели — линейка SeeDance (2.5, 2.0, 1.5 Pro), Kling 3.0, Grok Video, VEO 3 и Wan 2.6. В этом руководстве мы разберём, как выбрать правильную нейросеть под конкретную задачу, как формулировать промпты для предсказуемого результата и на какие технические показатели опираться при генерации роликов.
Три ключевых формата работы с видео
Генеративное видео вышло за рамки коротких абстрактных анимаций. Сегодня модели делятся по трем базовым сценариям применения:
- Генерация видео по тексту (Text-to-Video). Создание кинематографичных планов, фоновых видеорядов и рекламных концептов без готовых исходников. Модель сама формирует геометрию объектов, освещение, текстуры и траекторию камеры на основе текстового описания.
- Оживление фотографий и арта (Image-to-Video). Загружается статичное изображение (портрет, пейзаж, рендер продукта), а нейросеть добавляет естественную динамику: движение воды, колыхание ткани, мимику лица или плавный наезд камеры. Главное преимущество — сохранение оригинальной внешности и композиции.
- Перевод, дубляж и синхронизация губ (Video-to-Video / Lip-Sync). Перевод готовой речи спикера на десятки языков с автоматической перерисовкой артикуляции губ под новую звуковую дорожку. Это позволяет локализовать обучающие курсы, презентации и блоги без повторных съёмок.
Реальные данные скорости и стабильности рендеринга
Рендеринг видео требует значительных вычислительных мощностей, и время генерации сильно зависит от выбранного формата. По агрегированной статистике продакшен-пайплайна NeuralSpace за последние 90 дней (с 15 июля по 15 октября 2026 года, выборка из 9 194 видеозадач, источник — обезличенный журнал генераций video_generations) средняя доля успешно завершённых роликов составила 69,1% (6 357 готовых генераций).
Скорость и специфика распределились следующим образом:
- Оживление фото (Image-to-Video) стало самым массовым сценарием — 3 384 успешных ролика. Среднее время генерации составило 125,4 секунды (чуть более двух минут), что делает этот формат оптимальным для быстрого создания контента.
- Генерация видео по тексту (Text-to-Video) потребовала больше вычислительного времени: по 896 успешным генерациям средняя задержка составила 258,2 секунды (~4,3 минуты). При этом модели Kling 3.0 и Grok Text-to-Video показали высокую стабильность выполнения — 81,4% и 83,8% завершённых задач соответственно.
- Задачи дубляжа и видеообработки (Video-to-Video) занимают в среднем 333,4 секунды (~5,5 минут) из-за необходимости синхронного покадрового анализа лица и аудиопотока.
Анализ причин неудачных запусков показывает, что помимо технических сбоев сетевых узлов пользователи чаще всего сталкиваются с модерацией контента (153 случая отклонения запросов автоматическими фильтрами безопасности) и строгими ограничениями на распознавание публичных лиц (18 случаев). Контроль за формулировками в промпте помогает свести процент отказов к минимуму.
Как составить работающий промпт для видео
В отличие от генерации картинок, видеомодели требуют описания изменений во времени. Универсальная формула сильного промпта состоит из пяти компонентов:
- Крупность плана и ракурс: «крупный план», «съёмка с уровня глаз», «пролёт камеры от первого лица».
- Главный субъект: внешний вид персонажа, материал предмета или детали локации.
- Действие и физика: что именно происходит в динамике (не просто «море», а «волны с пеной с силой разбиваются о мокрые скалы»).
- Движение камеры: медленный наезд (push-in), плавный облет по дуге (arc shot), горизонтальная проводка (pan).
- Освещение и стиль: тёплый закатный свет, контровой свет, кинематографичный реализм, зернистость плёнки 35мм.
Если вы оживляете готовое фото, не нужно пересказывать цвета одежды или цвет глаз — модель уже видит их на картинке. В промпте для Image-to-Video описывайте исключительно динамику: «персонаж мягко улыбается, переводит взгляд в камеру, лёгкий ветер шевелит волосы, камера плавно приближается».
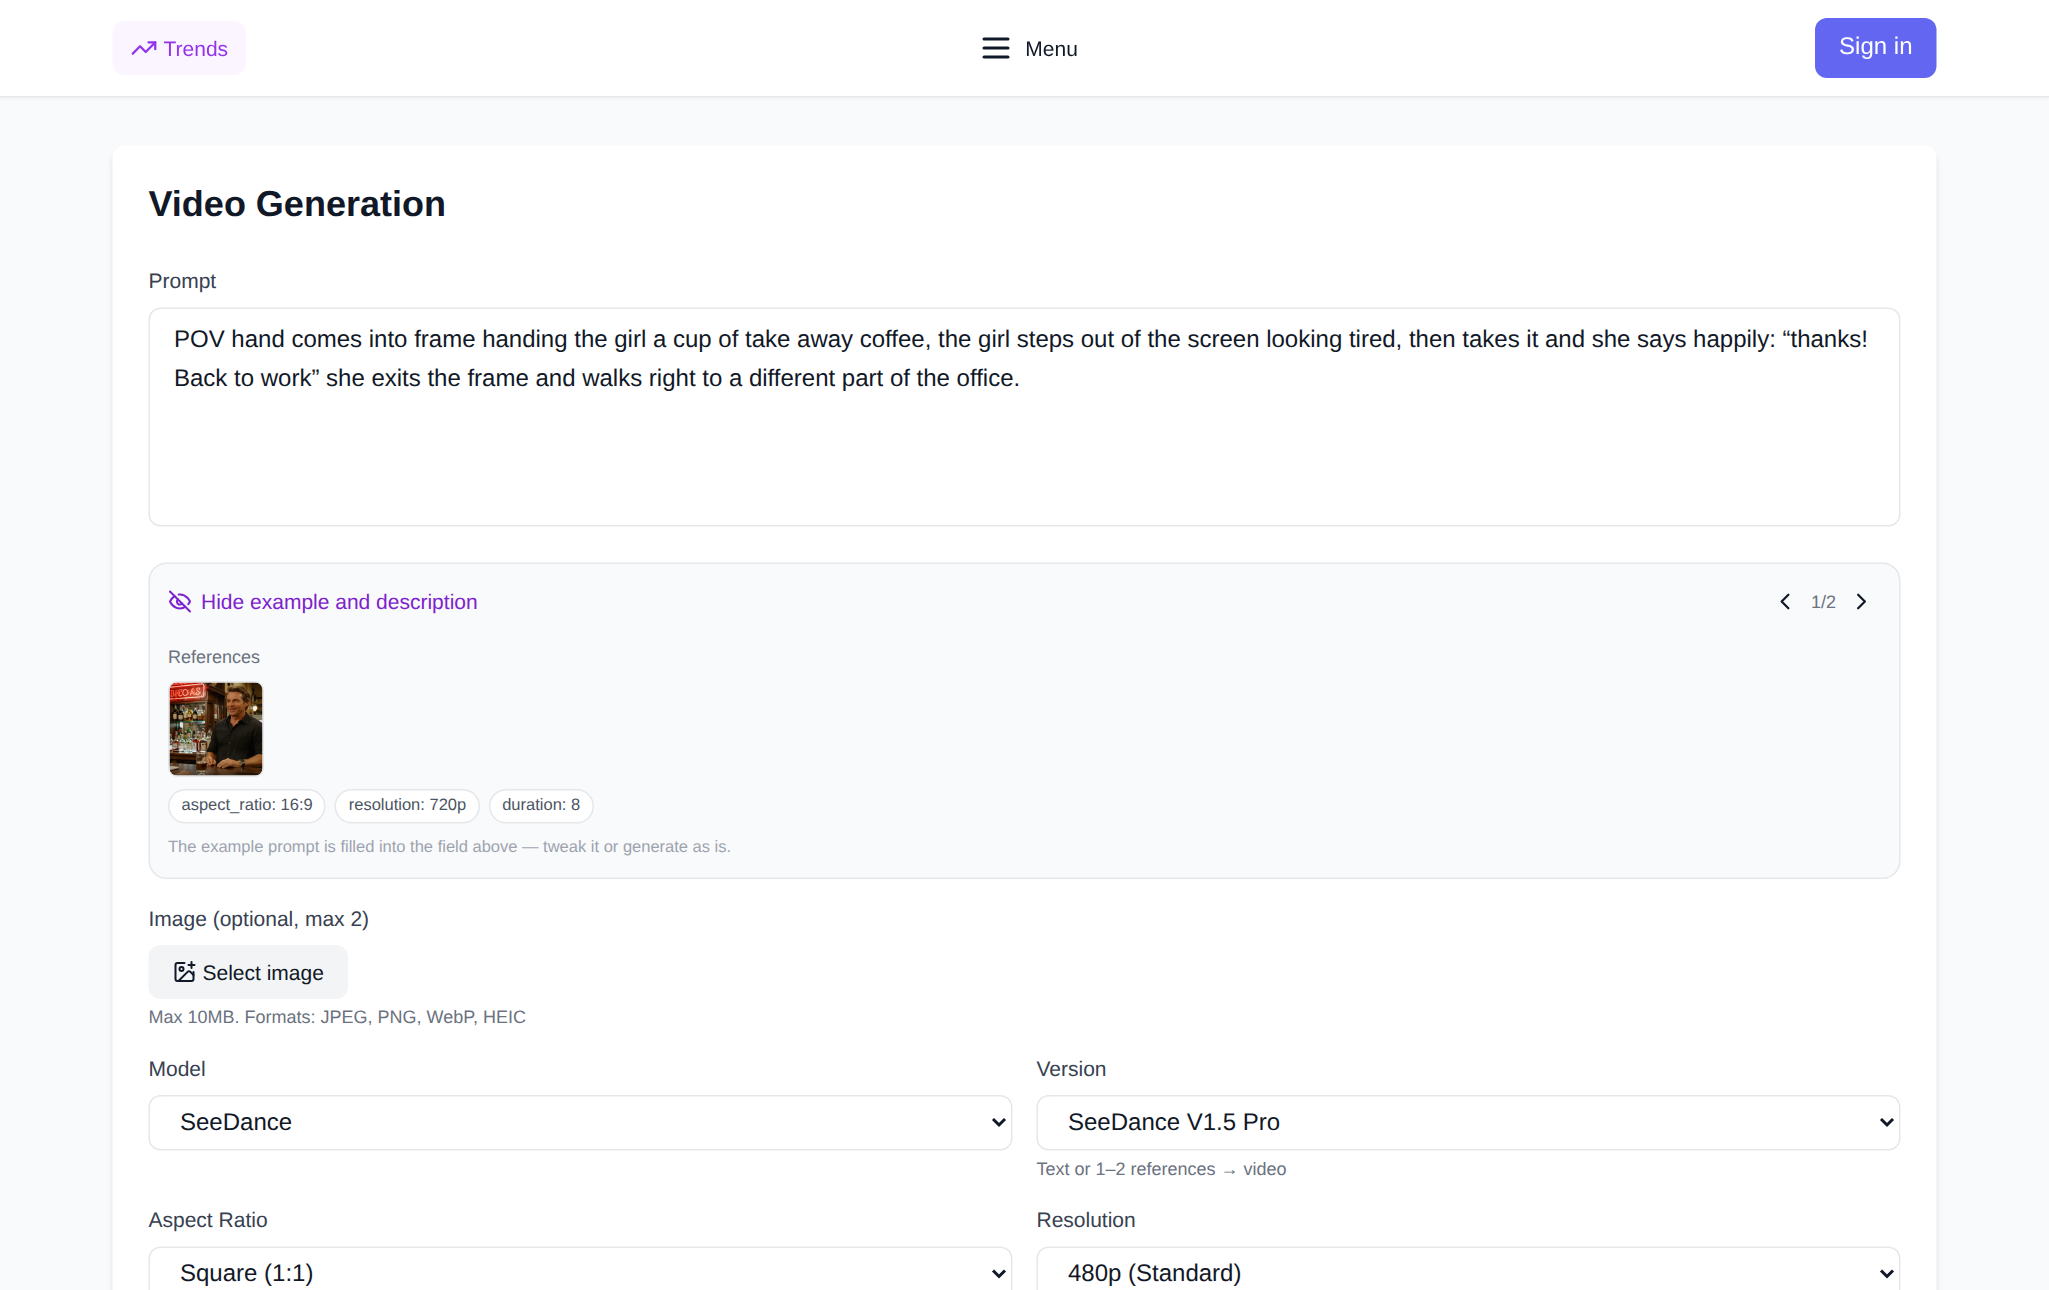
Пошаговое создание видео на NeuralSpace
Весь процесс работы с видео построен в едином веб-интерфейсе без необходимости настраивать локальные видеокарты или сложные рабочие окружения:
- Перейдите в раздел «Видео» на сайте.
- Выберите режим: если создаёте ролик с нуля — выберите вкладку Text-to-Video; если оживляете портрет или арт — загрузите исходное изображение в поле ввода.
- Выберите модель под вашу задачу (SeeDance 2.5 для длинных сцен со звуком, Kling 3.0 для сложной физики людей, Grok или Wan 2.6 для выразительного движения по фото).
- Настройте параметры: соотношение сторон (16:9 для горизонтальных видео, 9:16 для вертикальных Reels/Shorts/Клипов), желаемую длительность ролика (от 4 до 15–30 секунд) и разрешение (720p для черновика, 1080p для финала).
- Нажмите кнопку «Сгенерировать видео». Точная стоимость в токенах отображается прямо в кнопке до старта рендеринга.
Готовое видео автоматически появляется в блоке результата и сохраняется в вашей истории генераций, откуда его можно в любой момент скачать в формате MP4. На NeuralSpace нет обязательной ежемесячной подписки: новым пользователям начисляются стартовые токены для знакомства с возможностями сервиса, а дальнейшая оплата строится прозрачно за фактически потраченные токены.
Какую нейросеть выбрать под вашу задачу
Каждая архитектура имеет свои сильные стороны. Если вам нужен ролик со встроенной синхронной озвучкой и возможностью подавать до 30 визуальных референсов — выбирайте SeeDance 2.5. Если ключевой приоритет — анатомическая точность движений человека, реалистичная пластика рук и шагов — с задачей лучше всего справляется Kling 3.0. Для быстрого превращения иллюстраций в живые открытки и промо-ролики отлично подходят Grok Image-to-Video и Wan 2.6, которые аккуратно анимируют текстуры без искажения базового стиля.
Частые вопросы
Какая нейросеть лучше всего подходит для оживления фото?
Для портретов и предметных фото высоких результатов добиваются Kling 3.0 и Grok Image-to-Video: они бережно сохраняют черты лица и пропорции, добавляя реалистичное моргание, улыбку или движение камеры.
Чем генерация по тексту отличается от оживления фото?
В режиме Text-to-Video нейросеть сама фантазирует композицию, фон и внешность персонажей с чистого листа. В режиме Image-to-Video композиция и детали уже зафиксированы в вашем кадре, а нейросеть только вычисляет векторы смещения пикселей между кадрами во времени.
Сколько времени занимает генерация видео?
По реальной платформенной статистике NeuralSpace, среднее время ожидания готового ролика при оживлении фото составляет 125,4 секунды (~2 минуты), а генерация по тексту в среднем занимает 258,2 секунды (~4,3 минуты).
Нужна ли подписка для генерации видео на NeuralSpace?
Нет, сервис работает без абонентской платы. Новым пользователям начисляются стартовые токены, а дальше вы платите только за фактически запущенные генерации по прозрачному тарифу.