AI-библиотека web-ai-toolkit: шесть нейросетей прямо в браузере — бесплатно
Обычно «запустить нейросеть» значит зарегистрировать ключ, вставить карту и ждать, пока ваши файлы уедут на чужой сервер. На странице «AI-библиотека» всё ровно наоборот: шесть готовых ИИ-функций считаются прямо в вашем браузере, ни один байт документов, фото или записей не уходит с устройства, и с баланса не списывается ничего. Это открытая библиотека web-ai-toolkit под лицензией MIT — мы подняли её у себя как страницу живых примеров, где каждую функцию можно испытать на своей картинке или своём тексте, а потом забрать готовый код в проект.
Как это устроено
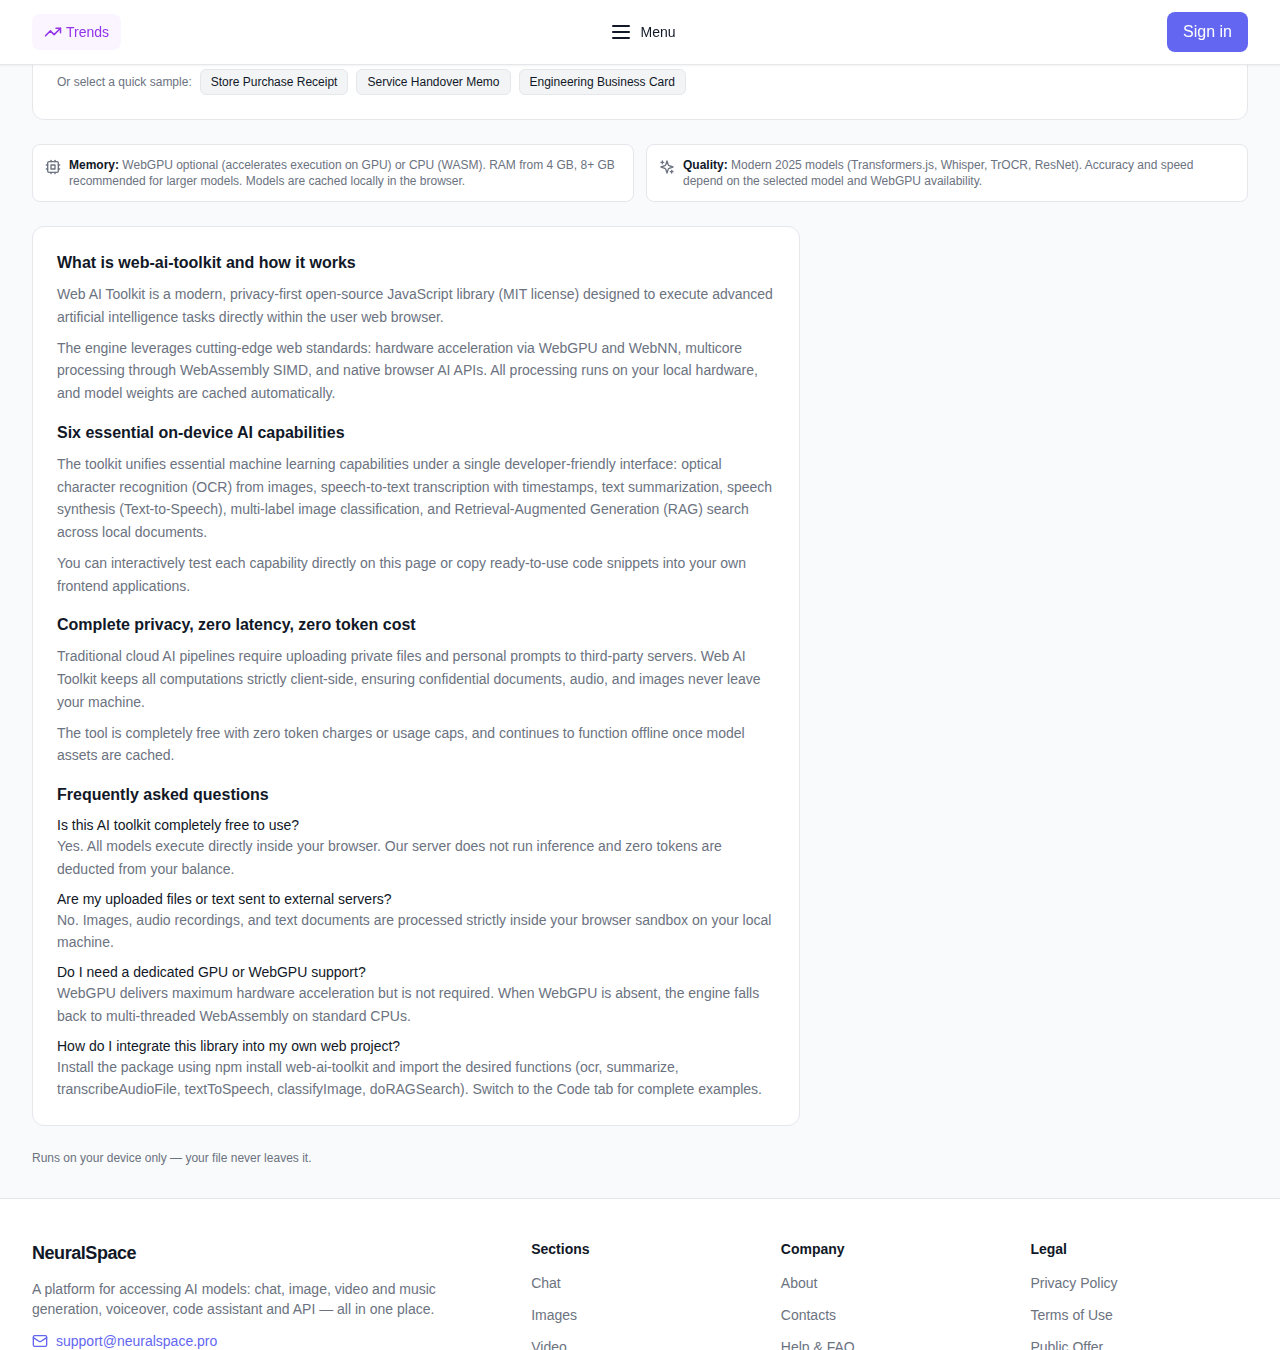
Движок построен на современном стеке веб-вычислений: аппаратное ускорение через WebGPU и WebNN, параллельные вычисления через WebAssembly SIMD и нативные браузерные API. Если WebGPU на вашем устройстве недоступен, библиотека сама переключается на оптимизированный WASM на обычном процессоре — то есть работает на любом компьютере, просто на игровом быстрее. Веса моделей скачиваются в браузер один раз и кешируются: после первой загрузки функции работают даже без интернета.
Шесть функций в одном окне
- OCR: распознавание печатного и рукописного текста с картинки или скриншота — фото договора, слайд с презентации, запись с доски.
- Речь в текст: расшифровка аудиозаписи с таймкодами, без загрузки файла куда-либо.
- Суммаризация: выжимка из длинной статьи, отчёта или договора.
- Озвучка текста: синтез речи из вашего текста средствами самого браузера.
- Классификация фото: определение объектов и категорий на изображении с оценкой уверенности.
- RAG и поиск: вставьте свои документы и задайте вопрос — инструмент найдёт и покажет релевантные фрагменты.
Каждая функция испытывается прямо на странице: перетащите файл или выберите готовый пример и нажмите «Запустить обработку» — результат можно скопировать или скачать текстом.
Код для своего проекта
Библиотека ставится одной командой — npm install web-ai-toolkit — и импортируется по функциям: ocr, summarize, transcribeAudioFile, textToSpeech, classifyImage, doRAGSearch. На странице есть вкладка «Пример кода» с готовыми фрагментами: можно не писать интеграцию с нуля, а скопировать рабочий сниппет во фронтенд приложения.
Где подвох
Первое: браузер и память. WebGPU в полной мере работает в Chrome и Edge (и в растущем списке других), первую загрузку моделей стоит пережить — она занимает время и место в кеше. Второе: это компактные локальные модели, а не гигантские облачные текстовые генераторы — качество там, где нужно, а там, где нужен серьёзный анализ языка, наш сайт предоставляет полноценные модели через баланс. Третье: озвучка опирается на встроенный синтез речи браузера, поэтому голос зависит от вашей системы, а не от выбранной в интернете нейромодели.
Зачем это в жизни
Быстро вытащить текст из скана перед отправкой юристу, разобрать часовой звонок в тезисы без отправки записи наружу, сделать черновик озвучки ролика, классифицировать сотню картинок или найти нужный пункт в пачке своих же документов — всё это типовые задачи, для которых раньше заводили облачный сервис и платили за токены. Здесь тот же сценарий закрывается без регистрации, без карты и без отправки данных кому бы то ни было.
Попробуйте: AI-библиотека web-ai-toolkit (бесплатно) на сайте — и рядом список остальных бесплатных инструментов, от суммаризатора страниц до захвата движения с веб-камеры.