Кто когда говорил бесплатно: разделение голосов и живые субтитры
После встречи, интервью или лекции остаётся запись, где говорят несколько человек, и по обычной расшифровке уже не понять, кто произнёс каждую фразу. Кто когда говорил — бесплатный браузерный инструмент: он разбирает запись по говорящим (до четырёх человек), при желании распознаёт речь и собирает диалог с метками времени, а вторая вкладка ведёт живые субтитры прямо с микрофона. Файл никуда не загружается, токены не списываются, регистрация не нужна.
Как это работает
Разделением голосов занимается модель NVIDIA Sortformer: она находит до четырёх говорящих и расставляет на шкале времени отрезки, в которых звучал каждый. Если оставить галочку «Также расшифровать речь», слова привяжутся к спикерам — получится диалог-расшифровка с подписями «Спикер 1», «Спикер 2» и дальше, которую можно скопировать или скачать в TXT, SRT, VTT или JSON. Рядом со шкалой видно, сколько спикеров модель нашла в записи.
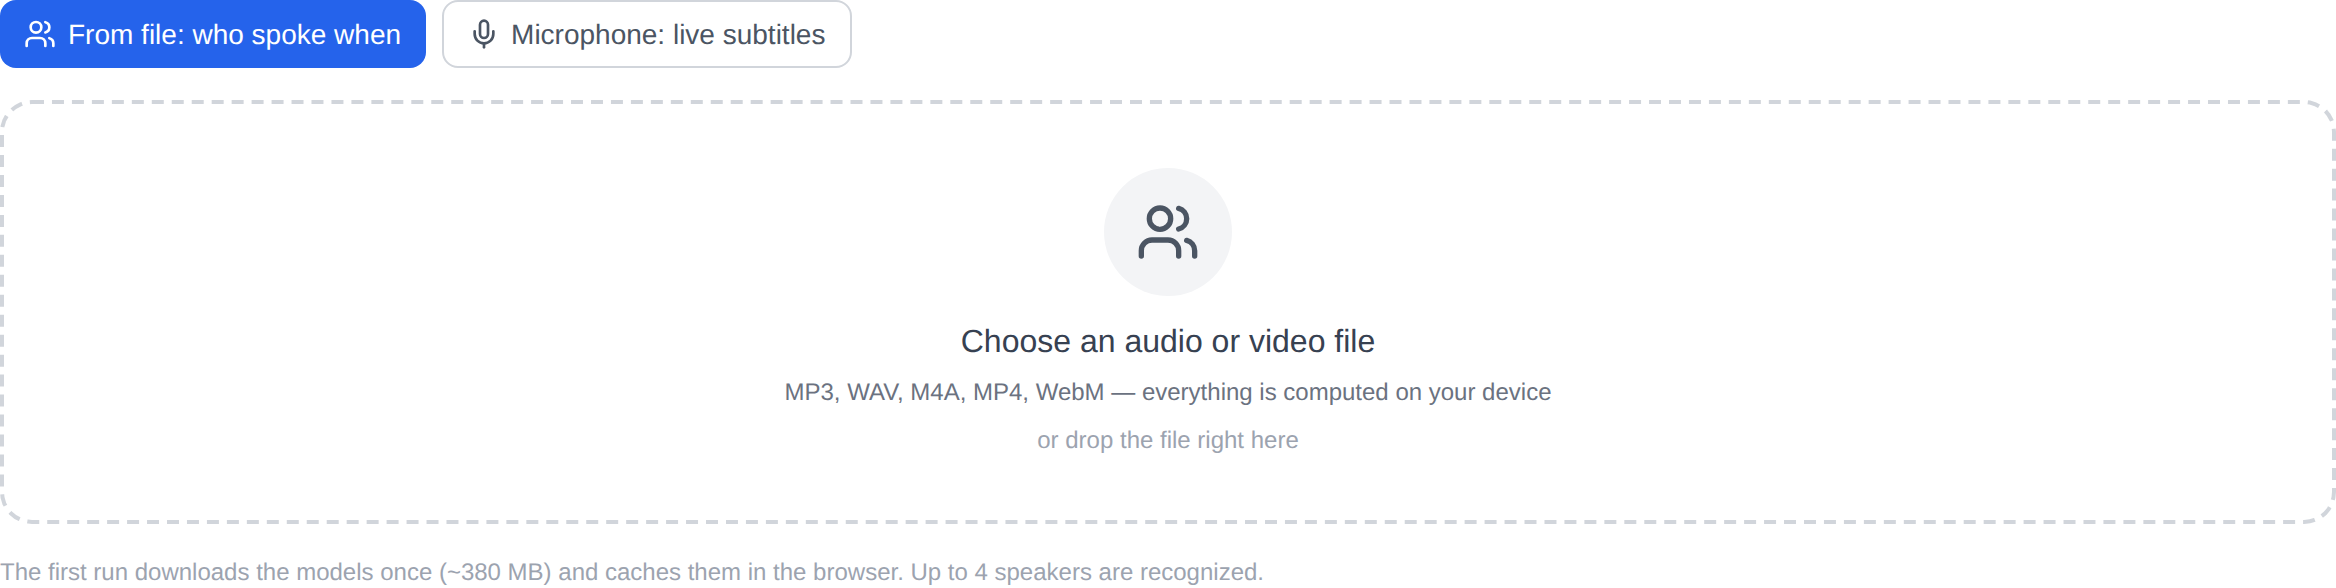
Первый запуск скачивает веса моделей на ваше устройство — суммарно около 380 МБ. Дальше они кешируются в браузере, и повторные запуски не требуют сети. На видеокарте (WebGPU) разбор идёт быстро; если поддержки нет, движок сам уходит на процессор (WASM) — медленнее, но результат тот же, и инструмент честно предупредит об этом. Звук сводится в моно 16 кГц прямо в браузере, записывать его куда-то не нужно.
Как разметить свою запись
- Откройте инструмент и выберите аудио- или видеофайл: подходят MP3, WAV, M4A, MP4 и WebM, файл можно перетащить в рамку.
- Определитесь с галочкой «Также расшифровать речь»: включённой она даёт диалог с метками времени, выключенной — только шкалу «кто и когда говорил».
- Нажмите кнопку запуска. При первом запуске подождите, пока загрузятся модели, — прогресс видно по полосе.
- Готовый результат — шкала «Кто и когда говорил» плюс диалог-расшифровка. Скопируйте текст кнопкой или скачайте его в нужном формате.
Живые субтитры с микрофона
Вторая вкладка берёт звук прямо с микрофона и подписывает фразы по мере речи: текущая фраза крупно, законченные остаются в списке ниже. Это удобно для совещания, лекции или разговора по видеосвязи, когда субтитры нужны сейчас, а не после обработки файла. Доступ к микрофону запрашивается по кнопке; ничего не записывается в файл и не уходит из браузера.
Что нужно знать заранее
Инструмент молодой и экспериментальный: качество разделения зависит от записи. Чистые микрофонные разговоры он разбирает уверенно, а записи с сильным шумом, эхом и частым перебиванием может путать. Речевым задачам нужна и память — на комфортную работу стоит рассчитывать примерно на 1 ГБ. На процессорном пути (WASM) длинная запись считается заметно медленнее, чем на видеокарте. Имена спикеров модель не угадывает: подписи «Спикер 1» и «Спикер 2» переименовываются уже после экспорта, под ваш протокол.
Кому это полезно
Журналисту — быстро найти в интервью места, где начинает говорить новый голос. Студенту — разложить запись лекции по репликам: где преподаватель, а где вопросы из зала. Редактору подкаста — отыскать в долгой записи отрезки, где говорили действительно все, и вырезать их. Секретарю встречи — собрать черновик протокола с таймкодами, не отправляя запись никуда.
Если нужен другой результат
Если нужен именно текст целиком, а не разбор по голосам, откройте аудио и видео → текст. Остальные инструменты раздела собраны на странице «Аудио», другие бесплатные локальные инструменты — в разделе «Другие инструменты». Разбор ведёт открытая библиотека FluidAudio (лицензия MIT): код и модели живут в вашем браузере, шагов на чужие серверы здесь нет.