Actorie vocală Gemini TTS: 30 de voci și toate setările
In sectiunea "Audio" a apărut un nou instrument - interpretarea vocală a dialogurilor Gemini TTS. Transformă scenariul terminat în sunet: specificați vorbitorii, vocile și caracterul acestora, iar serviciul rostește rândurile unul câte unul și returnează MP3 terminat.
Ce fel de instrument este acesta
Acest lucru nu înseamnă citirea unui text într-o singură voce, ci un text complet dialog cu mai multe vorbitoare. Fiecare personaj are propria voce, accent, stil de prezentare și tempo - iar replicile sună așa cum au fost concepute: o conversație între prezentatori, o scenetă, un interviu, replici din personaje pentru videoclip.
Doua modele disponibile:
- Gemini 3.8 Flash TTS — actorie vocală expresivă: emoții mai bogate, ritm mai natural, control mai fin al livrării. Potrivit pentru podcasturi, cărți audio, voci off.
- Gemini 3.8 Flash-Lite TTS — aceleași mecanici sunt mai ieftine și mai rapide: pentru volume mari, schițe și citirea textelor cu voce tare.
Ce setări sunt disponibile?
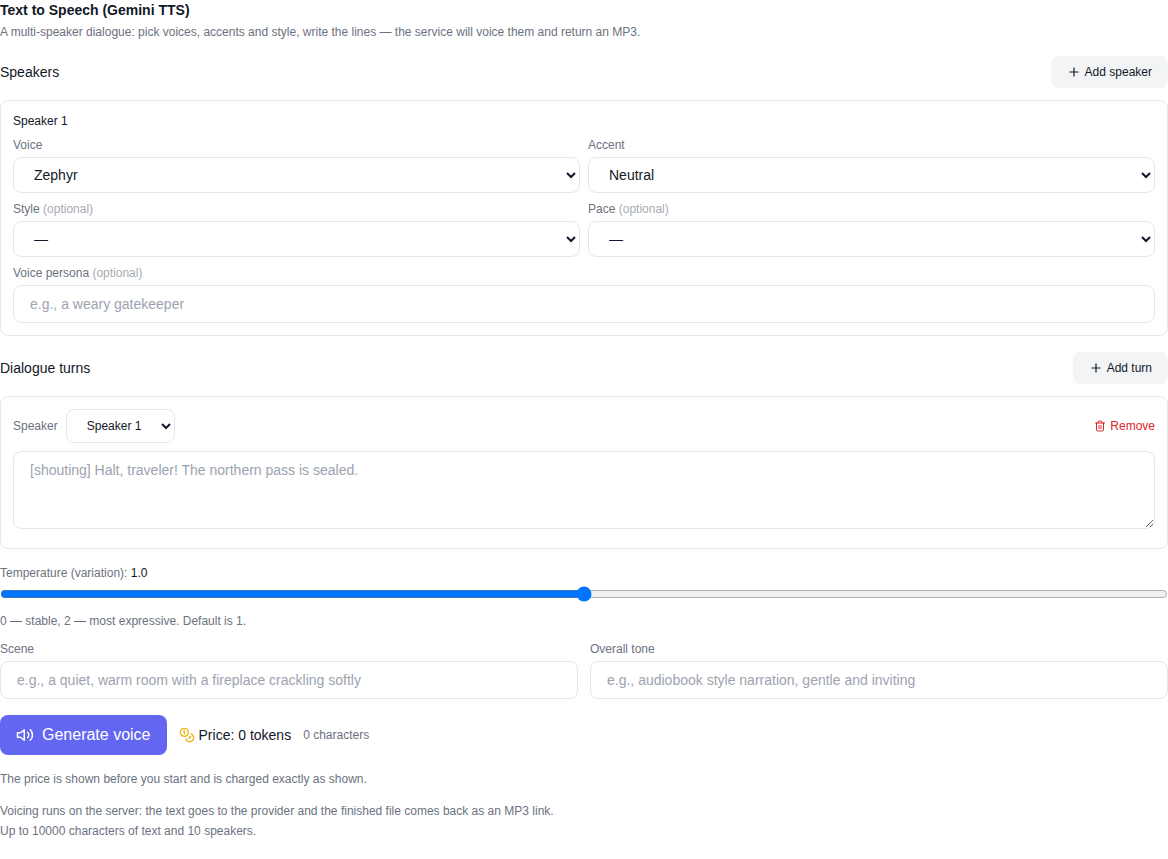
Interfața afișează toți parametrii furnizați de modelul de acționare vocală:
- Vorbitori. De la unul la mai multe personaje; fiecare are propria semnătură „Speaker 1”, „Speaker 2” și așa mai departe, prin care replicile sunt asociate cu vocea.
- 30 de voturi - de la narațiune moale la energică și „știri”.
- 8 accente - neutru, american (general, „vale”, sudic), britanic (RP și Brixton), transatlantic, australian.
- 6 stiluri de servire — un zâmbet în voce, un crainic, o șoaptă, empatie, promoție și un ton „sec” uniform.
- 4 rate de vorbire - natural, zgomot, „deriva” fin și sacadat.
- Personaj de voce - descriere gratuită, cum ar fi „povestitor cald” sau „păzitor sever”.
- Temperatură - de la 0 la 2: mai mic - mai stabil și previzibil, mai mare - mai vioi și mai variat.
- Scena și tonul general - o descriere a decorului („o cameră liniștită cu un șemineu trosnind”) și stilul narațiunii („o carte audio, moale și primitoare”).
- Replici — fiecare linie de dialog până la 10.000 de caractere; se păstrează ordinea replicilor.
Cum să exprimați dialogul: pas cu pas
- Deschide Secțiunea „Audio”. și selectați un model Gemini 3.8 Flash TTS sau Flash-LiteTTS - sunt in partea de jos a listei de modele.
- Adăugați vorbitori și personalizați vocea, accentul, stilul și tempo-ul fiecărei persoane.
- Scrieți liniile de dialog și identificați vorbitorul pentru fiecare.
- Dacă doriți, completați descrierea scenei, tonul general și temperatura.
- Uitați-vă la preț - este vizibil ÎNAINTE de lansare și este recalculat pe măsură ce introduceți text.
- Faceți clic pe „Voce” și când sunteți gata, ascultați rezultatul și descărcați MP3.
Cât costã
Prețul este calculat pe baza volumului real de text: cu cât replicile sunt mai lungi, cu atât costul este mai mare și este vizibil înainte de lansare - nu există surprize după generare. Plata se face folosind token-uri de site, ca și pentru alte generații plătite; dacă nu reușește, jetoanele sunt returnate automat. Ghidul de preț poate fi vizualizat direct în formularul: suma este actualizată în timp ce tastați scriptul.
Întrebări frecvente
Pot face voce peste dialog între două sau mai multe personaje? Da, fiecare vorbitor are propria lui voce și setări, rândurile se pe rând.
În ce format este rezultatul? MP3 - îl puteți asculta pe pagină și îl puteți descărca cu un singur buton.
Ce limbi vorbește modelul? Modelul este multilingv: transmite texte în zeci de limbi, inclusiv rusă și engleză.
Ce să alegi: Flash sau Flash-Lite? Pentru proiecte expresive - Flash, pentru volume mari și schițe - Flash-Lite: mecanica este aceeași, dar mai ieftină și mai rapidă.
Trebuie să plătesc pentru a încerca? Cancelarea are loc atunci când începe interpretarea vocală, iar dacă există o eroare, jetoanele sunt returnate automat.