Como fazer Seedance 2.0 falar a sua língua: 2 maneiras
Seedance 2.0 é ótimo para cenas de diálogo, mas uma linha escrita em um alfabeto não latino – cirílico, em nosso exemplo – nem sempre é pronunciada com clareza. Existem duas maneiras de fazer o modelo falar a sua língua: uma rápida e outra precisa.
Caminho 1: escreva a linha em letras latinas
Soletre as palavras com letras latinas. Para russo, «Privet, kak dela?» torna-se Privet, kak dela? Escreva do jeito que soa, não de acordo com regras estritas de transliteração — isso informa ao modelo qual som você precisa.
Isto aumenta a chance de um discurso claro, mas não o garante. A vantagem é a velocidade e a simplicidade: sem ferramentas extras, basta editar o texto no prompt e executar a geração.
Caminho 2: crie a voz com antecedência
Sintetize a linha que você precisa em um gerador de voz, depois carregue o áudio finalizado em Seedance 2.0 e referencie-o no prompt — o modelo aceita áudio junto com texto e imagens e dá voz à cena com sua gravação.
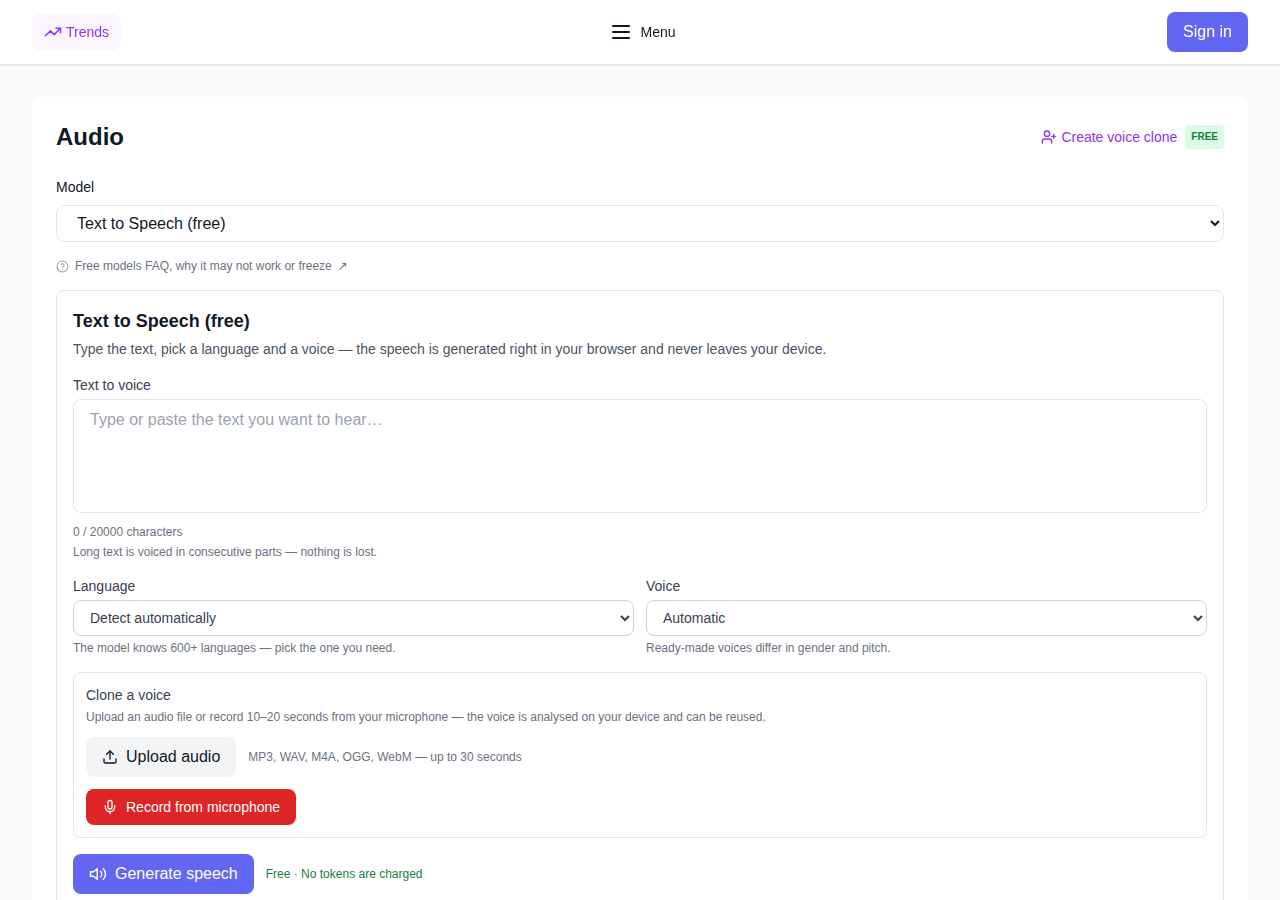
Você pode gerar sua própria voz de graça — na ferramenta do navegador Texto para fala (grátis): ele roda direto no navegador, nenhum token é cobrado e seu texto nunca sai do dispositivo.
Se você precisar de pausas e entonações específicas, isso é barato: o Texto para fala com entonação ferramenta adiciona pausas e acentos, o preço depende do tamanho do texto e é mostrado antes de você começar.
Qual escolher
- Letras latinas — rápido e simples: bom para rascunhos e linhas curtas do dia a dia.
- Uma voz pronta — voz e entonação mais precisas: para diálogos importantes no vídeo.
Perguntas frequentes
Posso enviar minha própria voz para Seedance? Sim: gere a linha em um gerador de voz e carregue o arquivo de áudio em Seedance 2.0 junto com o prompt — o modelo aceita áudio como entrada.
A geração de voz é paga? Não, a ferramenta básica de fala do navegador é gratuita e não cobra tokens. A opção paga é a fala com pausas e entonações; seu preço é mostrado antes de você começar.
Qual caminho é mais confiável? Uma gravação de áudio pronta: a voz e a entonação são exatamente as que você fez — o modelo não adivinha, ele reproduz.