Gemini 4 Argon — já está no site
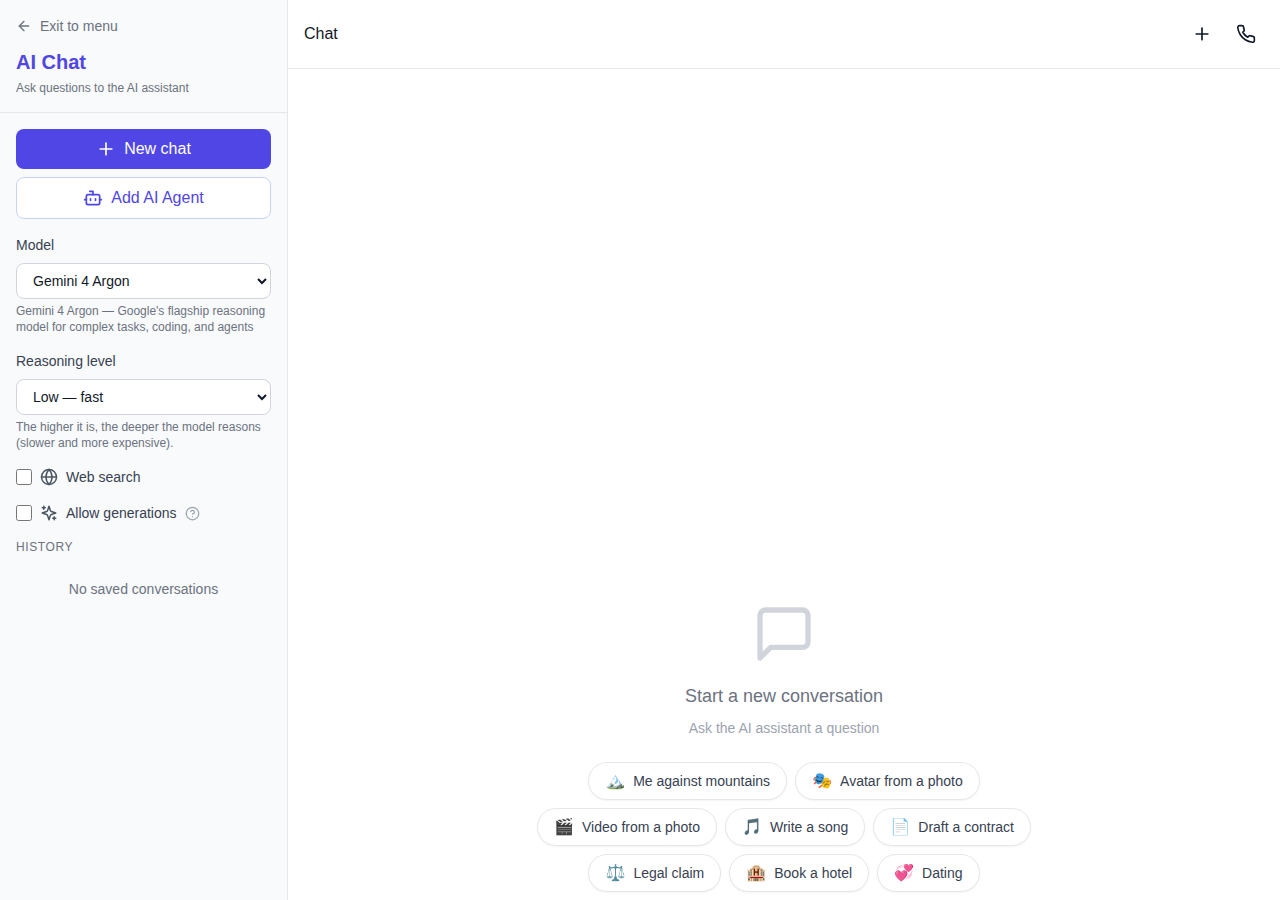
Um novo modelo apareceu em redes neurais NeuralSpace - Gemini 4 Argon de Google. Já está disponível em bater papo, seção "Código" e público API. Página de modelo separada - /chat/gemini-4-argon.
O que pode Gemini 4 Argon
- Contexto de tokens de 1 milhão. Você pode baixar um documento grande ou conduzir uma correspondência muito longa - o modelo mantém o fio da conversa do começo ao fim.
- Compreende não apenas texto. Em uma solicitação, você pode mostrar uma imagem, anexar um arquivo, áudio ou vídeo – a modelo analisará o conteúdo e responderá com base nele.
- Pense antes de responder. Problemas complexos – matemática, lógica, planos multipassos – o modelo resolve com raciocínio, e não com a primeira resposta que surge.
- Ferramentas e pesquisa na web. Assim como os modelos de chat vizinhos: você pode pedir ao modelo para encontrar informações relevantes na Internet.
- Codificação. Analisa o código existente, planeja as edições e as executa passo a passo, explicando os resultados.
Preço
O custo é calculado com base nos tokens efetivamente utilizados e é baixado após a resposta - o limite mínimo de saldo é visível antes do envio, como acontece com outros modelos da seção. Os preços atuais estão na página API.
Como tentar
- Abrir bater papo e selecione na lista de modelos Gemini 4 Argon — uma página de modelo separada está disponível em /chat/gemini-4-argon.
- Faça uma pergunta normalmente: o modelo responde com um stream e suporta pesquisa na web.
- Para projetos, abra a seção "Código" — aí o modelo funciona como um agente: cria um projeto, escreve e edita arquivos e conduz longas iterações.
O que se sabe sobre o modelo: números Google e testes independentes
A principal fonte de números é o oficial cartão modelo Gemini 4 Argon de Google DeepMind. Estas são as medições do próprio fabricante: DeepSWE v1.1 - 77,9% (codificação do agente), AutomationBench - 51,3% (tarefas de negócios ponta a ponta), CWE-bench v1 - 68% (fechamento autônomo de vulnerabilidades), LVBench - 91,7% (compreensão de vídeos longos), Vals Index - 68,9%. A janela conjunta de entrada e saída é de 1 milhão de tokens, e o limite garantido para uma resposta é de 64 mil (conforme catálogo OpenRouter); solicitar cache é 95% mais barato; preço inicial - US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, após o período introdutório - US$ 4/US$ 20.
Existem também medições independentes. Laboratório de testes Vals AI administrou o modelo em estande próprio e confirmou sua liderança: primeiro lugar entre 48 modelos em Vals Index (68,9% ± 0,97) e primeiro lugar entre 78 em Finance Agent v2. O preço do teste também é indicativo: uma execução custou aproximadamente US$ 15,68 e durou cerca de 46 minutos – o modelo é pesado, mas eficaz. Análise the-decoder.com mais contido: segundo o autor, Argon está diminuindo a distância com OpenAI e Anthropic e vencendo concorrentes em alguns benchmarks, mas não assume uma liderança clara - a Anthropic, segundo sua avaliação, ainda está à frente. Ao mesmo tempo, para um carro-chefe, o modelo é barato, principalmente pelo preço inicial.
Resumindo: os números no cartão Google são a declaração do fabricante; testes independentes até agora os confirmam para Vals Index e Finance Agent; para outros benchmarks ainda não há execuções de terceiros. Uma análise detalhada do anúncio está em nosso artigo separado. "Gemini 4 Argon: o que é conhecido". Em nosso site apenas informamos o que realmente funciona aqui: chat, “Código”, API, pesquisa na web e ferramentas.
Quando escolher Argônio
Argon é um modelo para grandes tarefas: documentos e correspondência longos, análise de arquivos e mídia, matemática complexa e scripts de agente de várias etapas. Para respostas rápidas do dia a dia no chat existem modelos leves - por exemplo Claude Haiku 5.5, e para máxima profundidade de raciocínio - os mais antigos Claude Sonnet 5.5 e Claude Opus 5.5.