Innlesing av dialoger med Gemini TTS: 30 stemmer og alle innstillinger
I seksjonen "Lyd" et nytt verktøy har dukket opp - stemmehandling av dialoger Gemini TTS. Det gjør det ferdige manuset til lyd: du spesifiserer talerne, deres stemmer og karakter, og tjenesten leser linjene én etter én og returnerer den ferdige MP3.
Hva slags instrument er dette
Dette er ikke å lese én tekst med én stemme, men en full dialog med flere talere. Hver karakter får sin egen stemme, aksent, presentasjonsstil og tempo – og replikkene høres ut slik de var ment: en samtale mellom programlederne, en sketsj, et intervju, replikker fra karakterene til videoen.
To modeller tilgjengelig:
- Gemini 3.8 Flash TTS — uttrykksfull stemmeføring: rikere følelser, mer naturlig rytme, finere kontroll over levering. Egnet for podcaster, lydbøker, voice-overs.
- Gemini 3.8 Flash-Lite TTS — den samme mekanikken er billigere og raskere: for store volumer, utkast og høytlesing av tekster.
Hvilke innstillinger er tilgjengelige?
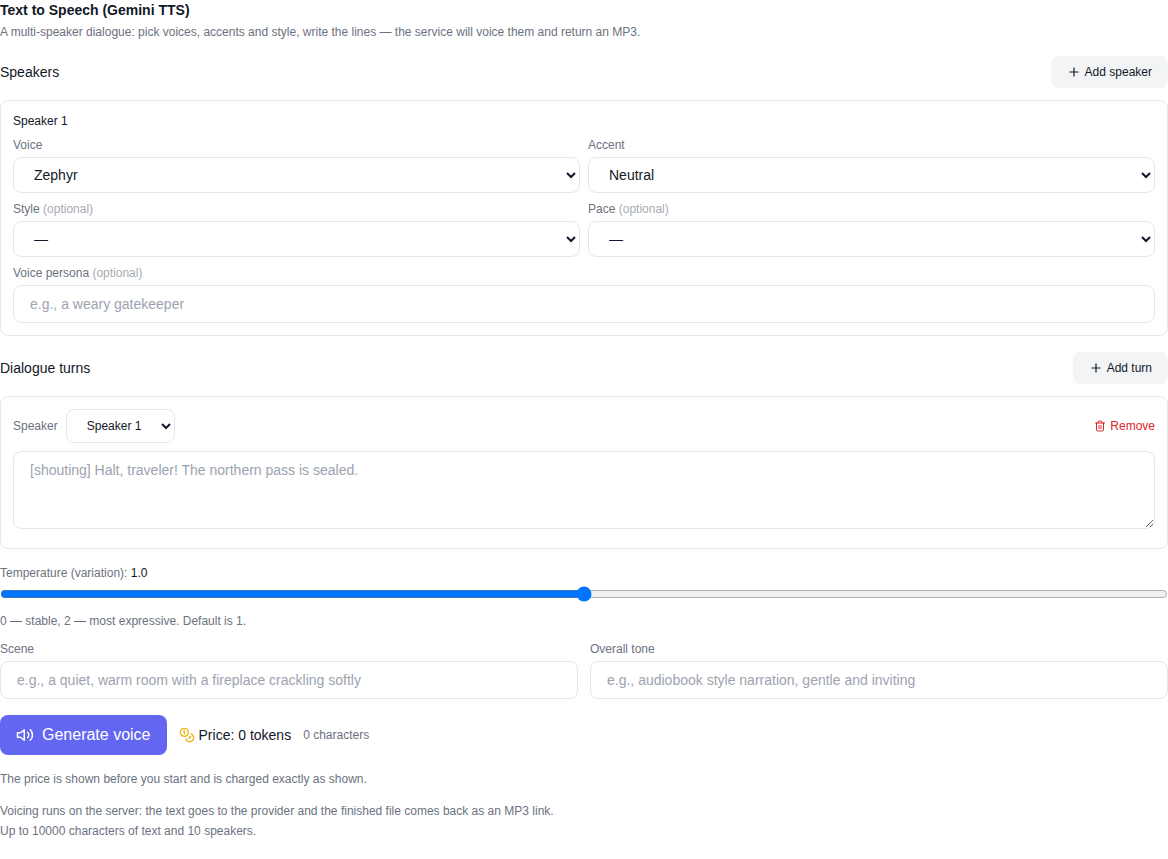
Grensesnittet viser alle parameterne gitt av innlesingmodellen:
- Talere. Fra én til flere karakterer; hver har sin egen signatur "Speaker 1", "Speaker 2" og så videre, som replikaene er assosiert med stemmen.
- 30 stemmer - fra myk narrativ til energisk og "nyheter".
- 8 aksenter - nøytral, amerikansk (generell, "dal", sørlig), britisk (RP og Brixton), transatlantisk, australsk.
- 6 serveringsstiler — et smil i stemmen, en kunngjører, en hvisking, empati, promo og en «tørr» jevn tone.
- 4 talehastigheter - naturlig, klapper, jevn "drift" og rykk.
- Stemmekarakter - gratis beskrivelse, for eksempel "varm historieforteller" eller "stern gatekeeper."
- Temperatur - fra 0 til 2: lavere - mer stabil og forutsigbar, høyere - livligere og mer variert.
- Scene og generell tone - en beskrivelse av omgivelsene ("et stille rom med en knitrende peis") og fortellerstilen ("en lydbok, myk og innbydende").
- Replikaer — hver linje med dialog opp til 10 000 tegn; rekkefølgen på kopiene er bevart.
Slik leser du inn dialog: trinn for trinn
- Åpne "Lyd"-delen og velg en modell Gemini 3.8 Flash TTS eller Flash-LiteTTS - de er nederst på listen over modeller.
- Legg til talere og tilpass hver persons stemme, aksent, stil og tempo.
- Skriv linjene i dialogen og identifiser taleren for hver.
- Om ønskelig, fyll ut scenebeskrivelsen, generell tone og temperatur.
- Se på prisen – den er synlig FØR lansering og beregnes på nytt etter hvert som du skriver inn tekst.
- Klikk på «Voice» og når du er klar, lytt til resultatet og last ned MP3.
Hvor mye koster det
Prisen beregnes basert på det faktiske volumet av tekst: jo lengre kopiene er, desto høyere koster det, og det er synlig før lansering - det er ingen overraskelser etter generering. Betaling gjøres ved å bruke nettstedssymboler, som for andre betalte generasjoner; hvis det ikke lykkes, returneres tokens automatisk. Prisguiden kan sees direkte i skjemaet: beløpet oppdateres mens du skriver scriptet.
Ofte stilte spørsmål
Kan jeg lese inn en dialog mellom to eller flere karakterer? Ja, hver taler har sin egen stemme og innstillinger, linjene bytter på.
I hvilket format er resultatet? MP3 - du kan lytte til den på siden og laste den ned med én knapp.
Hvilke språk snakker modellen? Modellen er flerspråklig: den uttaler tekster på dusinvis av språk, inkludert russisk og engelsk.
Hva skal jeg velge: Flash eller Flash-Lite? For uttrykksfulle prosjekter - Flash, for store volumer og utkast - Flash-Lite: mekanikken er den samme, men billigere og raskere.
Må jeg betale for å prøve? Avskrivningen skjer når stemmehandling starter, og hvis det er en feil, returneres tokens automatisk.