Siapa yang bercakap apabila percuma: pemisahan suara dan sari kata
Sebarang rakaman dengan lebih daripada satu suara meninggalkan anda dengan soalan yang sama: "siapa yang berkata demikian?". Siapa yang Bercakap Bila (percuma) menjawabnya terus dalam penyemak imbas anda: alat ini mencari tempat baris bermula dan berakhir, mengisihnya mengikut pembesar suara — "Speaker 1", "Speaker 2" dan seterusnya, sehingga empat orang — dan, jika anda mahu, tambahkan teks itu juga. Fail tidak pernah dimuat naik, tiada token dikenakan dan tiada akaun diperlukan.
Cara pemisahan pembesar suara berfungsi
Tugas itu dipanggil diarisasi: model mendengar keseluruhan aliran dan menjawab dua soalan secara berasingan — siapa yang bercakap, dan dalam minit mana. Suara dibandingkan dengan timbre, jadi garisan daripada orang yang sama mendarat di satu trek walaupun orang bercakap antara satu sama lain. Perkara yang anda dapat kembali ialah garis masa: setiap baris ialah baris pertuturan dengan cap masa sendiri dan label pembesar suara.
Semuanya dikira pada peranti anda. Model memuat turun ke dalam penyemak imbas anda sekali dan kemudian berfungsi di luar talian; pada kad grafik melalui WebGPU analisis berjalan dengan ketara lebih pantas, dan jika penyemak imbas tidak akan menyerah, ia akan kembali kepada pemproses melalui WASM — betul, tetapi perlahan. Semak nota memori sebelum rakaman yang panjang: model mahu kira-kira gigabait berjalan dengan selesa.
Menganalisis fail langkah demi langkah
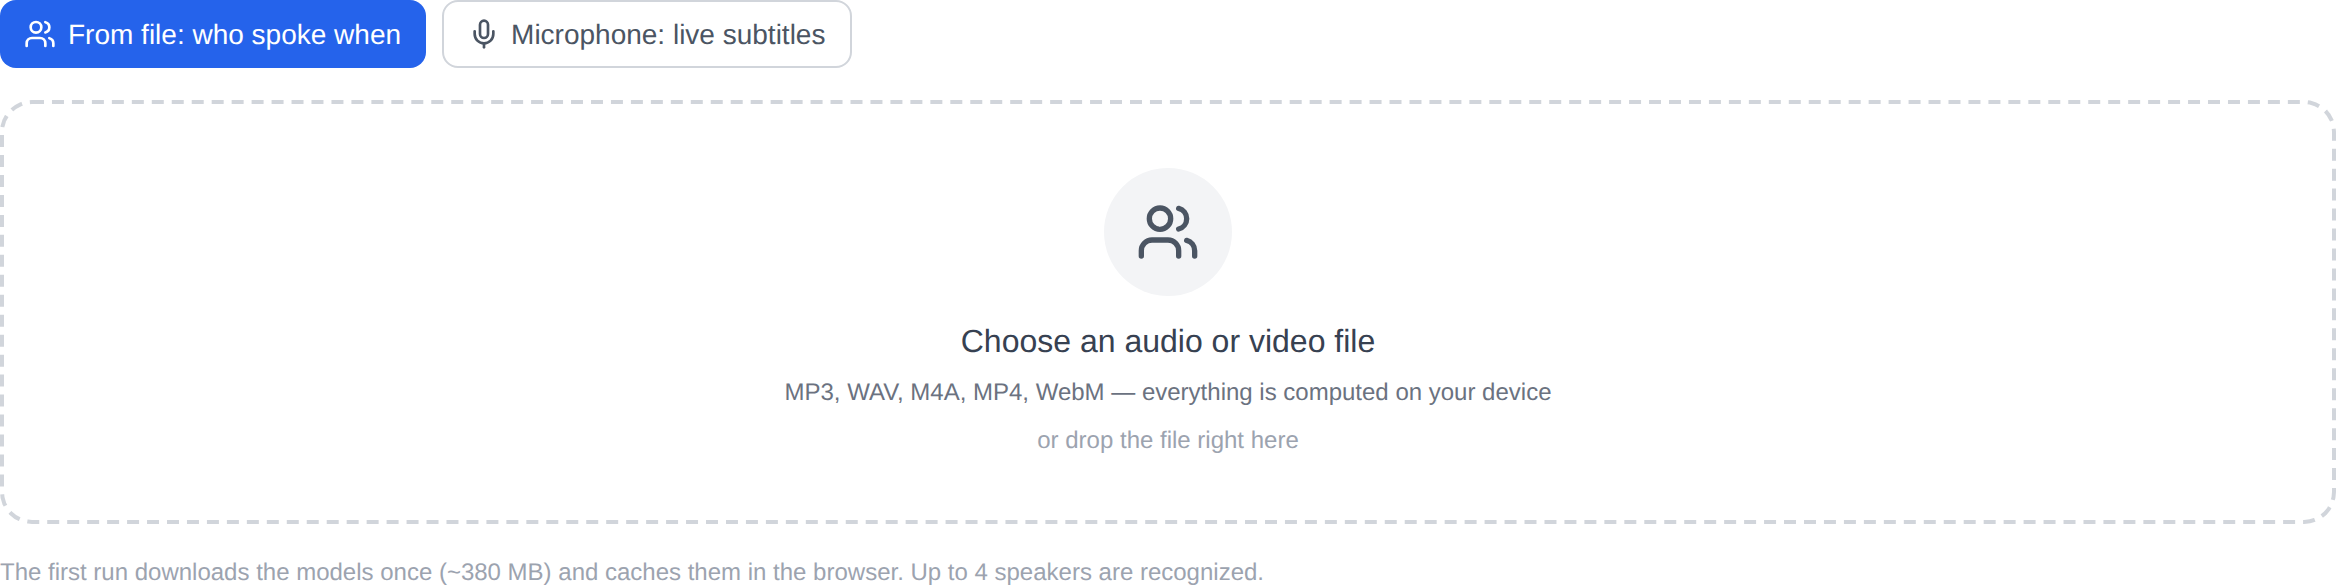
- Buka alat dan, pada tab fail, pilih rakaman: MP3, WAV, M4A, MP4, WebM dan fail media lain diterima.
- Kotak pilihan "Terjemahkan juga ucapan" membawa masuk model teks: perkataan diletakkan pada trek pembesar suara dan dipasang ke dalam dialog yang boleh dibaca. Dengan dimatikan, alat ini hanya membahagikan rakaman dengan suara, yang lebih pantas.
- Larian pertama memuat turun model (kira-kira 380 MB) dan menyimpannya dalam cache; analisis seterusnya bermula serta-merta.
- Tunggu garis masa dan dialog, kemudian salin hasilnya atau eksportnya sebagai TXT, SRT, VTT atau JSON. Dalam sari kata SRT dan VTT setiap baris mengandungi nama pembesar suaranya, jadi fail dipalamkan terus ke editor video.
Sari kata langsung daripada mikrofon
Tab kedua tidak memerlukan fail: hidupkan mikrofon anda dan frasa mula muncul pada skrin semasa anda bercakap. Frasa siap bergerak ke dalam senarai dengan cap masa manakala yang seterusnya menaip sendiri di bawah. Bunyi tidak dirakam dan tidak dihantar ke pelayan — sari kata hanya hidup di halaman anda dan anda boleh menyemaknya pada bila-bila masa dengan tab rangkaian dalam alatan pembangun anda. Ia sesuai dengan panggilan, mesyuarat dan kuliah di mana anda memerlukan transkrip semasa perbualan masih berjalan, bukan selepas itu.
Had jujur
Ini ialah alat pemisah pembesar suara, bukan transkrip universal. Model pengecaman pertuturan dilatih terutamanya dalam bahasa Inggeris: ia akan menyalin perbualan dalam bahasa lain, tetapi dengan lebih banyak kesilapan daripada bahasa Inggeris. Sehingga empat pembesar suara dipisahkan dengan pasti; rakaman dari dewan yang bising dengan gangguan akan lebih buruk daripada wawancara yang tenang. Transkrip dengan nama pembesar suara bukanlah transkripsi profesional, jadi bacalah sebelum meneruskannya.
Perkakasan ialah had lain: peranti yang lemah mungkin tidak mempunyai memori yang mencukupi untuk model dan analisis pemproses sahaja mengambil sedikit masa. Sebagai pertukaran, harga tidak ditetapkan: tiada giliran, tiada caj, tiada muat naik.
Siapa yang sesuai
Seorang wartawan boleh melihat struktur temu bual dan mengeluarkan petikan dalam beberapa minit. Hos mesyuarat boleh mendapatkan rekod "siapa berkata apa" tanpa menyental pita itu. Editor video boleh memasukkan sari kata dengan nama pembesar suara ke dalam projek melalui SRT atau VTT. Seorang pelajar boleh memecahkan syarahan kepada baris dan perkara bercakap.
Jika anda memerlukan teks tanpa pemisahan pembesar suara dan dalam banyak bahasa, pengecaman pertuturan (percuma) berjalan bersama. Bahagian selebihnya tinggal di Audio halaman, dan alat tempatan percuma dikumpulkan di bawah Alat Lain. Mulakan dengan rakaman pendek lima minit: satu larian pertama dengan muat turun model sudah cukup untuk mendengar cara rakaman anda bertahan dalam analisis.