Lakonan suara Gemini TTS: 30 suara dan semua tetapan
Dalam bahagian "Audio" alat baru telah muncul - lakonan suara dialog Gemini TTS. Ia menukar skrip yang telah siap menjadi bunyi: anda menentukan penceramah, suara dan watak mereka, dan perkhidmatan menyuarakan baris satu demi satu dan mengembalikan MP3 yang telah selesai.
Apakah jenis instrumen ini
Ini bukan membaca satu teks dalam satu suara, tetapi penuh dialog berbilang penceramah. Setiap watak mendapat suara, loghat, gaya persembahan dan tempo sendiri - dan baris berbunyi seperti yang dimaksudkan: perbualan antara penyampai, skit, temu bual, baris daripada watak untuk video.
Dua model tersedia:
- Gemini 3.8 Flash TTS — lakonan suara ekspresif: emosi yang lebih kaya, irama yang lebih semula jadi, kawalan penyampaian yang lebih halus. Sesuai untuk podcast, buku audio, suara.
- Gemini 3.8 Flash-Lite TTS — mekanik yang sama adalah lebih murah dan lebih pantas: untuk volum besar, draf dan membaca teks dengan kuat.
Apakah tetapan yang tersedia?
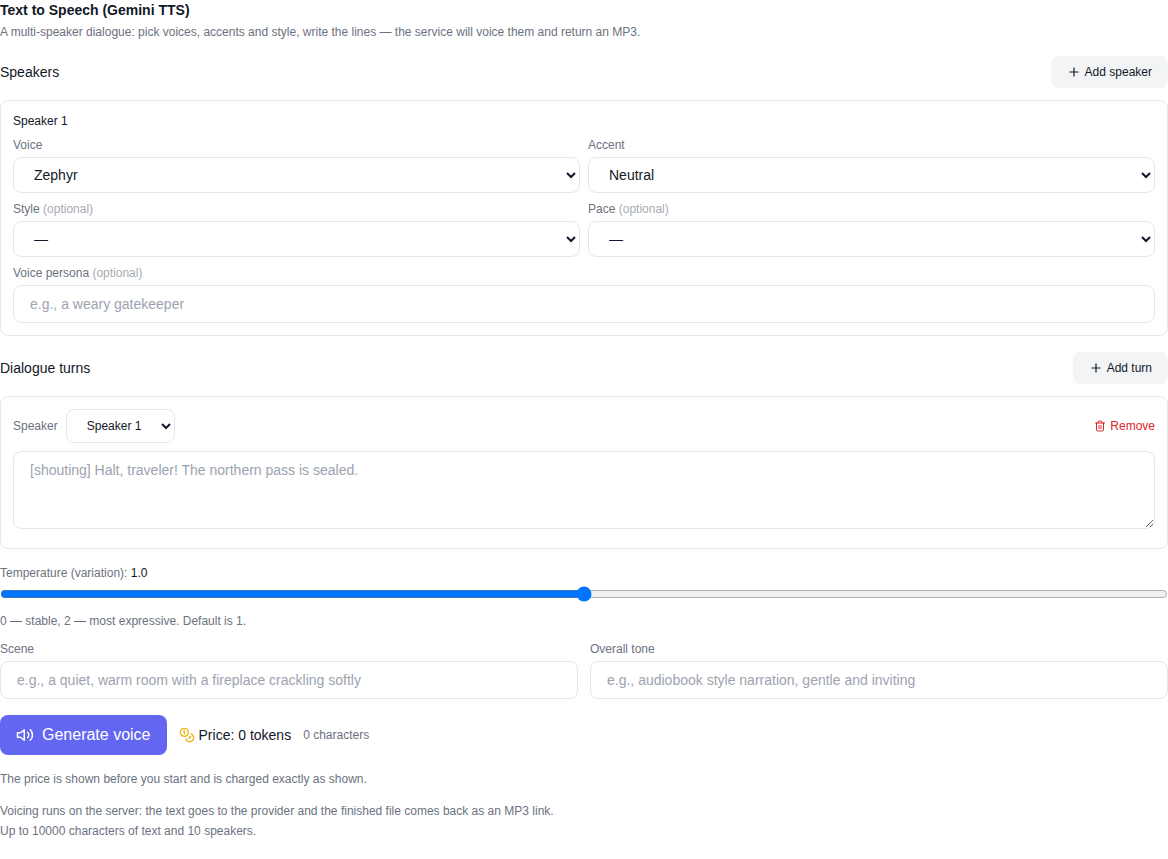
Antara muka memaparkan semua parameter yang disediakan oleh model lakonan suara:
- Penceramah. Daripada satu kepada beberapa aksara; masing-masing mempunyai tandatangan sendiri “Speaker 1”, “Speaker 2” dan seterusnya, yang mana replika dikaitkan dengan suara.
- 30 undi - daripada naratif lembut kepada bertenaga dan "berita".
- 8 aksen - neutral, Amerika (umum, "lembah", selatan), British (RP dan Brixton), transatlantik, Australia.
- 6 gaya hidangan — senyuman dalam suara, juruhebah, bisikan, empati, promo dan nada sekata "kering".
- 4 kadar pertuturan - semula jadi, bercorakkan, "hanyut" licin dan dendeng.
- Watak suara - penerangan percuma, seperti "pencerita yang hangat" atau "penjaga pintu yang tegas".
- Suhu - dari 0 hingga 2: lebih rendah - lebih stabil dan boleh diramal, lebih tinggi - lebih meriah dan lebih pelbagai.
- Adegan dan nada umum - perihalan suasana (“bilik yang tenang dengan pendiangan yang berderak”) dan gaya penceritaan (“buku audio, lembut dan menarik”).
- replika — setiap baris dialog sehingga 10,000 aksara; susunan replika terpelihara.
Cara menyuarakan dialog: langkah demi langkah
- Buka Bahagian "Audio". dan pilih model Gemini 3.8 Flash TTS atau Flash-LiteTTS - mereka berada di bahagian bawah senarai model.
- Tambahkan penceramah dan sesuaikan suara, loghat, gaya dan tempo setiap orang.
- Tulis baris dialog dan kenal pasti penceramah bagi setiap satu.
- Jika mahu, isikan perihalan pemandangan, nada keseluruhan dan suhu.
- Lihat pada harga - ia kelihatan SEBELUM pelancaran dan dikira semula semasa anda memasukkan teks.
- Klik “Suara” dan apabila sudah bersedia, dengarkan hasilnya dan muat turun MP3.
Berapa kosnya
Harga dikira berdasarkan volum sebenar teks: lebih panjang replika, lebih tinggi kos, dan ia boleh dilihat sebelum pelancaran - tiada kejutan selepas generasi. Pembayaran dibuat menggunakan token tapak, seperti untuk generasi berbayar lain; jika tidak berjaya, token dikembalikan secara automatik. Panduan harga boleh dilihat terus dalam borang: jumlah dikemas kini semasa anda menaip skrip.
Soalan lazim
Bolehkah saya menyuarakan dialog antara dua atau lebih watak? Ya, setiap penceramah mempunyai suara dan tetapan sendiri, barisan bergilir-gilir.
Dalam format apakah hasilnya? MP3 - anda boleh mendengarnya pada halaman dan memuat turunnya dengan satu butang.
Apakah bahasa yang digunakan oleh model itu? Model ini berbilang bahasa: ia menyuarakan teks dalam berpuluh-puluh bahasa, termasuk Rusia dan Inggeris.
Apa yang perlu dipilih: Flash atau Flash-Lite? Untuk projek ekspresif - Flash, untuk volum dan draf yang besar - Flash-Lite: mekanik adalah sama, tetapi lebih murah dan lebih pantas.
Adakah saya perlu membayar untuk mencuba? Hapus kira berlaku apabila lakonan suara bermula, dan jika terdapat ralat, token dikembalikan secara automatik.