Seedance 2.5 の深度マップ: 顔のブロックをバイパスする方法
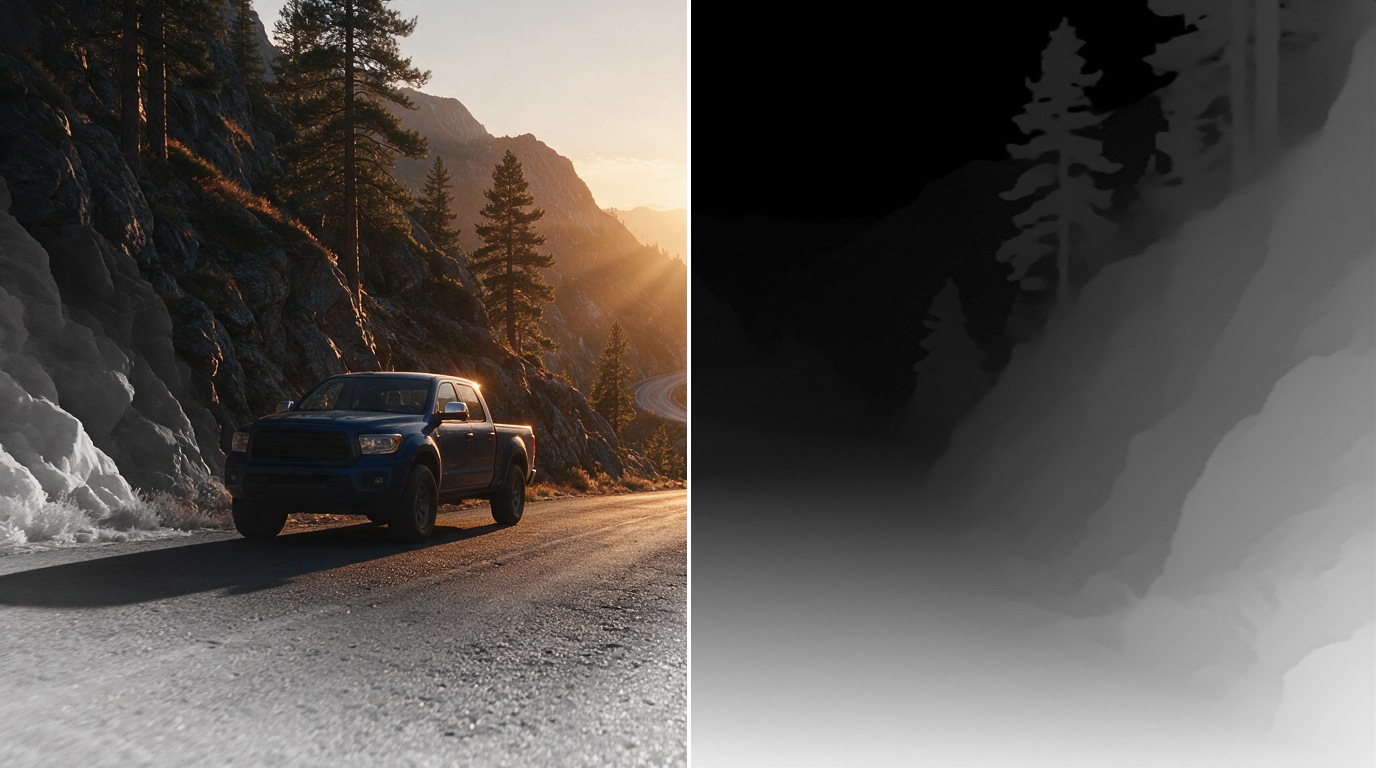
Seedance 2.5 は、フレーム内に認識できる顔や他人のフィルムが映っている場合、作業を拒否します。これが、同社が有名人の偽物と戦う方法だが、それは一般の人々にも及ぶ。モデルが自分のセルフィーを拒否することさえある。回避策はありますが、それはハッキングに関するものではありません。モデルは、深度マップ (明るさがカメラまでの距離を示す白黒画像) を簡単に通過します。そこには顔はなく、シーンのジオメトリのみが表示されます。以下は、ビデオからこのようなマップをブラウザ上で無料で作成する方法と、それでも世代が落ちた場合の対処法です。
なぜモデルはセレブがいないのにセレブを見るのでしょうか?
フィルター Seedance は顔に対してトレーニングされます。彼らの仕事は単純です。有名人の外見が偽造されるのを防ぐことです。問題は、彼らがクレジット内の名前ではなく、顔の形状によって「名声」を定義していることです。目の形も顎の形も似ている、それだけです、拒否です。
映画の映像では著作権保護が機能するため、さらに簡単です。モデルはシーンを認識し、カメラの動きを繰り返したいだけであっても、完全に見逃すことはありません。
結果: 2 つの異なる禁止事項がありますが、見た目は同じです - 赤い間違いであり、時間の無駄です。
深度マップ: 面の代わりにジオメトリ
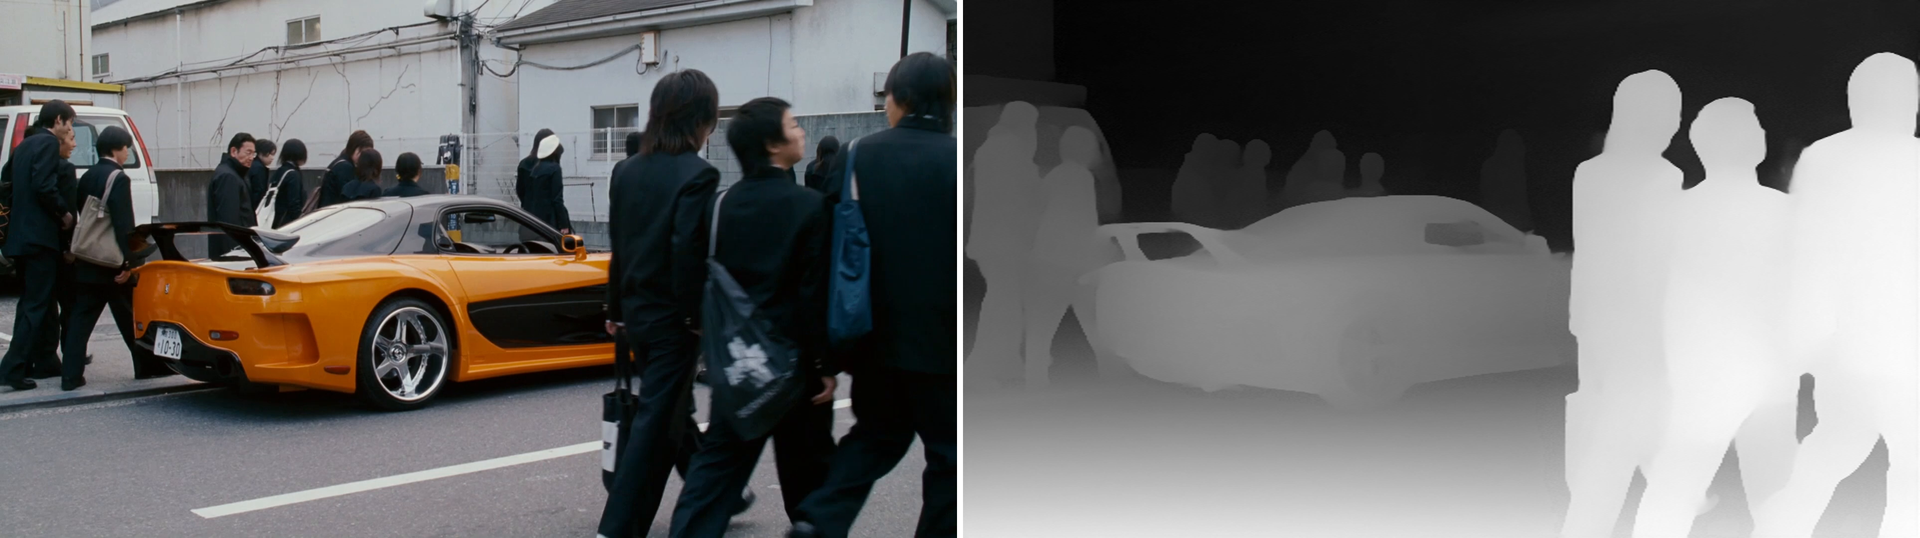
深度マップは同じビデオであり、グレースケールで再描画されただけです。オブジェクトがカメラに近づくほど、ピクセルは明るくなります。背景が黒にフェードインし、背景が白に変わります。テクスチャも肌も目もありません。残っているのはシーンのレリーフだけです。
これがフィルターの重要なポイントです。チェックするものは何もありません - 顔がありません。そして生成には、オブジェクトがどこにあったか、カメラがどこに向かっていたか、計画がどのように変更されたかなど、必要なものがすべてあります。誰かのフレームを模倣するのではなく、そこから動きや配置を取り入れ、モデルが自分で一から絵を描きます。
制限について正直に言うと、これは「すべてをバイパスするボタン」ではありません。すぐに特定の俳優の顔を直接尋ねると、また拒否が来ます。深度マップは、人格の置き換えではなく、ジオメトリと動きの問題を解決します。
ビデオから深度マップを作成する方法 - 無料でサーバーにアップロードせずに
私たちの Web サイトでは、これはビデオ セクションの別のモデルです。 デプスマップ(無料)。 MiniMaxのモデルリストにあります。ビデオを選択してボタンを押すと、すべてがデバイス上で計算されます。
内容: モデル Depth Anything V2 Small (ライセンス Apache 2.0) は、ONNX Runtime Web を介してブラウザで直接再生されます。 WebGPU がある場合はビデオ カードがカウントされますが、そうでない場合はプロセッサ上のバックアップ パスが機能します。フレームは WebCodecs で解析され、元の FPS とブラウザが処理できる最大解像度でビデオに再組み立てされます。
出力は、ブラウザーがサポートする MP4 または WebM です。結果のプレビュー、「近く - 明るい / 近く - 暗い」スイッチ、およびパレット: グレーの色合い、Inferno、Viridis があります。処理の進行状況はフレームごとに表示されます。長時間の処理をキャンセルすることができます。
最も重要なことは 2 つあります。第一に、ファイルはどこにも送信されません。私たちのサーバーにも他の人のサーバーにも送信されず、すべての作業はデバイス上で行われます。 2 番目: これによりトークンは消失しません。このモデルには有料 API はまったくありません。モデルの重みとエンジン ファイルはブラウザにキャッシュされるため、2 回目からはページがより速く起動します。
不快になるところ。 Chrome または Edge が必要です。WebCodecs はどこでも入手できるわけではありません。プロセッサ上の長いビデオは高速とはみなされません。1 分のソース素材に数分かかる場合があります。そして、性能の悪いラップトップでは 4K を実行しない方が良いです。720p から始めて、結果を見て、解像度を上げてください。
人格形成: 結果を台無しにする 2 つの間違い
同じビデオの 2 番目のテクニックは、キャラクターの正しい成長です。顔と服装を分けて映した一枚の写真です。世代の中で顔が浮くか、そのまま残るかは組み方次第です。
1 つ目の間違い: 顔と服が異なるスケールで描画されています。モデルはこれが一人の人間であることを理解せず、自分でプロポーションを完成させ始めます。エラー 2: スキャンはさまざまな人々の断片から組み立てられており、出力は平均化されたエイリアンの顔になり、フィルターが再び機能します。
作業オプションは、1 回のスキャン、1 人、両方の部分に同じ光と角度です。
認識可能な人物に関するエラーが発生して生成が依然として失敗する場合
深度マップが適切に配置され、スキャンが正しく組み立てられていることが起こりますが、Seedance は依然として拒否します。これは、問題が写真の 1 つにあり、それを見つける必要があることを意味します。
方法は簡単、消去法です。参照を 1 つずつ削除して、最初からやり直します。世代が過ぎるとすぐに、最後に削除された写真が原因になります。次に、それを再構築するか、深度マップに置き換えます。
長い間?はい。ただし、推測する必要はありません。3 回か 4 回実行すれば、正確な理由がわかります。
そして、同じビデオの 2 番目のテクニックです。通常のグリッドが有罪の写真に適用されます - 顔の上に均等な正方形が適用されます。フィルターは顔全体を表示しなくなりますが、生成のために特徴は読み取り可能なままです。グリッドは任意のエディターに配置するか、ニューラル ネットワークに「この写真に正方形のグリッドを配置する」ように要求するだけです。
任意のムービーからカメラの動きを転送
顔を交換しなくても同じテクニックが機能します。フィルムからフレームを取り出し、そこから深度マップを作成し、それをプロンプトとともにモデルに渡します。そうすれば、同じカメラの動き、同じアプローチ、同じターン、同じリズムでシーンが得られます。
「映画的な」乗り物が必要な場合、このようにして予告編、パロディ、コマーシャルが撮影されますが、クレーンを持ったカメラマンを雇う予算はありません。
次は何ですか
順序は次のとおりです。最初に深度マップ - ブラウザで無料ファイルをダウンロードしたり、トークンを消去したりする必要はありません。それから世代自体 - 当社ウェブサイトのSeedance 2.5、キャラクターの育成と参考もあります。
初めてうまくいかない場合は、3 ~ 5 秒の短いクリップから始めてください。カメラの動きと顔の動作の両方が表示され、必要な時間とトークンが大幅に短縮されます。