Siapa yang berbicara kapan gratis: pemisahan suara dan subtitle
Rekaman apa pun yang memiliki lebih dari satu suara akan menimbulkan pertanyaan yang sama: "siapa yang mengatakan itu?". Siapa yang Berbicara Kapan (gratis) menjawabnya langsung di browser Anda: alat ini menemukan awal dan akhir baris, mengurutkannya berdasarkan speaker — "Speaker 1", "Speaker 2" dan seterusnya, hingga empat orang — dan, jika Anda mau, menambahkan teks juga. File tidak pernah diunggah, tidak ada token yang dikenakan biaya dan tidak diperlukan akun.
Cara kerja pemisahan speaker
Tugas ini disebut diarisasi: model mendengarkan keseluruhan aliran dan menjawab dua pertanyaan secara terpisah — siapa yang berbicara, dan pada menit berapa. Suara dibandingkan berdasarkan timbre, sehingga baris-baris dari orang yang sama muncul di satu trek bahkan ketika orang-orang saling berbicara. Apa yang Anda dapatkan kembali adalah garis waktu: setiap baris adalah baris ucapan dengan stempel waktunya sendiri dan label pembicara.
Semuanya dihitung di perangkat Anda. Model diunduh ke browser Anda satu kali dan kemudian bekerja secara offline; pada kartu grafis melalui WebGPU analisis berjalan jauh lebih cepat, dan jika browser tidak menyerah, analisis akan kembali ke prosesor melalui WASM — benar, tetapi lambat. Periksa catatan memori sebelum perekaman yang panjang: model menginginkan sekitar satu gigabyte agar dapat berjalan dengan nyaman.
Menganalisis file langkah demi langkah
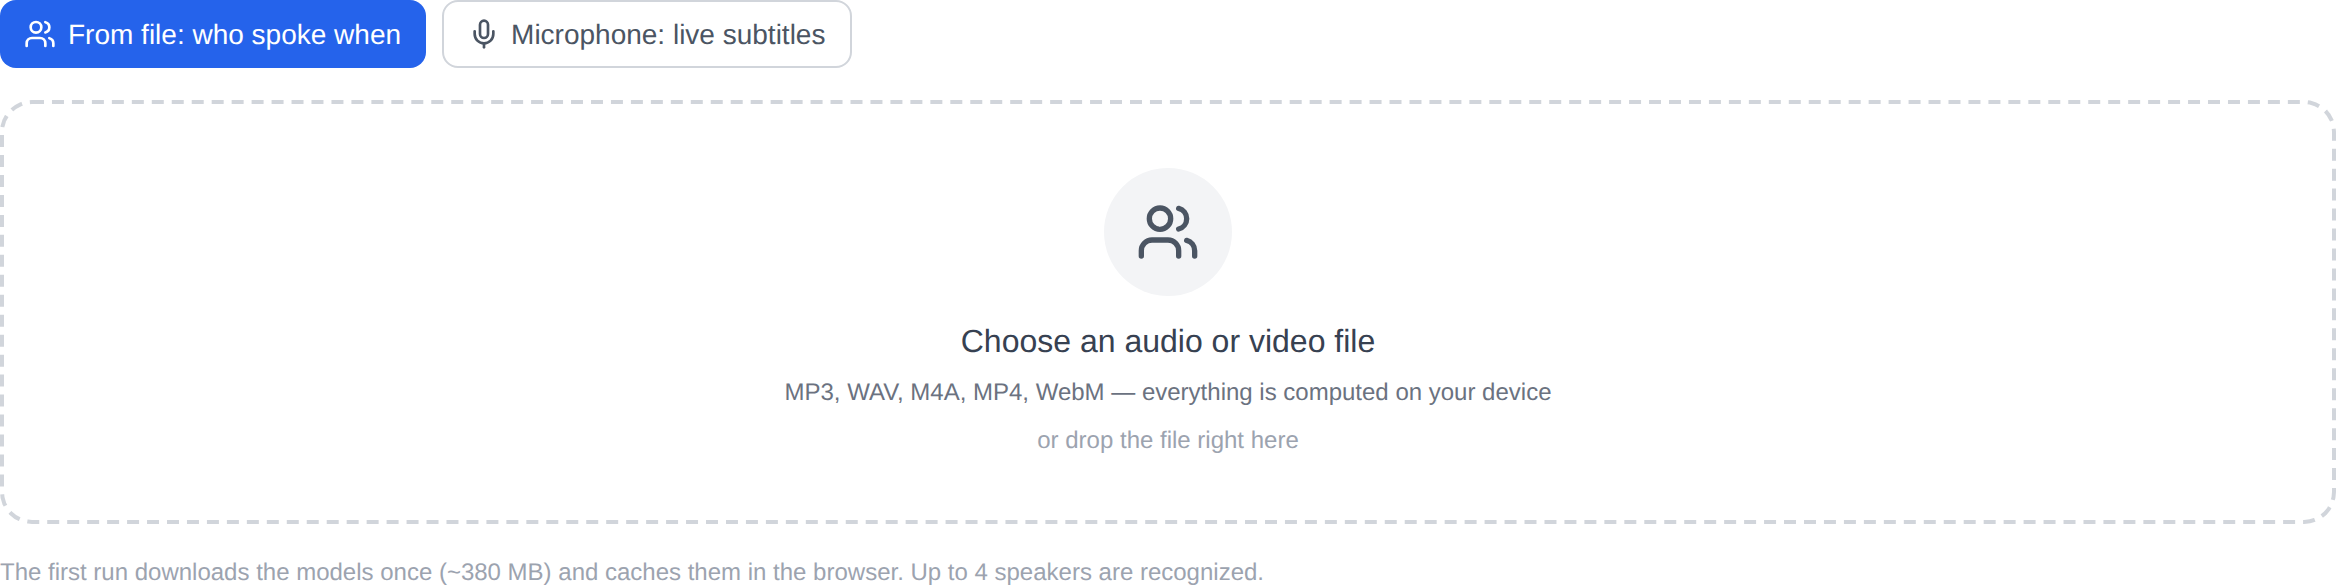
- Buka alat dan, pada tab file, pilih rekaman: MP3, WAV, M4A, MP4, WebM dan file media lainnya diterima.
- Kotak centang "Juga transkripsikan ucapannya" menampilkan model teks: kata-kata diletakkan di jalur pembicara dan dirangkai menjadi dialog yang dapat dibaca. Jika dimatikan, alat ini hanya membagi rekaman berdasarkan suara, yang lebih cepat.
- Proses pertama akan mengunduh model (sekitar 380 MB) dan menyimpannya dalam cache; analisis selanjutnya segera dimulai.
- Tunggu timeline dan dialognya, lalu salin hasilnya atau ekspor sebagai TXT, SRT, VTT atau JSON. Dalam subtitle SRT dan VTT setiap baris membawa nama pembicaranya, sehingga file dihubungkan langsung ke editor video.
Subtitle langsung dari mikrofon
Tab kedua tidak memerlukan file: aktifkan mikrofon Anda dan frasa mulai muncul di layar saat Anda berbicara. Frasa yang sudah selesai dipindahkan ke dalam daftar dengan stempel waktu sementara frasa berikutnya diketik sendiri di bawahnya. Suara tidak direkam dan tidak dikirim ke server — subtitle hanya ada di halaman Anda, dan Anda dapat memeriksanya kapan saja dengan tab jaringan di alat pengembang Anda. Ini cocok untuk panggilan telepon, rapat, dan kuliah di mana Anda memerlukan transkripnya saat percakapan masih berlangsung, bukan setelahnya.
Batasan yang jujur
Ini adalah alat pemisah speaker, bukan transcriber universal. Model pengenalan ucapan dilatih terutama dalam bahasa Inggris: model ini akan mentranskripsikan percakapan dalam bahasa lain, tetapi dengan lebih banyak kesalahan dibandingkan bahasa Inggris. Hingga empat speaker dipisahkan dengan andal; rekaman dari ruangan yang bising dengan interupsi akan lebih buruk daripada wawancara yang tenang. Transkrip dengan nama pembicara bukanlah transkripsi profesional, jadi bacalah sebelum menyebarkannya.
Batasan lainnya adalah perangkat keras: perangkat yang lemah mungkin tidak memiliki cukup memori untuk modelnya, dan analisis khusus prosesor memerlukan waktu cukup lama. Sebagai imbalannya, harga tidak ditetapkan: tanpa antrian, tanpa biaya, tanpa unggahan.
Cocok untuk siapa
Seorang jurnalis dapat melihat struktur wawancara dan mengeluarkan kutipan dalam hitungan menit. Seorang penyelenggara rapat bisa mendapatkan catatan "siapa mengatakan apa" tanpa perlu membaca rekamannya. Editor video dapat memasukkan subtitle dengan nama pembicara ke dalam proyek melalui SRT atau VTT. Seorang siswa dapat membagi ceramah menjadi beberapa baris dan pokok pembicaraan.
Jika Anda memerlukan teks tanpa pemisahan pembicara dan dalam banyak bahasa, pengenalan suara (gratis) berjalan berdampingan. Bagian lainnya berada di Audio halaman, dan alat lokal gratis dikumpulkan di bawah Alat Lainnya. Mulailah dengan rekaman singkat berdurasi lima menit: rekaman pertama yang dijalankan dengan pengunduhan model sudah cukup untuk mendengarkan bagaimana rekaman Anda bertahan dalam analisis.