Siapa bicara kapan gratis: pisah suara dan subtitle
Setelah rapat, wawancara, atau ceramah, Anda akan mendapatkan rekaman di mana beberapa orang berbicara, dan transkrip biasa tidak dapat memberi tahu Anda siapa mengatakan apa. Siapa yang berbicara kapan adalah alat browser gratis: alat ini membagi rekaman menjadi beberapa speaker (hingga empat), secara opsional mengubah ucapan menjadi dialog yang diberi stempel waktu, dan tab kedua menjalankan teks langsung langsung dari mikrofon Anda. File tidak pernah diunggah, tidak ada token yang dibelanjakan, dan tidak diperlukan akun.
Bagaimana cara kerjanya
Pemisahan speaker didukung oleh model NVIDIA Sortformer: model ini menemukan hingga empat speaker dan memaparkan jangka waktu masing-masing speaker terdengar. Jika Anda membiarkan kotak “Juga transkripsikan ucapan” dicentang, kata-kata akan dilampirkan ke speaker — Anda akan mendapatkan transkrip dialog berlabel “Speaker 1”, “Speaker 2” dan seterusnya, yang dapat Anda salin atau unduh sebagai TXT, SRT, VTT atau JSON. Lencana di sebelah garis waktu menunjukkan jumlah speaker yang ditemukan model.
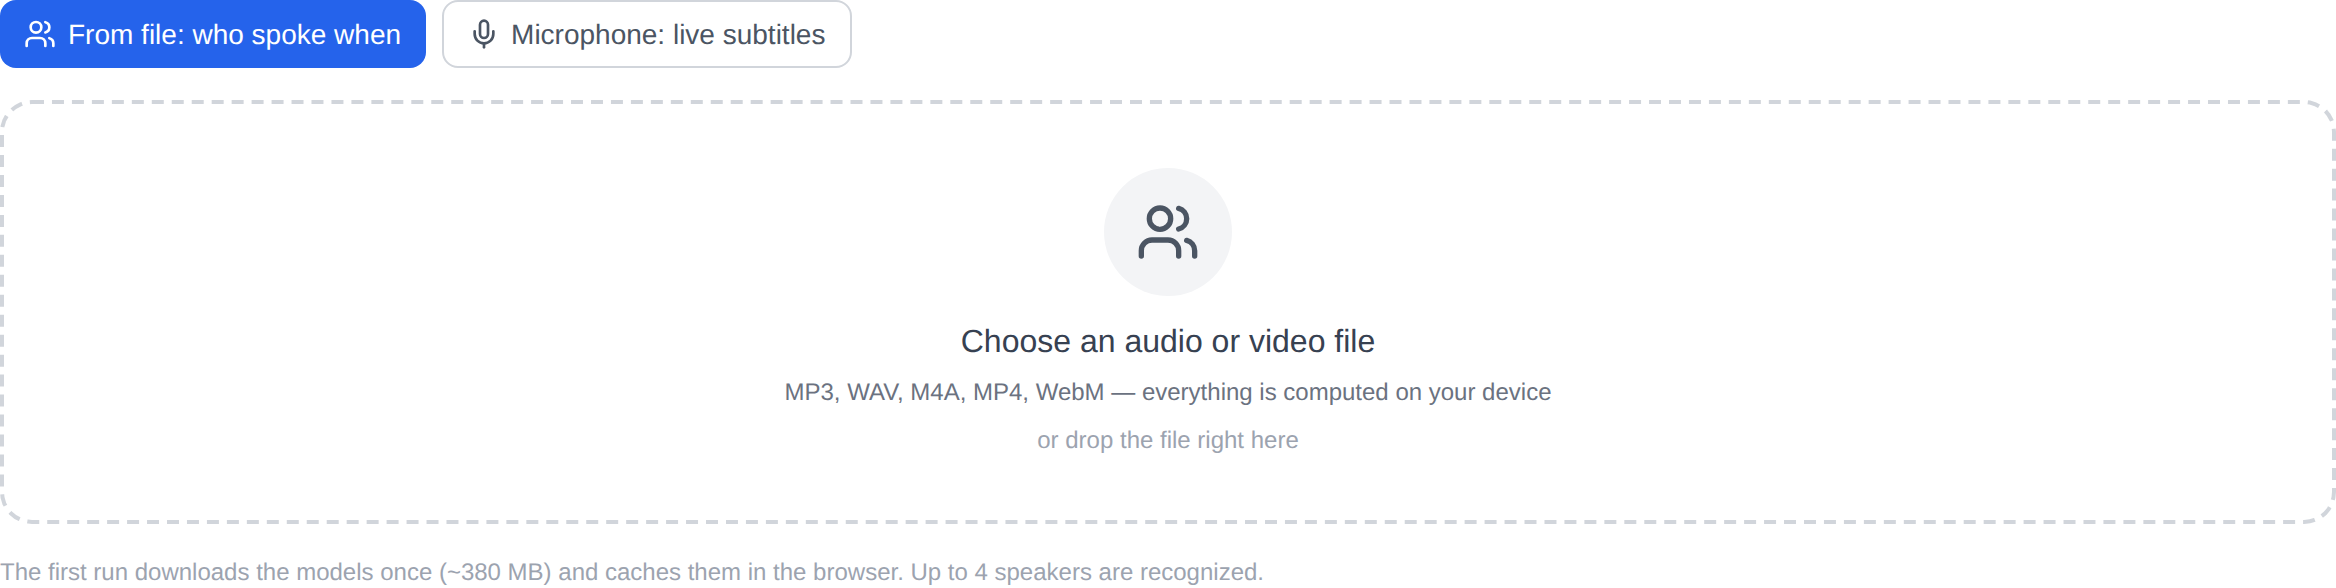
Proses pertama akan mengunduh bobot model ke perangkat Anda — totalnya sekitar 380 MB. Setelah itu mereka tetap disimpan dalam cache di browser Anda dan kemudian dijalankan tanpa memerlukan jaringan. Dengan kartu grafis (WebGPU) analisisnya cepat; tanpanya mesin akan kembali ke prosesor (WASM) — terasa lebih lambat, namun hasilnya sama, dan alat akan memberi tahu Anda saat hal itu terjadi. Audio dilipat menjadi 16 kHz mono di dalam browser; tidak ada yang perlu direkam di mana pun.
Menandai rekaman Anda sendiri
- Buka alat dan pilih file audio atau video: MP3, WAV, M4A, MP4 dan WebM diterima, dan Anda dapat meletakkan file ke bingkai.
- Pilih kotak “Juga transkripsikan pidatonya”: dicentang, ini memberi Anda dialog yang diberi stempel waktu; tidak dicentang, hanya timeline “siapa dan kapan berbicara”.
- Tekan tombol mulai. Saat pertama kali dijalankan, tunggu hingga model diunduh — bilah kemajuan akan terus mengabari Anda.
- Hasilnya adalah timeline plus dialog. Salin teks dengan tombol atau unduh dalam format yang Anda perlukan.
Teks langsung dari mikrofon
Tab kedua mengambil suara langsung dari mikrofon dan memberi judul frasa demi frasa saat Anda berbicara: frasa saat ini tampak besar, frasa yang sudah selesai tetap ada dalam daftar di bawah. Cocok untuk rapat, ceramah, atau panggilan video, ketika teks diperlukan saat ini, bukan setelah memproses file. Akses mikrofon diminta dengan menekan tombol; tidak ada yang ditulis ke file dan tidak ada yang keluar dari browser.
Apa yang perlu diketahui sebelumnya
Alat ini masih muda dan eksperimental: kualitas pemisahan bergantung pada rekaman. Percakapan mikrofon yang bersih terpecah dengan percaya diri, sedangkan rekaman yang berisik dan bergema dengan interupsi terus-menerus dapat membingungkannya. Pekerjaan wicara juga memerlukan memori — rencanakan ruang kepala sekitar 1 GB. Pada jalur prosesor (WASM) perekaman yang panjang memerlukan waktu yang jauh lebih lama dibandingkan pada kartu grafis. Model tidak mempelajari nama: label “Speaker 1” dan “Speaker 2” dimaksudkan untuk diganti namanya setelah diekspor, agar sesuai dengan menit Anda.
Siapa yang membutuhkannya
Seorang jurnalis dapat dengan cepat menemukan di mana suara baru memasuki sebuah wawancara. Seorang mahasiswa dapat meletakkan rekaman perkuliahan baris demi baris: di mana profesor berbicara dan di mana audiens bertanya. Editor podcast dapat menemukan bagian dari sesi panjang di mana setiap orang berbicara satu sama lain dan menghentikannya. Sekretaris rapat dapat membuat draf notulensi dengan kode waktu tanpa mengirimkan rekamannya ke mana pun.
Ketika Anda membutuhkan sesuatu yang lain
Jika yang Anda inginkan adalah teks biasa dan bukan pengelompokan berdasarkan suara, buka audio dan video → teks. Alat-alat lain dari bagian ini tersedia di Audio halaman, dan lebih banyak alat lokal gratis ada di bawah Alat lainnya. Analisis dilakukan oleh perpustakaan FluidAudio terbuka (lisensi MIT): kode dan model ada di browser Anda, tanpa jalan memutar ke server lain.