आवाज अभिनय Gemini TTS: 30 आवाजें और सभी सेटिंग्स
अनुभाग में "ऑडियो" एक नया टूल सामने आया है - संवादों का स्वर अभिनय Gemini TTS. यह तैयार स्क्रिप्ट को ध्वनि में बदल देता है: आप वक्ता, उनकी आवाज और चरित्र को निर्दिष्ट करते हैं, और सेवा एक-एक करके पंक्तियों को आवाज देती है और समाप्त MP3 लौटाती है।
यह कैसा यंत्र है
यह एक पाठ को एक स्वर में पढ़ना नहीं है, बल्कि पूरा पढ़ना है बहु वक्ता संवाद. प्रत्येक पात्र की अपनी आवाज़, उच्चारण, प्रस्तुति शैली और गति होती है - और पंक्तियाँ वैसी ही लगती हैं जैसी उनका इरादा था: प्रस्तुतकर्ताओं के बीच बातचीत, एक नाटक, एक साक्षात्कार, वीडियो के लिए पात्रों की पंक्तियाँ।
दो मॉडल उपलब्ध:
- Gemini 3.8 Flash TTS - अभिव्यंजक आवाज अभिनय: समृद्ध भावनाएं, अधिक प्राकृतिक लय, प्रस्तुति पर बेहतर नियंत्रण। पॉडकास्ट, ऑडियोबुक, वॉयस-ओवर के लिए उपयुक्त।
- Gemini 3.8 Flash-Lite TTS - वही यांत्रिकी सस्ती और तेज़ हैं: बड़ी मात्रा में, ड्राफ्ट और पाठ को ज़ोर से पढ़ने के लिए।
कौन सी सेटिंग्स उपलब्ध हैं?
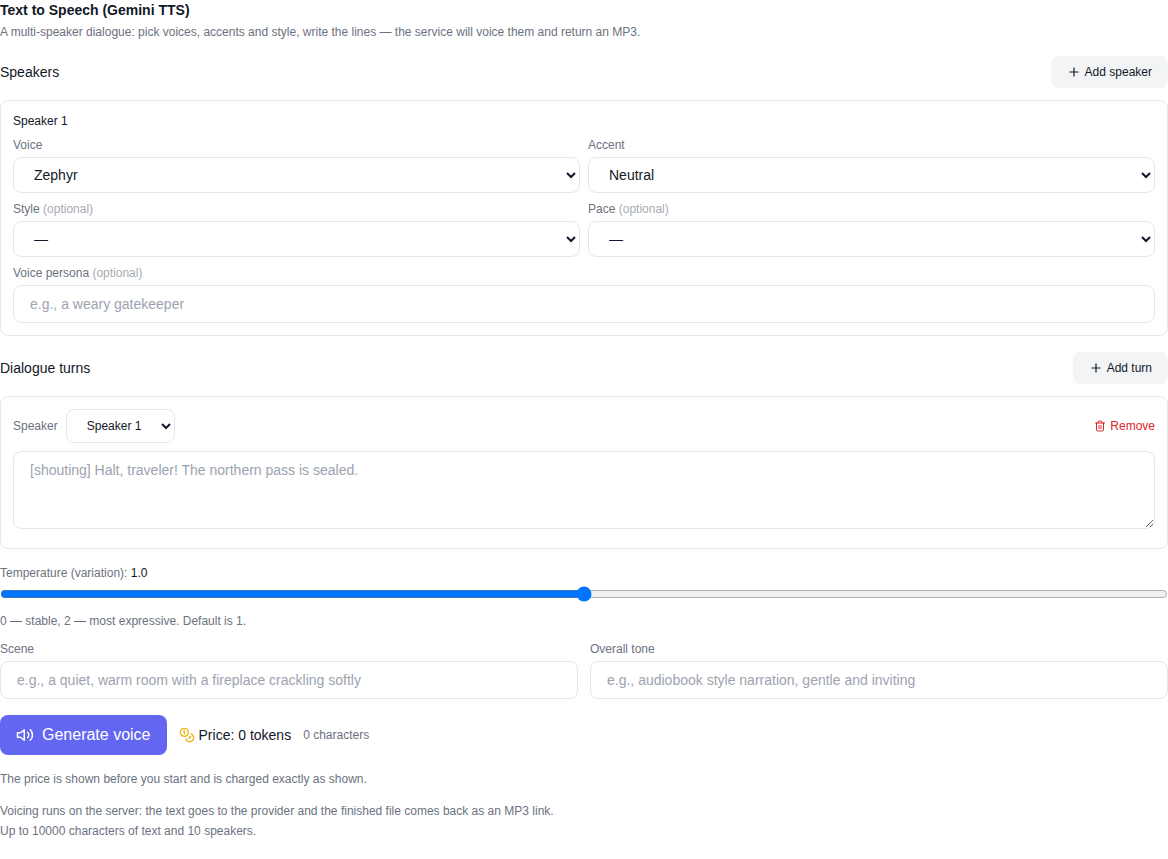
इंटरफ़ेस ध्वनि अभिनय मॉडल द्वारा प्रदान किए गए सभी पैरामीटर प्रदर्शित करता है:
- वक्ता। एक से अनेक वर्ण तक; प्रत्येक का अपना हस्ताक्षर "Speaker 1", "Speaker 2" इत्यादि होता है, जिसके द्वारा प्रतिकृतियां आवाज से जुड़ी होती हैं।
- 30 वोट - नरम कथा से लेकर ऊर्जावान और "समाचार" तक।
- 8 उच्चारण - तटस्थ, अमेरिकी (सामान्य, "घाटी", दक्षिणी), ब्रिटिश (RP और ब्रिक्सटन), ट्रान्साटलांटिक, ऑस्ट्रेलियाई।
- 6 परोसने की शैलियाँ - आवाज़ में मुस्कुराहट, एक उद्घोषक, फुसफुसाहट, सहानुभूति, प्रोमो और एक "शुष्क" सम स्वर।
- 4 भाषण दरें - प्राकृतिक, पैटर्न, चिकनी "बहाव" और झटकेदार।
- स्वर वर्ण - मुफ़्त विवरण, जैसे "गर्म कहानीकार" या "कठोर द्वारपाल।"
- तापमान - 0 से 2 तक: निचला - अधिक स्थिर और पूर्वानुमानित, उच्चतर - जीवंत और अधिक विविध।
- दृश्य और सामान्य स्वर - सेटिंग का विवरण ("धधकती हुई चिमनी के साथ एक शांत कमरा") और वर्णन की शैली ("एक ऑडियोबुक, नरम और आकर्षक")।
- प्रतिकृतियां — संवाद की प्रत्येक पंक्ति 10,000 वर्णों तक; प्रतिकृतियों का क्रम सुरक्षित रखा गया है।
संवाद को आवाज़ कैसे दें: चरण दर चरण
- खुला "ऑडियो" अनुभाग और एक मॉडल चुनें Gemini 3.8 Flash TTS या Flash-LiteTTS - वे मॉडलों की सूची में सबसे नीचे हैं।
- वक्ता जोड़ें और प्रत्येक व्यक्ति की आवाज़, उच्चारण, शैली और गति को अनुकूलित करें।
- संवाद की पंक्तियाँ लिखें और प्रत्येक के लिए वक्ता की पहचान करें।
- यदि वांछित हो, तो दृश्य विवरण, समग्र स्वर और तापमान भरें।
- कीमत पर नज़र डालें - यह लॉन्च से पहले दिखाई देती है और जैसे ही आप टेक्स्ट दर्ज करते हैं, इसकी पुनर्गणना की जाती है।
- "वॉयस" पर क्लिक करें और तैयार होने पर, परिणाम सुनें और MP3 डाउनलोड करें।
इसकी कीमत कितनी होती है
मूल्य की गणना पाठ की वास्तविक मात्रा के आधार पर की जाती है: प्रतिकृतियां जितनी लंबी होंगी, लागत उतनी ही अधिक होगी, और यह लॉन्च से पहले दिखाई देती है - पीढ़ी के बाद कोई आश्चर्य नहीं होता है। भुगतान अन्य भुगतान पीढ़ियों की तरह, साइट टोकन का उपयोग करके किया जाता है; असफल होने पर, टोकन स्वचालित रूप से वापस कर दिए जाते हैं। मूल्य मार्गदर्शिका को सीधे इस रूप में देखा जा सकता है: जब आप स्क्रिप्ट टाइप कर रहे होते हैं तो राशि अपडेट हो जाती है।
अक्सर पूछे जाने वाले प्रश्नों
क्या मैं दो या दो से अधिक पात्रों के बीच संवाद को आवाज़ दे सकता हूँ? हाँ, प्रत्येक वक्ता की अपनी आवाज़ और सेटिंग्स होती हैं, पंक्तियाँ बारी-बारी से बदलती रहती हैं।
परिणाम किस प्रारूप में है? MP3 - आप इसे पेज पर सुन सकते हैं और एक बटन से डाउनलोड कर सकते हैं।
मॉडल कौन सी भाषाएं बोलती है? मॉडल बहुभाषी है: यह रूसी और अंग्रेजी सहित दर्जनों भाषाओं में पाठों को आवाज देता है।
क्या चुनें: फ़्लैश या Flash-Lite? अभिव्यंजक परियोजनाओं के लिए - फ्लैश, बड़ी मात्रा और ड्राफ्ट के लिए - Flash-Lite: यांत्रिकी समान हैं, लेकिन सस्ती और तेज़ हैं।
क्या मुझे प्रयास करने के लिए भुगतान करना होगा? राइट-ऑफ़ तब होता है जब ध्वनि अभिनय शुरू होता है, और यदि कोई त्रुटि होती है, तो टोकन स्वचालित रूप से वापस आ जाते हैं।