Gemini 4 Argon – déjà sur le site
Un nouveau modèle est apparu dans les réseaux de neurones NeuralSpace - Gemini 4 Argon de Google. Il est déjà disponible dans chat, section "Code" et public API. Page modèle séparée - /chat/gemini-4-argon.
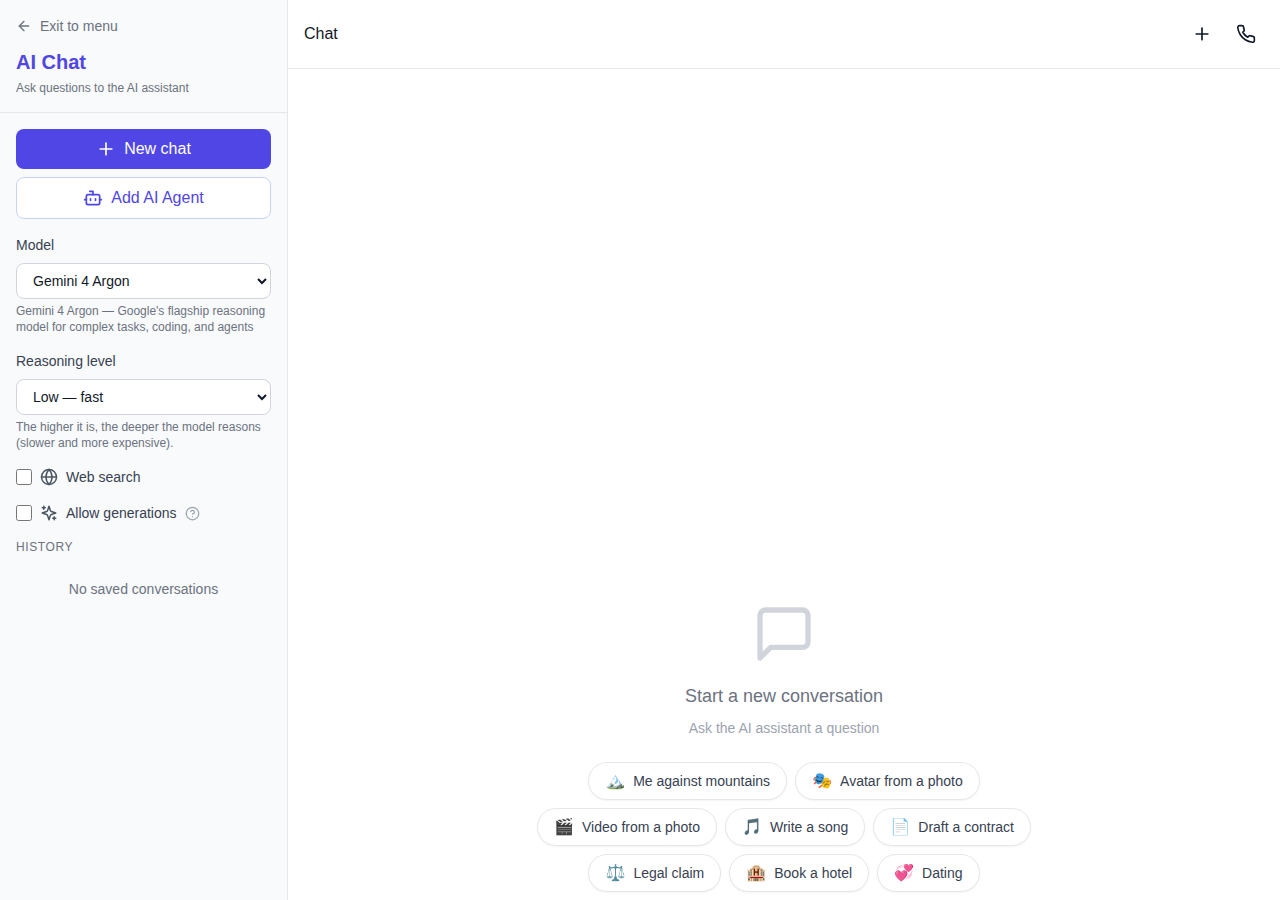
Que peut Gemini 4 Argon
- Contexte de 1 million de jetons. Vous pouvez télécharger un document volumineux ou mener une très longue correspondance - le modèle garde le fil de la conversation du début à la fin.
- Ne comprend pas seulement le texte. Dans une demande, vous pouvez afficher une image, joindre un fichier, un fichier audio ou vidéo - le modèle analysera le contenu et répondra en fonction de celui-ci.
- Réfléchit avant de répondre. Problèmes complexes - mathématiques, logique, plans en plusieurs étapes - le modèle résout avec le raisonnement, et non avec la première réponse qui se présente.
- Outils et recherche sur le Web. Comme les modèles de chat voisins : vous pouvez demander au modèle de trouver des informations pertinentes sur Internet.
- Codage. Analyse le code existant, planifie les modifications et les exécute étape par étape, en expliquant les résultats.
Prix
Le coût est calculé en fonction des jetons réellement utilisés et est amorti après la réponse - le seuil de solde minimum est visible avant l'envoi, comme pour les autres modèles de la rubrique. Les prix actuels sont sur la page API.
Comment essayer
- Ouvrir chat et sélectionnez dans la liste des modèles Gemini 4 Argon — une page de modèle distincte est disponible sur /chat/gemini-4-argon.
- Posez une question comme d'habitude : le modèle répond avec un flux et prend en charge la recherche sur le Web.
- Pour les projets, ouvrez la section "Code" — là, le modèle fonctionne comme un agent : il crée un projet, écrit et édite des fichiers et effectue de longues itérations.
Que sait-on du modèle : nombres Google et tests indépendants
La principale source de chiffres est la publication officielle carte modèle Gemini 4 Argon de Google DeepMind. Il s'agit des propres mesures du fabricant : DeepSWE v1.1 - 77,9 % (codage d'agent), AutomationBench - 51,3 % (tâches commerciales de bout en bout), CWE-bench v1 - 68 % (fermeture autonome des vulnérabilités), LVBench - 91,7 % (compréhension de vidéos longues), Vals Index - 68,9 %. La fenêtre d'entrée et de sortie conjointe est de 1 million de jetons et la limite garantie pour une réponse est de 64 000 (selon le catalogue OpenRouter) ; la mise en cache des requêtes est 95 % moins chère ; prix de départ - 2 $ par million de jetons d'entrée et 10 $ par million de jetons de sortie, après la période d'introduction - 4 $/20 $.
Il existe également des mesures indépendantes. Laboratoire d'essais Vals AI a présenté le modèle sur son propre stand et a confirmé son leadership : première place sur 48 modèles en Vals Index (68,9% ± 0,97) et première place sur 78 en Finance Agent v2. Le prix du test est également indicatif : une exécution coûte environ 15,68 $ et dure environ 46 minutes – le modèle est lourd, mais efficace. Revoir the-decoder.com plus sobre : selon l'auteur, Argon réduit l'écart avec OpenAI et Anthropic et bat ses concurrents dans certains benchmarks, mais ne prend pas une avance nette - Anthropic, selon son évaluation, est toujours en avance. En même temps, pour un produit phare, le modèle est bon marché, surtout au prix de lancement.
En résumé : les numéros sur la carte Google sont la déclaration du fabricant ; Jusqu'à présent, des tests indépendants les confirment pour Vals Index et Finance Agent ; pour les autres benchmarks, il n'y a pas encore d'exécutions tierces. Une analyse détaillée de l’annonce se trouve dans notre article séparé. "Gemini 4 Argon : ce qui est connu". Sur notre site, nous indiquons uniquement ce qui fonctionne réellement : le chat, le « Code », API, la recherche sur le Web et les outils.
Quand choisir Argon
Argon est un modèle pour les tâches volumineuses : documents et correspondances longs, analyse de fichiers et de médias, mathématiques complexes et scripts d'agent en plusieurs étapes. Pour des réponses rapides au quotidien dans le chat, il existe des modèles légers - par exemple Claude Haiku 5.5, et pour une profondeur de raisonnement maximale - les plus anciens Claude Sonnet 5.5 et Claude Opus 5.5.