Actuación de voz Gemini TTS: 30 voces y todas las configuraciones
en la sección "Audio" ha aparecido una nueva herramienta - actuación de voz de diálogos Gemini TTS. Convierte el guión terminado en sonido: usted especifica los hablantes, sus voces y carácter, y el servicio expresa las líneas una por una y devuelve el MP3 terminado.
¿Qué tipo de instrumento es este?
Esto no es leer un texto con una sola voz, sino un texto completo. diálogo de varios oradores. Cada personaje tiene su propia voz, acento, estilo de presentación y tempo, y las líneas suenan como fueron concebidas: una conversación entre los presentadores, una parodia, una entrevista, líneas de los personajes del video.
Dos modelos disponibles:
- Gemini 3.8 Flash TTS — actuación de voz expresiva: emociones más ricas, ritmo más natural, mejor control de la expresión. Adecuado para podcasts, audiolibros y locuciones.
- Gemini 3.8 Flash-Lite TTS — la misma mecánica es más barata y rápida: para grandes volúmenes, borradores y lectura de textos en voz alta.
¿Qué configuraciones están disponibles?
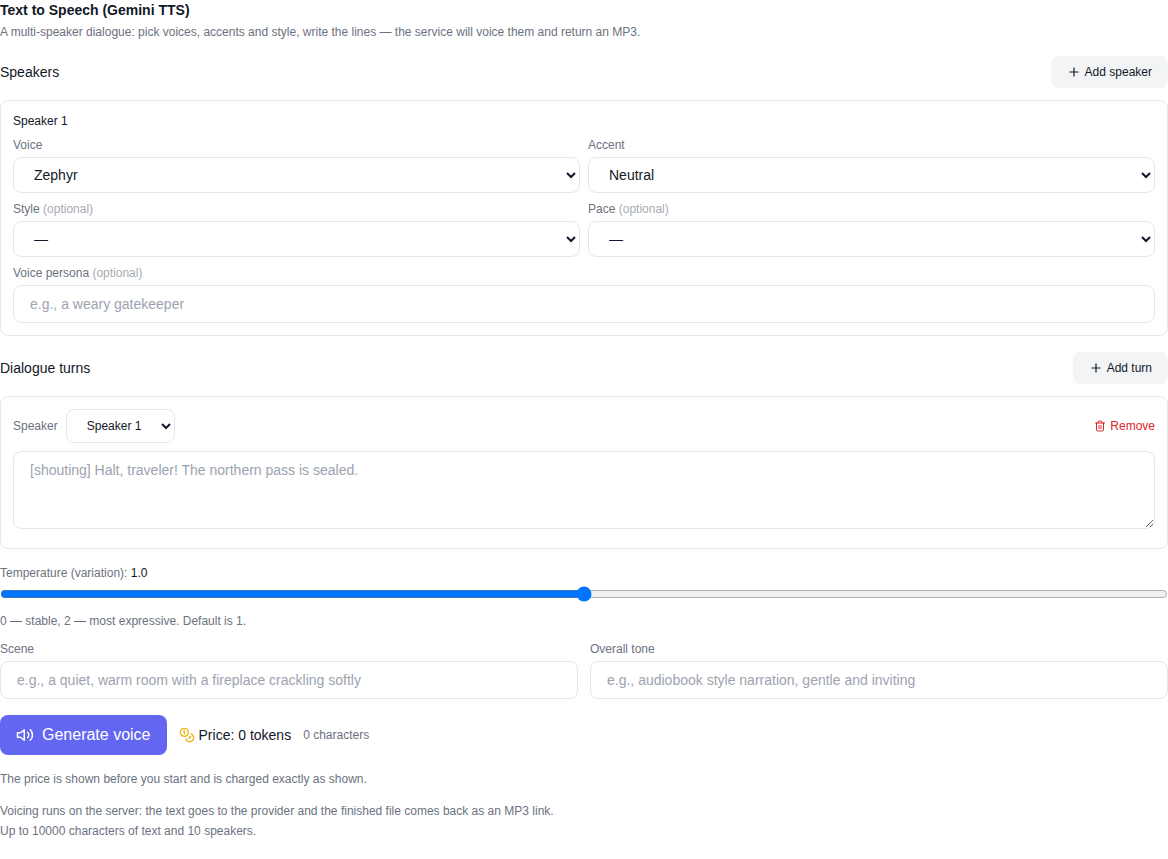
La interfaz muestra todos los parámetros proporcionados por el modelo de actuación de voz:
- Altavoces. De uno a varios personajes; cada uno tiene su propia firma “Speaker 1”, “Speaker 2”, etc., mediante la cual las réplicas se asocian con la voz.
- 30 votos - de una narrativa suave a una enérgica y “noticia”.
- 8 acentos - neutral, estadounidense (general, "valle", sur), británico (RP y Brixton), transatlántico, australiano.
- 6 estilos de porción — una sonrisa en la voz, un locutor, un susurro, empatía, promoción y un tono uniforme “seco”.
- 4 velocidades de habla - natural, con golpeteo, suave “deriva” y entrecortado.
- personaje de voz - descripción libre, como “narrador cálido” o “guardián severo”.
- Temperatura - de 0 a 2: inferior - más estable y predecible, superior - más animado y variado.
- Escena y tono general. - una descripción del entorno (“una habitación tranquila con una chimenea crepitante”) y el estilo de narración (“un audiolibro, suave y acogedor”).
- Réplicas — cada línea de diálogo hasta 10.000 caracteres; Se conserva el orden de las réplicas.
Cómo expresar el diálogo: paso a paso
- Abierto sección "Audio" y selecciona un modelo Gemini 3.8 Flash TTS o Flash-LiteTTS - están al final de la lista de modelos.
- Agregue oradores y personalice la voz, el acento, el estilo y el tempo de cada persona.
- Escribe las líneas de diálogo e identifica al hablante de cada una.
- Si lo desea, complete la descripción de la escena, el tono general y la temperatura.
- Mire el precio: es visible ANTES del lanzamiento y se recalcula a medida que ingresa texto.
- Haga clic en "Voz" y cuando esté listo, escuche el resultado y descargue MP3.
Cuánto cuesta
El precio se calcula en función del volumen real de texto: cuanto más largas sean las réplicas, mayor será el coste y es visible antes del lanzamiento; no hay sorpresas después de la generación. El pago se realiza mediante tokens del sitio, como ocurre con otras generaciones pagas; si no tiene éxito, los tokens se devuelven automáticamente. La guía de precios se puede ver directamente en el formulario: el importe se actualiza mientras escribes el script.
Preguntas frecuentes
¿Puedo poner voz en off a un diálogo entre dos o más personajes? Sí, cada orador tiene su propia voz y configuración, las líneas se turnan.
¿En qué formato está el resultado? MP3 - puedes escucharlo en la página y descargarlo con un botón.
¿Qué idiomas habla la modelo? El modelo es multilingüe: expresa textos en decenas de idiomas, incluidos ruso e inglés.
¿Qué elegir: Flash o Flash-Lite? Para proyectos expresivos - Flash, para grandes volúmenes y borradores - Flash-Lite: la mecánica es la misma, pero más barata y rápida.
¿Tengo que pagar para intentarlo? La cancelación se produce cuando comienza la actuación de voz y, si hay un error, los tokens se devuelven automáticamente.