Kling O1 Image-to-Video: Standfoto in bewegte Aufnahmen verwandeln
Bottom Line Up Front (BLUF): Kling O1 Image-to-Video ist ein KI-Videogenerator, der ein einzelnes Foto animiert. Laden Sie ein Bild hoch, geben Sie optional ein, was im Rahmen passieren soll, und das Model produziert einen kurzen Clip, in dem das Standbild zum Leben erweckt wird: Eine Person blinzelt und lächelt, Wasser kräuselt sich, die Kamera driftet näher. Keine Bearbeitungssoftware, keine Keyframes – nur ein Foto und ein Satz.
Hier erfahren Sie, wie die Foto-zu-Video-Generierung funktioniert
Beginnen Sie mit einem Bild. Fügen Sie es in das Generierungsformular ein, fügen Sie eine kurze Bewegungsaufforderung hinzu, z. B. „Der Mann dreht sich zur Kamera und lacht“ oder „Schnee fällt sanft über die Straße“ und führen Sie den Job aus. Die KI erfindet die Zwischenbilder und hält dabei Gesicht, Kleidung und Hintergrund treu zu Ihrer ursprünglichen Aufnahme. Je klarer Ihre Beschreibung der Aktion ausfällt, desto näher kommt das Ergebnis dem, was Sie sich vorgestellt haben.
Sie können auch die Eingabeaufforderung ganz weglassen und das Modell entscheiden lassen, wie sich die Szene bewegen soll — ein guter Weg, um herauszufinden, was in einem Bild steckt. Jeder fertige Clip landet in Ihrem Generierungsverlauf, wo Sie ihn herunterladen, erweitern, das letzte Bild aufnehmen oder dasselbe Foto mit einer schärferen Eingabeaufforderung erneut ausführen können.
Ein oder zwei Fotos: Den richtigen Modus auswählen
Dieses Modell akzeptiert bis zu zwei Bilder. Mit einem einzelnen Foto wählen Sie zwischen 5-Sekunden- und 10-Sekunden-Clips, und die Bewegung entfaltet sich ausgehend von diesem Bild vorwärts. Wenn Sie ein zweites Bild hinzufügen, wird der Dauerbereich auf 3 bis 10 Sekunden erweitert, da die Generation nun zwischen zwei Ankerpunkten wandert, anstatt frei zu driften.
Der Zwei-Bilder-Modus glänzt, wenn das Ende wichtig ist. Zeigen Sie ein Produkt im ersten Bild verpackt und im zweiten vollständig zusammengebaut, und die KI erfindet eine sanfte Verwandlung zwischen beiden. Das gibt Ihnen weit mehr Kontrolle über den Abschluss als jede Textaufforderung — Sie reichen dem Modell buchstäblich sein Ziel.
Welche Bilder animieren am besten?
Sauber beleuchtete Aufnahmen mit einem klar erkennbaren Motiv funktionieren am besten: ein Porträt, ein Produkt vor schlichtem Hintergrund, eine Landschaft, ein Haustier. Lebendige Szenen mit Menschenmengen, winzigem Text oder komplexen Spiegelungen geben dem Netzwerk auf einmal zu viel zu verfolgen, und mit der Bewegung schleichen sich Fehler ein. Im Zweifelsfall vereinfachen Sie das Bild, bevor Sie es hochladen.
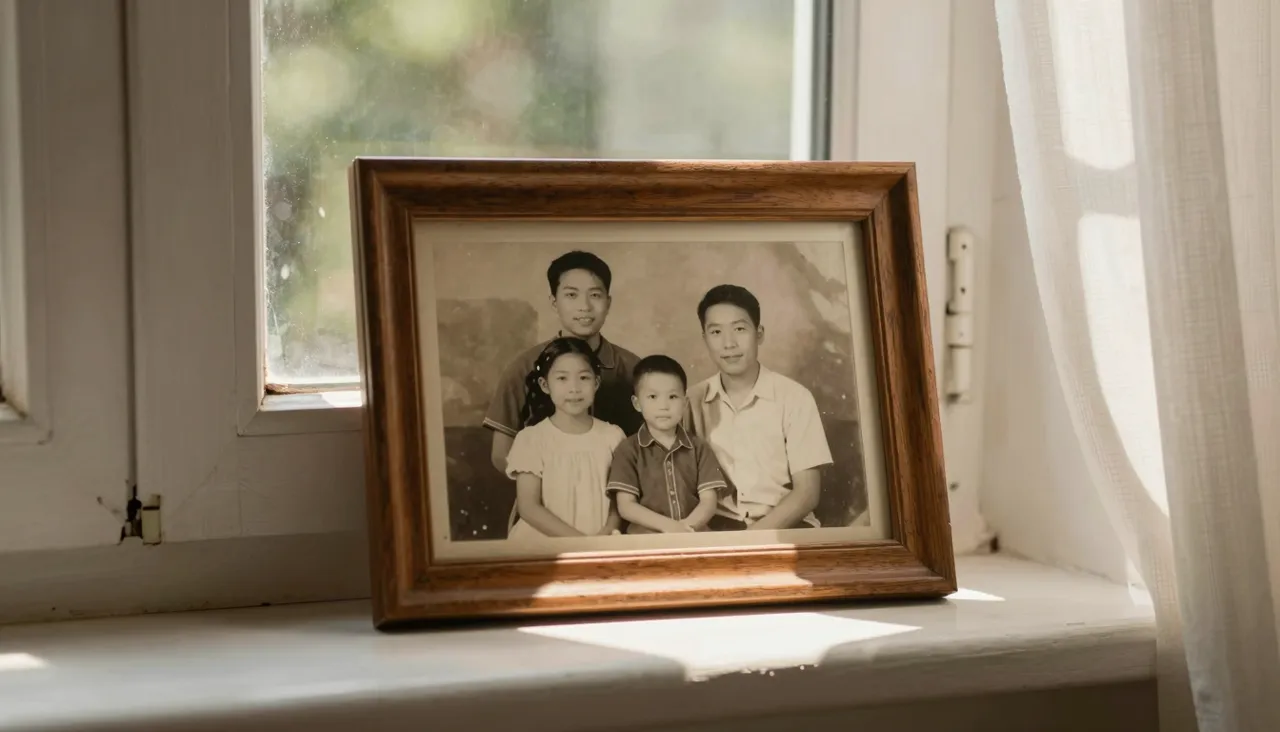
Vintage-Familienfotos sind ein wunderbarer Anwendungsfall. Scannen Sie einen alten Abzug, laden Sie ihn hoch und bitten Sie um eine subtile Bewegung — ein Blinzeln, ein sanftes Lächeln, Haar, das sich im Wind bewegt. Das Ergebnis wirkt weit persönlicher als jede Diashow und dauert nur wenige Minuten. Halten Sie die gewünschte Bewegung einfach sanft; Archivaufnahmen überstehen dramatische Aktionen selten mit Anmut.
Praktische Anwendungen für animierte Fotos
Zu den üblichen Aufgaben gehören Story-Cover, die aus einem gewöhnlichen Selfie erstellt werden, lebende Hintergründe für Präsentationen, animierte Veranstaltungsplakate und Produktlisten, die beim Vorbeiscrollen der Käufer ins Auge fallen. Überall dort, wo ein statisches Bild flach wirkt, zieht ein paar Sekunden Bewegung die Aufmerksamkeit auf sich — und genau diese Lücke füllt dieses Werkzeug.
Power-User betrachten jeden Clip als Baustein. Erstellen Sie eine Szene, ziehen Sie das letzte Bild heraus, fügen Sie dieses Bild mit einer neuen Eingabeaufforderung wieder ein und fahren Sie mit der Aktion fort. Aneinandergekettet wächst ein Foto zu einer längeren, zusammenhängenden Sequenz, in der jedes Segment genau dort anfängt, wo das vorherige aufgehört hat.
Häufige Fehler, die es zu vermeiden gilt
Das größte Problem besteht darin, einen kurzen Clip mit Handlung zu überladen: „Sie steht auf, geht durch den Raum, dreht sich um und winkt“ passt einfach nicht, also improvisiert die KI und das Ergebnis weicht vom Kurs ab. Fordern Sie ein oder zwei einfache Aktionen pro Generation an und erstellen Sie stattdessen längere Geschichten durch Verkettung.
Die andere Falle sind verschwommene oder dunkle Quellfotos. Das Modell animiert Ihr Bild; Es repariert es nicht, sodass eine verrauschte Eingabe zu einem verrauschten Video wird. Schreiben Sie abschließend Eingabeaufforderungen zur Bewegung, nicht zum Aussehen – das Netzwerk sieht bereits, wie die Person aussieht, es muss nur wissen, was sie tun soll.
Häufige Fragen
Muss ich eine Aufforderung mit meinem Foto schreiben?
Nein. Lassen Sie das Feld leer und das Modell führt von selbst eine natürliche Bewegung aus. Ein Prompt lohnt sich, wenn Sie etwas Bestimmtes wünschen – eine bestimmte Geste, eine Kamerabewegung, eine Stimmung –, denn ein einziger klarer Satz steuert das Ergebnis spürbar.
Welchen Sinn hat es, ein zweites Bild hochzuladen?
Zwei Bilder definieren den Anfang und das Ende des Clips, und die KI baut die Reise zwischen ihnen auf. Dies ist die zuverlässigste Möglichkeit, das Ende eines Videos zu steuern, und ermöglicht außerdem einen größeren Zeitbereich von 3 bis 10 Sekunden.
Das Gesicht verzog sich während der Bewegung – wie kann ich das beheben?
Verwenden Sie ein schärferes, näher beschnittenes Quellfoto und bitten Sie um ruhigere Bewegungen; Schnelle Kopfdrehungen sind die übliche Ursache. Es hilft auch, den gleichen Job noch einmal auszuführen, da jede Generation eine etwas andere Einstellung erzeugt.