Sprachausgabe Gemini TTS: 30 Stimmen und alle Einstellungen
Im Abschnitt "Audio" ein neues Tool ist erschienen - Sprachausgabe von Dialogen Gemini TTS. Es verwandelt das fertige Skript in Klang: Sie geben die Sprecher, ihre Stimmen und ihren Charakter an, und der Dienst spricht die Zeilen nacheinander aus und gibt das fertige MP3 zurück.
Was ist das für ein Instrument
Dabei wird nicht ein einzelner Text, sondern ein vollständiger Text vorgelesen Dialog mit mehreren Sprechern. Jeder Charakter erhält seine eigene Stimme, seinen eigenen Akzent, seinen eigenen Präsentationsstil und sein eigenes Tempo – und die Zeilen klingen so, wie sie beabsichtigt waren: ein Gespräch zwischen den Moderatoren, ein Sketch, ein Interview, Zeilen der Charaktere für das Video.
Zwei Modelle verfügbar:
- Gemini 3.8 Flash TTS — Ausdrucksstarke Sprachausgabe: reichere Emotionen, natürlicherer Rhythmus, feinere Kontrolle der Übermittlung. Geeignet für Podcasts, Hörbücher, Voice-Overs.
- Gemini 3.8 Flash-Lite TTS — Die gleichen Mechaniken sind günstiger und schneller: für große Volumina, Entwürfe und das Vorlesen von Texten.
Welche Einstellungen sind verfügbar?
Die Schnittstelle zeigt alle vom Sprachausgabemodell bereitgestellten Parameter an:
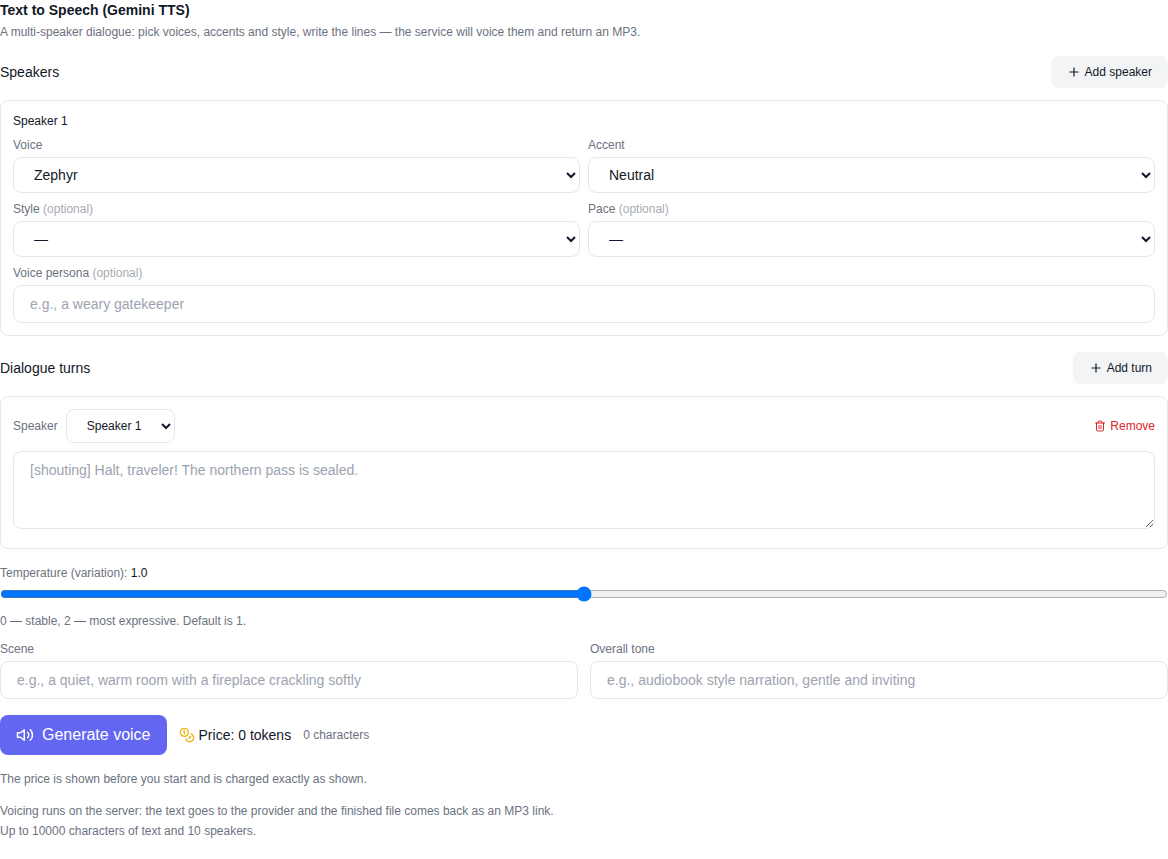
- Sprecher. Von einem bis mehreren Charakteren; Jedes hat seine eigene Signatur „Speaker 1“, „Speaker 2“ usw., durch die die Repliken der Stimme zugeordnet werden.
- 30 Stimmen - von sanfter Erzählung bis hin zu energischen und „Neuigkeiten“.
- 8 Akzente - neutral, amerikanisch (allgemein, „Tal“, südlich), britisch (RP und Brixton), transatlantisch, australisch.
- 6 Servierarten – ein Lächeln in der Stimme, ein Ansager, ein Flüstern, Empathie, Werbung und ein „trockener“, gleichmäßiger Ton.
- 4 Sprechgeschwindigkeiten - natürlich, prasselnd, sanfter „Drift“ und ruckartig.
- Stimmcharakter - freie Beschreibung, z. B. „herzlicher Geschichtenerzähler“ oder „strenger Pförtner“.
- Temperatur - von 0 bis 2: niedriger – stabiler und vorhersehbarer, höher – lebendiger und abwechslungsreicher.
- Szene und allgemeiner Ton - eine Beschreibung der Umgebung („ein ruhiger Raum mit knisterndem Kamin“) und des Erzählstils („ein Hörbuch, sanft und einladend“).
- Repliken — jede Dialogzeile bis zu 10.000 Zeichen; Die Reihenfolge der Replikate bleibt erhalten.
So sprechen Sie einen Dialog aus: Schritt für Schritt
- Offen Abschnitt „Audio“. und wählen Sie ein Modell aus Gemini 3.8 Flash TTS oder Flash-LiteTTS - Sie stehen am Ende der Modellliste.
- Fügen Sie Sprecher hinzu und passen Sie die Stimme, den Akzent, den Stil und das Tempo jeder Person an.
- Schreiben Sie die Dialogzeilen auf und identifizieren Sie jeweils den Sprecher.
- Geben Sie bei Bedarf die Szenenbeschreibung, den Gesamtton und die Temperatur ein.
- Schauen Sie sich den Preis an – er ist VOR dem Start sichtbar und wird während der Texteingabe neu berechnet.
- Klicken Sie auf „Voice“ und wenn Sie fertig sind, hören Sie sich das Ergebnis an und laden Sie MP3 herunter.
Wie viel kostet es
Der Preis wird auf der Grundlage des tatsächlichen Textvolumens berechnet: Je länger die Repliken, desto höher die Kosten, und es ist vor der Veröffentlichung sichtbar – es gibt keine Überraschungen nach der Generierung. Die Bezahlung erfolgt wie bei anderen bezahlten Generationen über Site-Tokens; Wenn dies nicht gelingt, werden die Token automatisch zurückgegeben. Der Preisführer kann direkt im Formular eingesehen werden: Der Betrag wird aktualisiert, während Sie das Skript eingeben.
Häufig gestellte Fragen
Kann ich Dialoge zwischen zwei oder mehr Charakteren als Synchronsprecher verwenden? Ja, jeder Sprecher hat seine eigene Stimme und Einstellungen, die Leitungen wechseln sich ab.
In welchem Format liegt das Ergebnis vor? MP3 – Sie können es auf der Seite anhören und mit einem Knopfdruck herunterladen.
Welche Sprachen spricht das Model? Das Modell ist mehrsprachig: Es spricht Texte in Dutzenden Sprachen, darunter Russisch und Englisch.
Was soll man wählen: Flash oder Flash-Lite? Für ausdrucksstarke Projekte – Flash, für große Volumina und Entwürfe – Flash-Lite: Die Mechanik ist die gleiche, aber günstiger und schneller.
Muss ich bezahlen, um es auszuprobieren? Die Abschreibung erfolgt, wenn die Sprachausgabe beginnt, und wenn ein Fehler auftritt, werden die Token automatisch zurückgegeben.