DeepSeek V4 Pro 0813 er et historisk vendepunkt
Kort om det vigtigste (BLUF)
DeepSeek udgav den endelige version V4 Pro - revision 0813: opdateringen ankom automatisk via API'et uden præsentationer eller referencer. Vi ser på, hvad der præcist er steget ved hjælp af benchmarks, beregner ærligt forskellen med Claude og GPT og forklarer, hvorfor prisen ikke har ændret sig endnu.
I dag udrullede DeepSeek den endelige version V4 Pro - revision 0813. Ingen konferencer eller nedtællingstællere: har lige opdateret API'en. De, der allerede har arbejdet med `deepseek-v4-pro`, modtog automatisk en ny model uden at ændre noget i koden. Den april var en forpremiere, denne er GA, og forskellen er primært mærkbar, hvor modellen forventes ikke at svare i en chat, men at fungere sammenhængende.

I dag er dagen, hvor kodning på Opus-niveau blev virkelig tilgængelig.Dette forslag ville have været en marketingmedarbejders drøm om morgenen, og om aftenen ville det have været en kendsgerning med benchmarks at starte.
I NeuralSpace står modellen allerede:i chatten, V "Kode" sektionog indAPI. Der er ingen "vente på, at den ruller ud" - du åbner den og bruger den.
Hvilken model
Teknisk set er dette det samme udyr som i april: Blanding af eksperter med 1,6 billioner parametre, hvoraf 49 milliarder er aktive på hvert trin. Konteksten er en million tokens, og modellen er i stand til at producere op til 384 tusind tokens i ét svar. Til sammenligning: dette er omkring tyve gange mere end de fleste modeller i de tilstødende faner.
Modellen kan tænke på to måder - tænkende og ikke-tænke, og ræsonnement_indsats har nu tre niveauer: max, høj, lav. I praksis betyder det, at et lille problem kan løses billigt, og en kompleks kæde kan løses med maksimal omtanke, uden at modellen ændres.
Benchmarks: hvad der præcist er vokset
Kunstig analyse genmålte den endelige version. Intelligence Index steg fra 43,7 til 45,3. Kodningsindeks - fra 58,7 til 59,4. Men Agentic Index sprang mest: fra 35,3 til 37,8. Dette er ikke et uheld - revision 0813 blev rettet specifikt til agent-baserede scenarier, hvor modellen ikke reagerer på én gang, men går frem og tilbage: læser filer, kalder værktøjer, ser på resultatet og retter sig selv.
Med hensyn til hastighed er alt på niveau med den tidligere version: omkring 76 tokens i sekundet ved udgangen, det første token ankommer på omkring halvandet til to sekunder. Det er hurtigt for en model af denne størrelse. Ærlig ulempe: modellen er snakkesalig. Ved AA-målinger sprøjter den halvanden til to gange flere tokens ud end markedsgennemsnittet – overvej, at du for detaljeret begrundelse betaler med både ekstra tokens og ekstra sekunders ventetid.
Mod Claude og GPT: fair aritmetik
Det mest bemærkelsesværdige i den seneste tabel er linjen med Claude Opus 4.8, Anthropics tidligere flagskib. DeepSeek V4 Pro 0813 slog det i kodningsbenchmarks på begge sider: Terminal-Bench 2.1 - 87.9 versus 85.0, DeepSWE - 62.7 versus 58.0. Samtidig koster Opus 4.8 $5 per million input-tokens og $25 per million output-tokens - 11 og 29 gange dyrere. Her er tabellen:
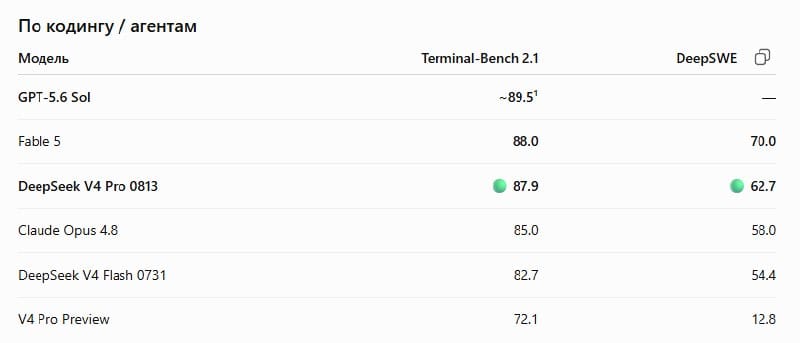
Den endelige version kom tættest på Claude Fable 5: 87.9 versus 88.0 i Terminal-Bench - en tiendedel forskel. Ifølge DeepSWE er Fable mere mærkbart foran: 70,0 mod 62,7. Hvis man tæller alle ti agent-baserede benchmarks fra tabellen DeepSeek, er Fable i gennemsnit foran med 5,3 % – men på to ud af ti DeepSeek-sejre, og uden den eneste outlier (Humanity's Last Exam uden værktøjer: 42,7 vs 53,3) skrumper den gennemsnitlige forspring til 2,8 %.
Prisen afviger ikke med procent, men flere gange. Fabel 5 koster $10 per million input og $50 per million output tokens; V4 Pro har $0,435 og $0,87. Med den blandede hastighed fungerer det til omkring $30 versus $0,65. Det vil sige, at for en forskel på nogle få procent i test, beder Anthropic om at betale cirka 46 gange mere. Ærlighedsforbehold: Jeg målte selv sammenligningstabellen DeepSeek, på min egen upublicerede infrastruktur, to ud af ti tests er interne, og der er ingen uafhængige målinger af 0813 endnu - modellen blev først udgivet i dag.
For at forstå skalaen, tænk på Kimi K3. For en måned siden var hun den første kinesiske model, der overhalede Claude Opus – det var en sensation. Men Kimi K3 er en model med billioner af parametre, den kræver en dyr server at køre, så i detailhandlen er den kun tre gange billigere end Claude Fable og kun 40% billigere end Claude Opus. Imponerende, men der er ingen demokratisering i dette.
Men DeepSeek V4 Pro er et virkelig historisk øjeblik. Virkelig indhente Opus med hensyn til kodning, det koster 30 gange mindre end Opus og 60 gange mindre end Fable. I dag er vibecoding blevet tilgængelig for alle - ikke i reklameforstanden "tilgængelig", men til prisen for adgang til det.
Med GPT er situationen mere kompliceret. GPT-5.5 scorer 56,3 i Artificial Analysis-indekset versus 45,3 for DeepSeek - kløften er ærlig talt mærkbar. Men taksterne er ikke sammenlignelige: $5/$30 per million versus $0,435/$0,87. Men den billigere GPT-5.6 Luna koster allerede $0,10/$0,60 - altså billigere end DeepSeek - og scorer 52,3. Det viser sig, at den "billigste af de store" ikke længere er den eneste: Til en pris på V4 Pro konkurrerer den med Luna, og pointmæssigt taber den til både Terra og Sol.
Jeg vil tilføje et nøgternt citat udefra: en nylig vurdering af den amerikanske NIST (CAISI) sagde, at V4 Pro halter bagefter markedslederne med omkring otte måneder. Sandt nok målte de en forhåndsvisningsversion. Hvorvidt 0813 har indsnævret dette hul, vil blive vist af uafhængige benchmarks, men de eksisterer ikke endnu.
Prisen har ikke ændret sig. Farvel
Indgang – $0,435 per million tokens, exit – $0,87. Cash hit er stadig næsten gratis: $0,003625 per million, 120 gange billigere end almindelig adgang. For agentkæder er dette hovedpointen: Projektkonteksten læses igen og igen, og det er cachen, der afgør, hvor meget en times agentarbejde koster.
En advarsel: DeepSeek har allerede advaret i dokumentationen om, at det vil hæve priserne for sin API som helhed. Hvornår og hvor længe er ikke sagt. April-taksterne er stadig i kraft, og det er mærkbart lavere end vestlige analoger af en sammenlignelig klasse.
Hvor kan man prøve det lige nu
- Snak:åbenmodel side— den sidste 0813 er allerede standard.
- Kode: V "Kode" sektionmodellen forbinder til projektet og arbejder med repository, filer og terminal.
- API:nøglen udleveres i afsnittetAPI-nøgler NeuralSpace, format kompatibelt med OpenAI.
Betaling - i rubler fra den generelle saldo, uden abonnement, VPN eller udenlandsk kort. Faktisk brug afskrives, ikke pakken "måned i forvejen".
Hvad modellen ikke kan er at se på billeder: input er kun tekst. Hvis du har brug for analyse af et skærmbillede eller foto, er dette til andre modeller. Men til tekst, kode og lange agentopgaver er den endelige V4 Pro nu et af de mest ærlige forslag med hensyn til kraft og prisforhold.Du kan tjekke det i chatten, og hvis du har brug for at bygge det ind i dit produkt -nøglen er taget fra siden med API-nøgler.
Ofte stillede spørgsmål (FAQ)
Spørgsmål: Hvordan kommer man i gang?Svar: Tilmeld dig på platformen og modtag gratis tokens til test.
Spørgsmål: Er de genererede materialer egnede til kommerciel brug?Svar: Ja, du modtager fulde kommercielle rettigheder til alt indhold, der er oprettet.