DeepSeek V4 Pro 0813 - dette er et historisk vendepunkt
Den korte version (BLUF)
DeepSeek har afsendt den endelige V4 Pro-build — revision 0813 — og alle eksisterende deepseek-v4-pro-brugere fik den automatisk gennem API'et, ingen lanceringsbegivenhed vedhæftet. Benchmarks rykkede tættere på Claude og GPTs territorium, mens prisen forbliver uændret indtil videre. Nedenfor: hvad der præcist forbedrede, ærlige regnestykker i forhold til konkurrenterne, og hvor man kan prøve det.
I dag sendte DeepSeek den endelige version af V4 Pro — revision 0813. Ingen lanceringsbegivenhed og ingen nedtælling: API'en blev simpelthen opdateret. Enhver, der allerede arbejder med deepseek-v4-pro, fik den nye model automatisk uden kodeændringer. April-bygningen var en forsmag; denne er GA-udgivelsen, og forskellen viser tydeligst, hvor en model forventes at udføre vedvarende arbejde i stedet for at besvare en chatbesked.

Dette er dagen, hvor kodning på Opus-niveau virkelig blev overkommelig.Den sætning ville have været markedsføringsønske her til morgen; om aftenen er det en kendsgerning med vedhæftede benchmarks.
Modellen er allerede live på NeuralSpace:i chatten, iKode afsnitog iAPI. Ingen "venter på udrulning" - bare åbn den og brug den.
Hvad er modellen
Teknisk set er det det samme udyr som i april: en blanding af eksperter med 1,6 billioner parametre, 49 milliarder af dem aktive på ethvert trin. Kontekst er en million tokens, og modellen kan udsende op til 384 tusind tokens i et enkelt svar. Til sammenligning er det cirka tyve gange mere end de fleste modeller i de tilstødende faner.
Modellen kan tænke på to måder - tænkende og ikke-tænke - og ræsonnement_indsats har nu tre trin: max, høj, lav. I praksis kan et lille spørgsmål køres billigt, mens en kompleks kæde kan håndteres med maksimal ræsonnement uden at skifte model.
Benchmarks: hvad der rent faktisk blev forbedret
Kunstig analyse genmålte den endelige version. Intelligence Index steg fra 43,7 til 45,3. Coding Index gik fra 58,7 til 59,4. Men Agentic Index sprang mest: fra 35,3 til 37,8. Det er ikke en tilfældighed - revision 0813 blev indstillet specifikt til agentscenarier, hvor en model ikke svarer i ét skud, men går frem og tilbage: læser filer, kalder værktøjer, inspicerer resultatet og retter sig selv.
Hastigheden er omtrent den samme som den tidligere version: omkring 76 tokens i sekundet ved output, første token på omkring halvandet til to sekunder. Det er hurtigt for en model i denne størrelse. Den ærlige ulempe: modellen er udførlig. På AA-målinger udsender den halvanden til to gange flere tokens end markedsgennemsnittet - regn med at betale for ekstra tokens og ekstra sekunders ventetid, når det ræsonnerer længe.
Mod Claude og GPT: ærlig aritmetik
Den mest slående række i den friske tabel er Claude Opus 4.8, Anthropics tidligere flagskib. DeepSeek V4 Pro 0813 slog det i kodningsbenchmarks på begge sider: Terminal-Bench 2.1 — 87.9 versus 85.0, DeepSWE — 62.7 versus 58.0. Og Opus 4.8 koster $5 per million input-tokens og $25 per million output-tokens - 11 og 29 gange mere. Her er tabellen:
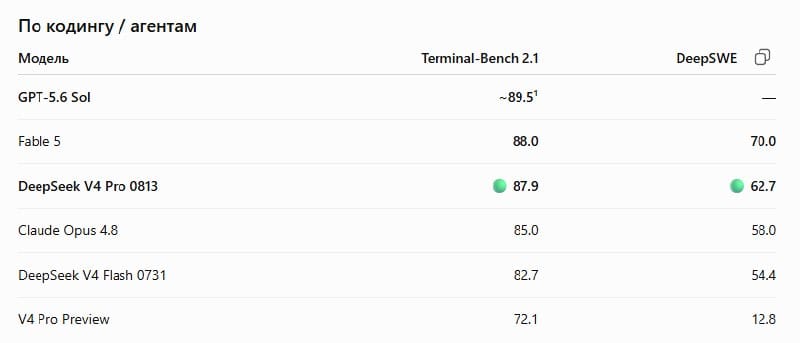
Den endelige version kom tættest på Claude Fable 5: 87,9 mod 88,0 i Terminal-Bench - en forskel på en tiendedel af et point. I DeepSWE er Fable længere fremme: 70,0 mod 62,7. Med et gennemsnit af alle ti agentiske benchmarks fra DeepSeeks tabel fører Fable med 5,3 % i gennemsnit - men DeepSeek vinder på to ud af ti, og uden den enkelte outlier (Humanity's Last Exam uden værktøjer: 42,7 versus 53,3) skrumper den gennemsnitlige forskel til 2,8 %.
Prisen afviger i mellemtiden ikke med procentpoint, men i størrelsesordener. Fabel 5 koster $10 per million input og $50 per million output tokens; V4 Pro koster $0,435 og $0,87. Til en blandet kurs, der er omkring $30 versus $0,65. Så for en forskel på nogle få procentpoint på test, beder Anthropic om cirka 46 gange flere penge. Ærlighedshenvisninger: DeepSeek målte sin egen sammenligningstabel på sin egen upublicerede infrastruktur, to af de ti tests er interne, og der er endnu ingen uafhængige målinger af 0813 - modellen udkom i dag.
For skala, husk Kimi K3. For en måned siden blev det den første kinesiske model, der slog Claude Opus - det var en sensation. Men Kimi K3 er en trillion-parameter model, der har brug for en dyr server for at køre, så i detailhandlen er den kun tre gange billigere end Claude Fable og kun 40 % billigere end Claude Opus. Imponerende, men ikke ligefrem demokratisering.
DeepSeek V4 Pro er et ægte historisk øjeblik. Når man virkelig nærmer sig Opus i kodning, koster det 30 gange mindre end Opus og 60 gange mindre end Fable. Vibe-kodning er lige blevet tilgængelig for alle - ikke i reklameforstanden "tilgængelig", men til prisen for entré.
Med GPT er billedet mere nuanceret. GPT-5.5 scorer 56,3 på Artificial Analysis-indekset mod 45,3 for DeepSeek - et helt ærligt mærkbart hul. Men satserne er uforlignelige: $5/$30 pr. million versus $0,435/$0,87. Den billigere GPT-5.6 Luna koster dog $0,10/$0,60 - mindre end DeepSeek - og scorer 52,3. Så "den billigste af de store" er ikke længere unik: På prisen konkurrerer V4 Pro med Luna, mens den på score taber til både Terra og Sol.
Tilføj et nøgternt citat udefra: i en nylig vurdering fra US NIST (CAISI) blev V4 Pro sagt at være bagud efter markedslederne med omkring otte måneder. De målte dog preview-versionen. Hvorvidt 0813 indsnævrede dette hul, forbliver for uafhængige benchmarks - og der er ingen endnu.
Prisen ændrede sig ikke. For nu
Input er $0,435 per million tokens, output er $0,87. Cache-hits er stadig næsten gratis: $0,003625 pr. million, 120 gange billigere end et normalt input. For agentkæder er dette hovedpointen: projektkontekst genlæses igen og igen, og det er cachen, der bestemmer, hvor meget en times agentarbejde koster.
En advarsel: DeepSeek har allerede advaret i sine dokumenter om, at de planlægger at hæve API-priser generelt. Hvornår og hvor meget - ikke sagt. Priserne for april gælder stadig indtil videre, og de er mærkbart lavere end sammenlignelige vestlige modeller.
Hvor kan man prøve det lige nu
- Snak:åbnemodel side— den sidste 0813 er allerede standard.
- Kode:iKode afsnitmodellen forbinder til et projekt og arbejder med et depot, filer og en terminal.
- API:nøglen udleveres iNeuralSpace API nøgler, OpenAI-kompatibelt format.
Betaling er i rubler fra én delt saldo, uden abonnement, uden VPN og uden udenlandsk kort. Du bliver opkrævet for faktisk brug, ikke en "måned frem"-pakke.
Hvad modellen ikke kan, er at se på billeder: input er kun tekst. Hvis du har brug for at dissekere et skærmbillede eller et foto, er det for andre modeller. Men til tekst, kode og lange agentopgaver er den endelige V4 Pro en af de mest ærlige styrke-til-pris-aftaler, der findes.Prøv det i chatten, ellertag en nøgle på API-nøglersidenat bygge det ind i dit produkt.
Ofte stillede spørgsmål (FAQ)
Q: Hvordan kommer jeg i gang?
A: Tilmeld dig på platformen og få gratis tokens til test.
Q: Kan jeg bruge genereret indhold kommercielt?
A: Ja, du får fulde kommercielle rettigheder til alt, hvad du skaber.