趋势:韩国比赛看台上的女孩 - 她们是如何做到的
简单说一下主要的事情(BLUF)
韩国比赛看台上的女孩是一种吸引了数百万观看次数的趋势:镜头在球迷中找到了女主角,但她似乎没有注意到拍摄。让我们看一下两个模板 - 照片和视频,它的幕后工作原理以及趋势突破的地方。
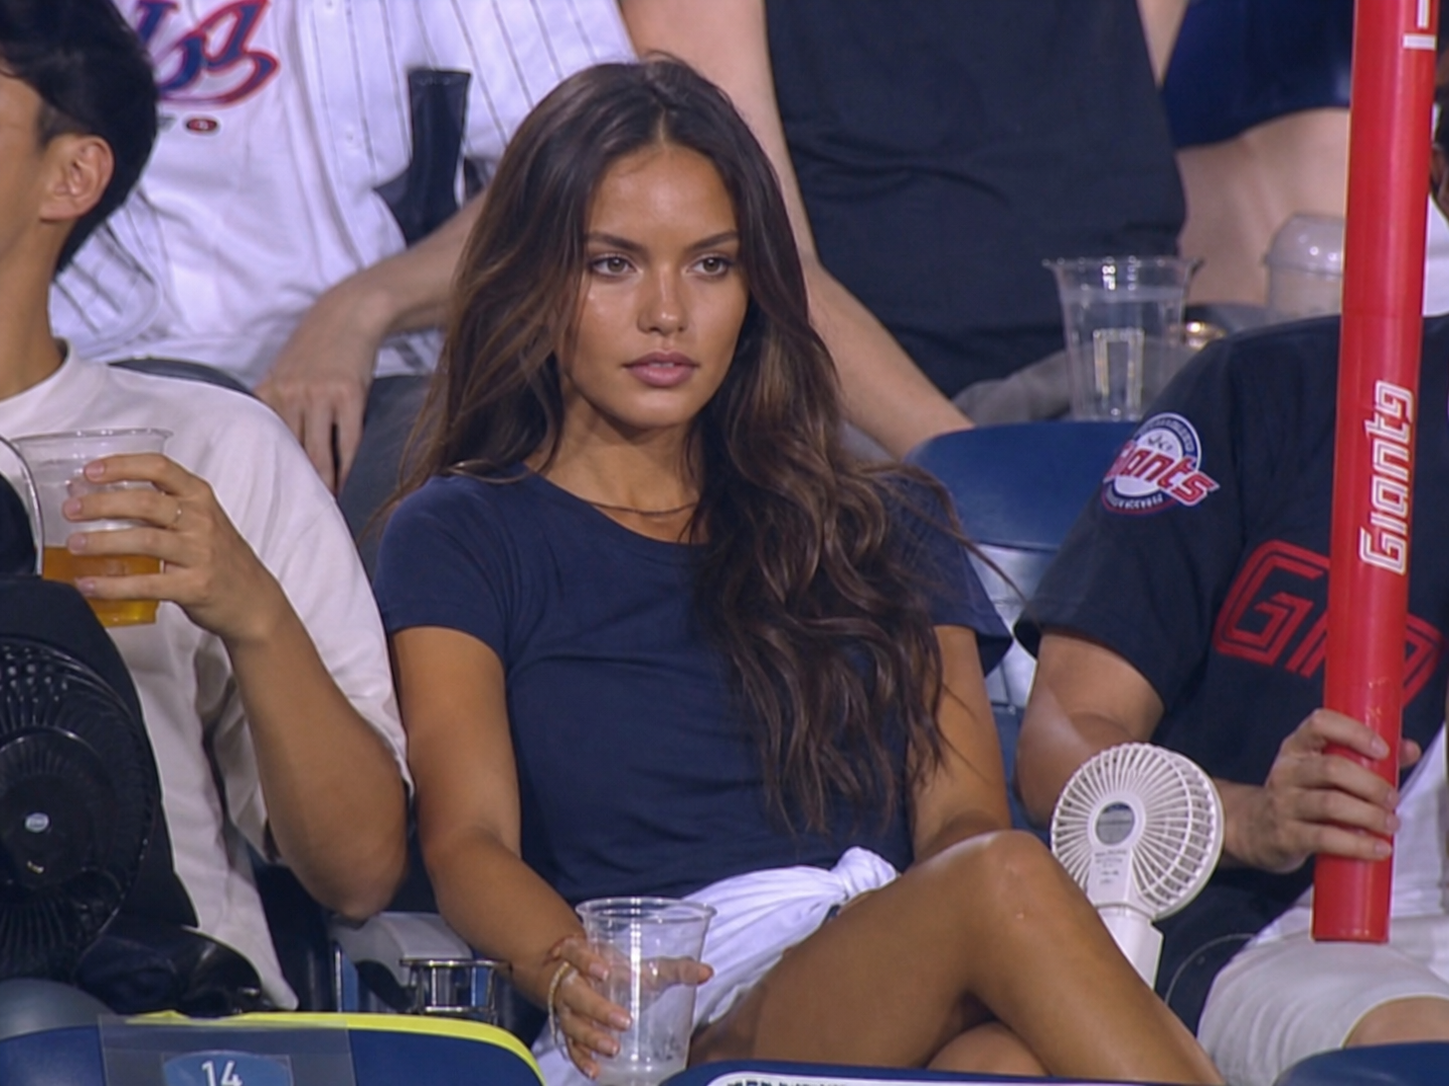
仔细观察这些导轨中的任何一个。韩国电视频道,SPOTV 标志,记分牌与局数。镜头看着讲台——女孩坐着,没有看镜头,而是看着球场的某个地方。 5秒。全部。
该视频的观看次数已达一百万。在评论中:“你从哪里得到这个视频”,“你真的在韩国吗”,“这是神经网络还是实时网络”。而大多数人都想不通。原因如下。
两个模板:照片和视频
“讲台上的女孩——照片。” 他拍了一张你的脸的照片,然后以 SPOTV 广播的风格从头开始拼凑出一个框架:看台、体育场灯光、背景中典型的韩国球迷、你手里的塑料玻璃杯、旁边的风扇。没有精美的人工智能外观 - 相反,有压缩噪音、轻微的运动模糊和真实的皮肤。目标是让它看起来像随机捕捉的广播镜头,而不是时装拍摄。底层 - GPT 图片 2。每代 6 个代币。
“讲台上的女孩 - 视频。” 同一张脸,但在运动。您上传一张照片 - Kling 3.0 图像到视频模型制作了一个 5 秒的“体育场现场直播”剪辑:相同的广播摄像机角度、背景中的人群、相同的轻松姿势。标准模式下 50 个代币,专业模式下更多。
它是如何工作的
照片。没有框架,它是从头生成的。但有严格的规则:不能修饰,不能“放大眼睛”,不能有塑料光泽。该请求明确指出:它应该看起来像来自低质量广播摄像机的真实镜头,并具有所有缺点 - 轻微涂抹、数字噪音、汗水眩光。这就是给人一种“真实框架”的感觉,而不是“神经元”的感觉。
视频。 Kling 3.0 图像转视频将您的照片作为第一帧,并根据需要对场景进行动画处理:头部的轻微转动、背景中人群的移动、眨眼、“令人惊讶地专注地注视场地”的面部表情。提示显然需要水平 16:9 帧和广播质量,以便它适合裁剪的 rils 格式,并且看起来不像垂直拉伸的 I2V。
如何手动操作
如果您不想使用该模板:
对于照片。 你要去吗 图片部分,选择 GPT Image 2,附上自拍照作为参考,并用韩语编写请求(模型在韩国电视的背景下更好地理解它):
对于视频。 你要去吗 视频部分,选择Kling 3.0,附上同一张照片(可以先在照片模板中拍),16:9,请求:
也就是说,一个工作管道:首先是一个照片模板(您将获得完美的“广播”帧),然后将此帧放入视频模板中 - 您将获得同一个人在讲台上的 5 秒动画版本。
哪里破裂了
照片。参考自拍照过于清晰明亮——模特试图将其“光泽度”拖入画面中,结果不是广播,而是时装拍摄。没有滤镜的简单自拍效果更好。如果结果太漂亮,就重新生成它,请求中已经包含了所有禁止修饰的内容,但有时模型仍然会被吸引到“影响者”。
视频。 Kling 3.0 提供了头部和背景的良好运动,但如果照片太“工作室”(平坦的白色背景,完美的光线) - 它将这种光线拉入体育场场景,你会得到一个奇怪的混合。人像照片在中等光线下效果最佳,没有硬阴影。
尝试
两个现成的模板 趋势部分。如果您想要为帖子提供静态帧,请使用 GPT Image 2 上的照片卡。如果您想要为卷轴提供 5 秒的视频,请使用 Kling 3.0 上的视频卡。您可以批量完成:首先是一张照片,然后从这张照片开始制作一个视频。
常见问题 (FAQ)
问题:如何从神经网络中获得最佳结果?
答:使用详细的英文提示(描述),设置场景的风格和细节。
问:这些材料可以用于商业用途吗?
答:是的,生成的内容完全属于您。