谁在何时发言(免费):说话人分离和实时字幕
会议、采访或讲座结束后,您会留下几个人谈话的录音,而普通的文字记录无法告诉您谁说了什么。 谁在何时发言 是一个免费的浏览器工具:它将录音分成多个扬声器(最多四个),可以选择将语音转换为带时间戳的对话,其第二个选项卡直接从麦克风运行实时字幕。该文件永远不会上传,不会花费任何代币,也不需要帐户。
它是如何运作的
说话者分离由 NVIDIA Sortformer 模型提供支持:它最多可找到四个说话者,并列出每个说话者听到的时间段。如果您选中“同时转录语音”复选框,则单词会附加到说话者身上 - 您将获得标有“说话者 1”、“说话者 2”等的对话记录,您可以将其复制或下载为 TXT、SRT、VTT 或 JSON。时间线旁边的徽章显示模型找到了多少个发言者。
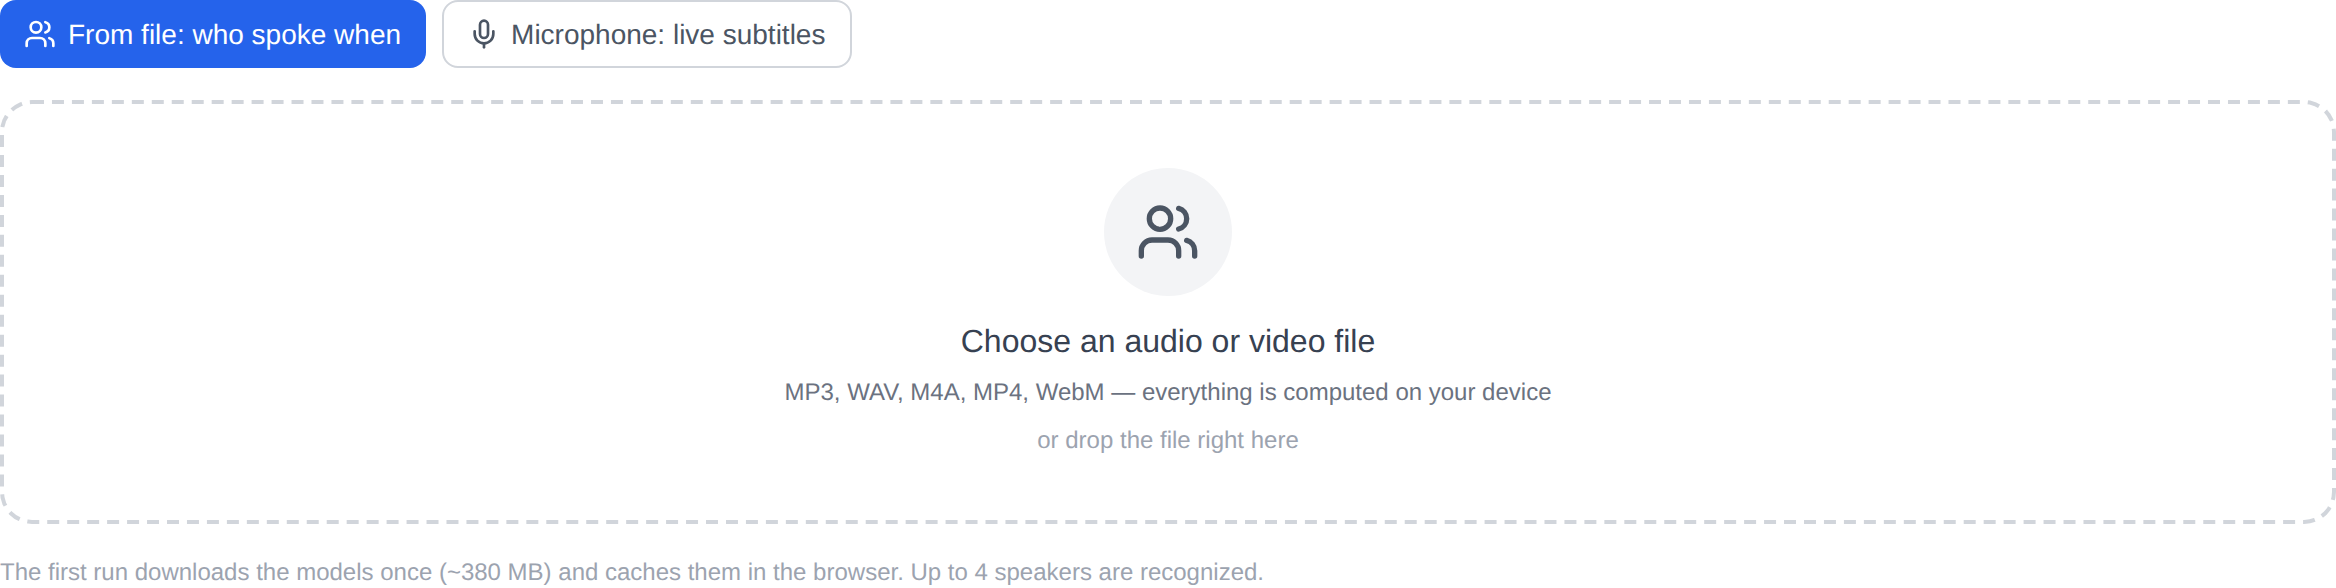
第一次运行会将模型权重下载到您的设备 - 总共约 380 MB。之后,它们会缓存在您的浏览器中,以后运行不需要网络。使用显卡(WebGPU)分析速度很快;如果没有它,引擎会回退到处理器 (WASM) - 速度明显变慢,但结果是相同的,并且该工具会告诉您何时发生这种情况。音频在浏览器内折叠为 16 kHz 单声道;没有什么需要在任何地方记录。
标记您自己的录音
- 打开 工具 并选择一个音频或视频文件:接受MP3、WAV、M4A、MP4和WebM,然后您可以将文件拖放到相框上。
- 选择“同时转录语音”框:选中,它会为您提供带有时间戳的对话;未经检查,只有“谁以及何时发言”的时间线。
- 按开始按钮。第一次运行时,等待模型下载 - 进度条会随时通知您。
- 结果就是时间线加上对话。使用按钮复制文本或以您需要的格式下载。
来自麦克风的实时字幕
第二个选项卡直接从麦克风获取声音,并在您说话时逐个短语为其添加字幕:当前短语显示为大字,完成的短语保留在下面的列表中。它适合会议、讲座或视频通话,此时需要字幕,而不是在处理文件之后。按下按钮即可请求访问麦克风;没有任何内容写入文件,也没有任何内容离开浏览器。
提前了解什么
该工具还很年轻且具有实验性:分离的质量取决于录音。干净的麦克风对话可以自信地分开,而嘈杂、回声不断的录音可能会让对话感到困惑。语音工作也需要内存——计划大约 1 GB 的余量。在处理器路径 (WASM) 上,长时间录制所需的时间明显比在显卡上长。该模型不会学习名称:“Speaker 1”和“Speaker 2”标签应在导出后重命名,以匹配您的会议记录。
谁需要它
记者可以快速找到新声音进入采访的位置。学生可以逐行记录讲座录音:教授讲课的地方和观众提问的地方。播客编辑可以找到长会议中每个人互相交谈的片段并将其剪掉。会议秘书可以制作带有时间码的会议记录草稿,而无需将录音发送到任何地方。
当你需要别的东西时
如果您想要的是纯文本而不是语音细分,请打开 音频和视频→文字。本节的其他工具位于 声音的 页面,下面还有更多免费的本地工具 其他工具。分析是通过开放的FluidAudio库(MIT许可证)完成的:代码和模型位于您的浏览器中,无需绕道其他服务器。